


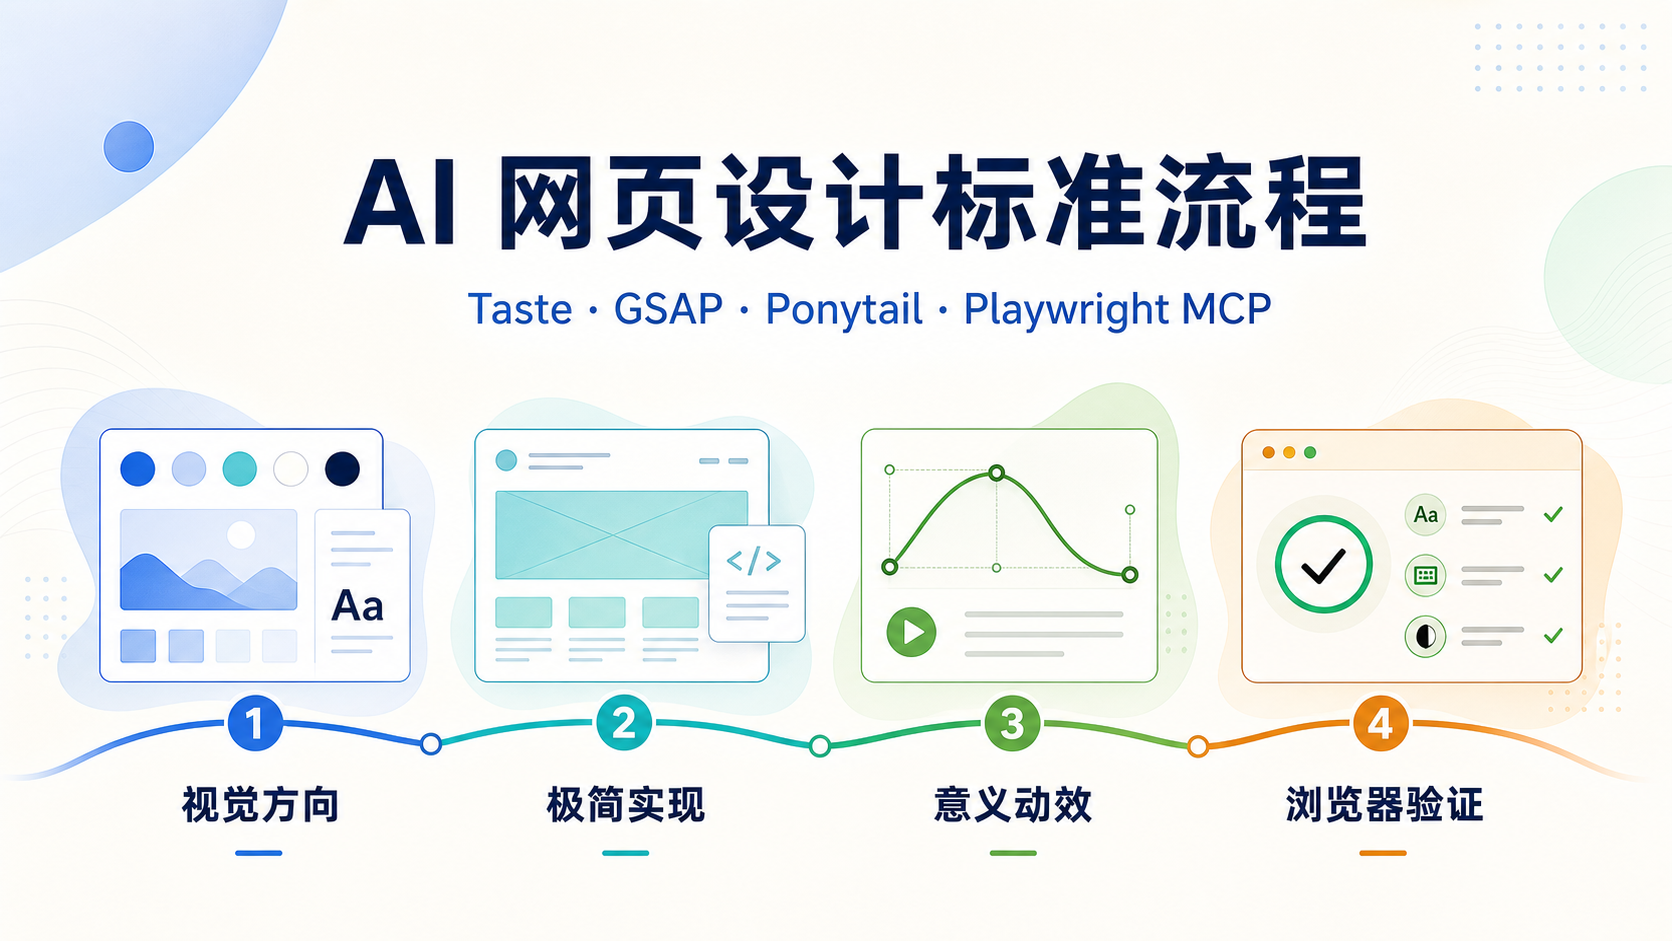
 把 AI 网页设计做成可验证流程:Taste、GSAP、Ponytail 与 Playwright MCP
不要把“去 AI 味”理解成多加组件和动效。本文把 Taste、GSAP、Ponytail 三项 Skills 与 Playwright MCP 串成一条网页设计标准流程:先定视觉,再收敛实现,然后只做有意义的动效,最后用浏览器验证。
精选教程
从项目落地、自动化办公到 AI 原型设计,先看最容易直接上手的内容
把 AI 网页设计做成可验证流程:Taste、GSAP、Ponytail 与 Playwright MCP
不要把“去 AI 味”理解成多加组件和动效。本文把 Taste、GSAP、Ponytail 三项 Skills 与 Playwright MCP 串成一条网页设计标准流程:先定视觉,再收敛实现,然后只做有意义的动效,最后用浏览器验证。
 用 Codex 搭建自媒体运营与网站开发团队:角色、模型与协作流程
一个人运营公众号、短视频和网站时,怎样让 Codex 分别负责选题、内容、开发和审核?本文用一支自媒体运营开发团队举例,列出每个中文岗位的职责、模型、推理强度、交接方式和可复制配置。
 用 AI Agent 做可持续迭代的网页原型:React、SQLite 与项目规范入门
面向刚开始使用编码 Agent 的产品、设计与项目人员:从一个真实长期维护原型的经验和教训出发,用 React、Express 与 SQLite 做出可运行的需求评审台账,并用事实源文档、项目级技能和验证清单约束后续修改。
 让 AI Agent 先读懂代码再动手:CodeGraph 与代码知识图谱实战
从 Token 消耗、调用链和影响范围出发,拆解 CodeGraph 的本地图谱原理,对比 Serena、Graphify 等工具,并以 Windows + Codex 为主线说明跨平台、多 Agent 的安全接入、验证、测量与风险控制流程。
 用 AI Agent 从零生成网页原型:静态 HTML、Vue、React 怎么选,才能少返工、少烧 Token
先分清页面组件化与数据边界两条轴线,再比较静态 HTML、Vue、React、Mock、MSW 与 SQLite 的首次和长期 Token 成本,按原型生命周期选择更少返工的架构。
 ChatGPT / Codex 插件完全指南:每个插件能做什么、怎么用、适合谁
38 个 ChatGPT / Codex 插件怎么选?从 Data Analytics、Product Design、GitHub、Figma 到 Canva 和 ChatCut,本文逐一给出图标、用途、适合人群、连接要求、提示词与职业组合,帮你更快搭好真正适合自己的 Agent 工作流。
 ChatCut + Codex 剪视频教程:从插件安装到完成一次口播粗剪
基于 ChatCut 官方文档与公开插件仓库,讲清 ChatCut 是什么,并用一段自有口播素材演示安全工作流:安装并验证插件、先读素材和转写、确认删减方案、生成字幕、核对时间线,最后经人工批准再导出。
 WEB 原型设计通用组件库 v2.1:AI Agent 时代仍有价值的纯离线 Axure 资源
介绍一套基于 Axure RP 9 的中后台 WEB 原型组件库:它不再是现代 AI Agent 原型开发的首选,却能在国企、政府、涉密、断网和纯内网项目中提供可控、可复用、无需云端服务的离线原型能力。
 Hermes Desktop 教程:安全完成安装、模型接入与首个任务
从 Windows 与 macOS 官方安装开始,完成模型提供商配置、项目目录与权限边界设置,并通过一次可验证的只读任务掌握 Hermes Desktop 的会话、文件与技能管理方法。
 程序员技能专题:用系统化调试、TDD 和完成前验证修复一个真实 Bug
面向开发人员,介绍系统化调试、测试驱动开发、完成前验证与编码纪律如何配合;用一个隔离的 Node.js Bug 保存真实红灯、根因、最小修复和绿灯证据,并附可复制提示词。
AI 前沿
持续跟进 AI 工具、模型能力、开源项目和开发者生态里的关键变化
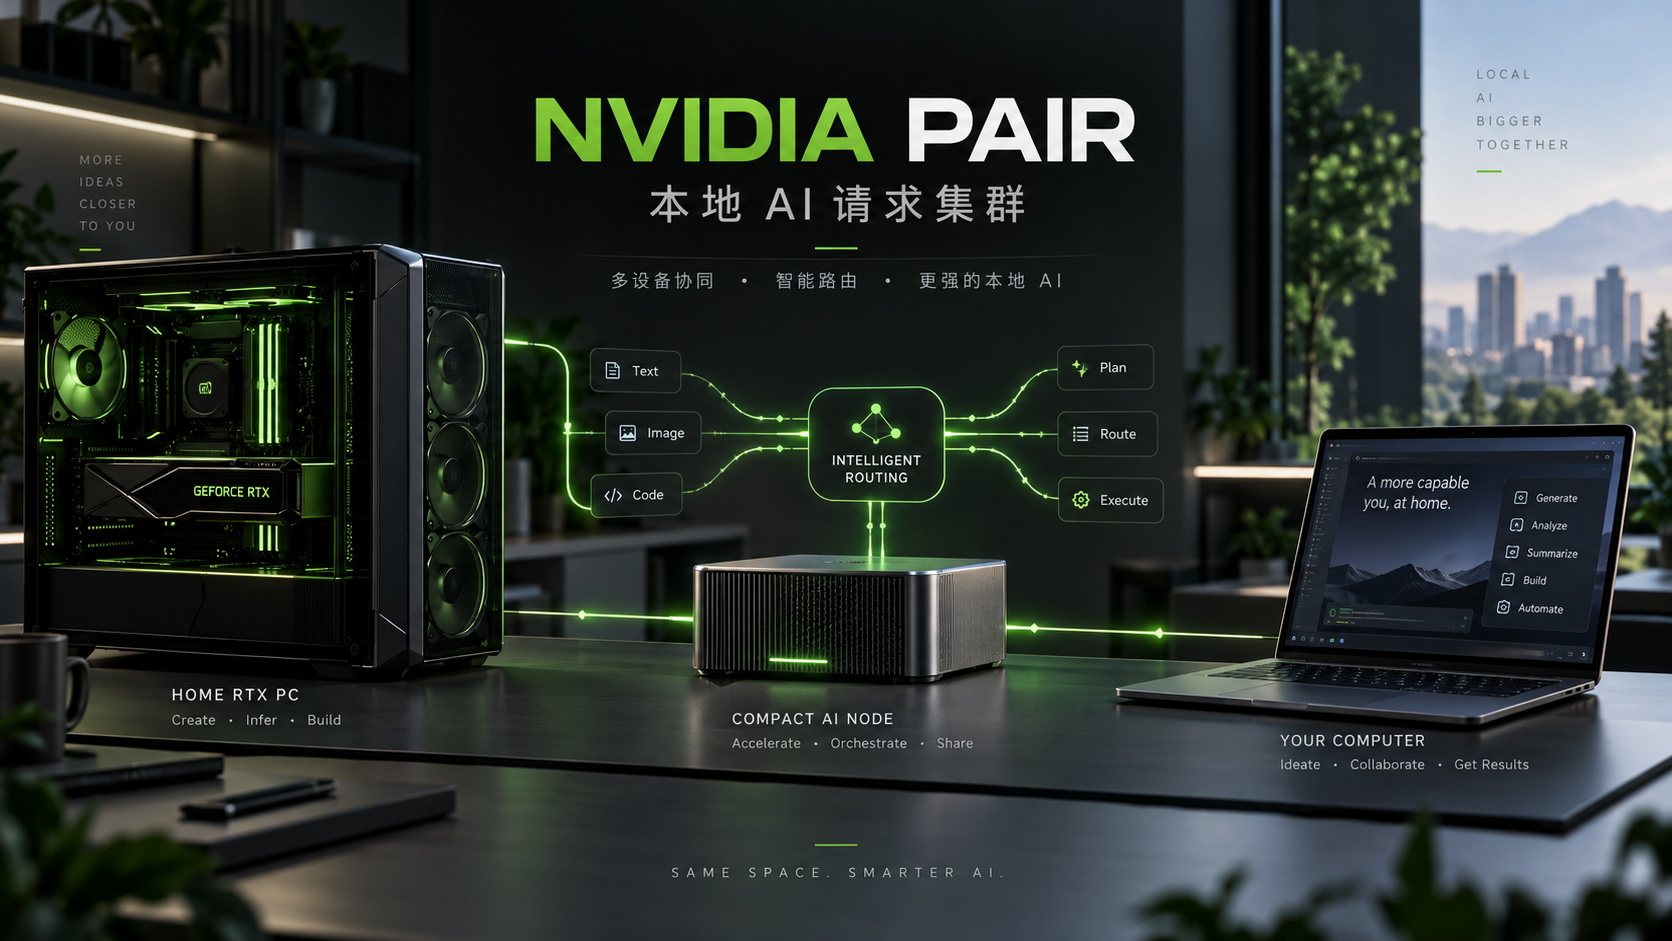 NVIDIA PAIR:把家里的 RTX、DGX Spark 和 Mac 变成本地 AI 请求集群,但它不是“显存池化”
可以把 NVIDIA PAIR 理解成家里本地 AI 的“派单前台”:RTX 主机、DGX Spark、Mac 就像几名能力不同的员工,PAIR 看谁在线、谁装了对应模型、谁现在最空闲,就把下一份 AI 工作交给谁。它特别适合多 Agent 并发,但不会把 16GB + 24GB 显存拼成 40GB,也不会把一个大模型拆到多台机器上。
 GPT-6 Astra 发布:游戏开发、3D 建模与长程 Agent,距离 AGI 通用人工智能还有多远?
2026 年 9 月 3 日,OpenAI 发布 GPT-6 Astra,强化电脑操作、专业制作与长程任务能力。先看本次发布的核心升级,再结合游戏开发、Blender 房屋、Playco 与 ARC Prize 评估,理解它在 AGI 通用人工智能方向的进展和仍待验证的问题。
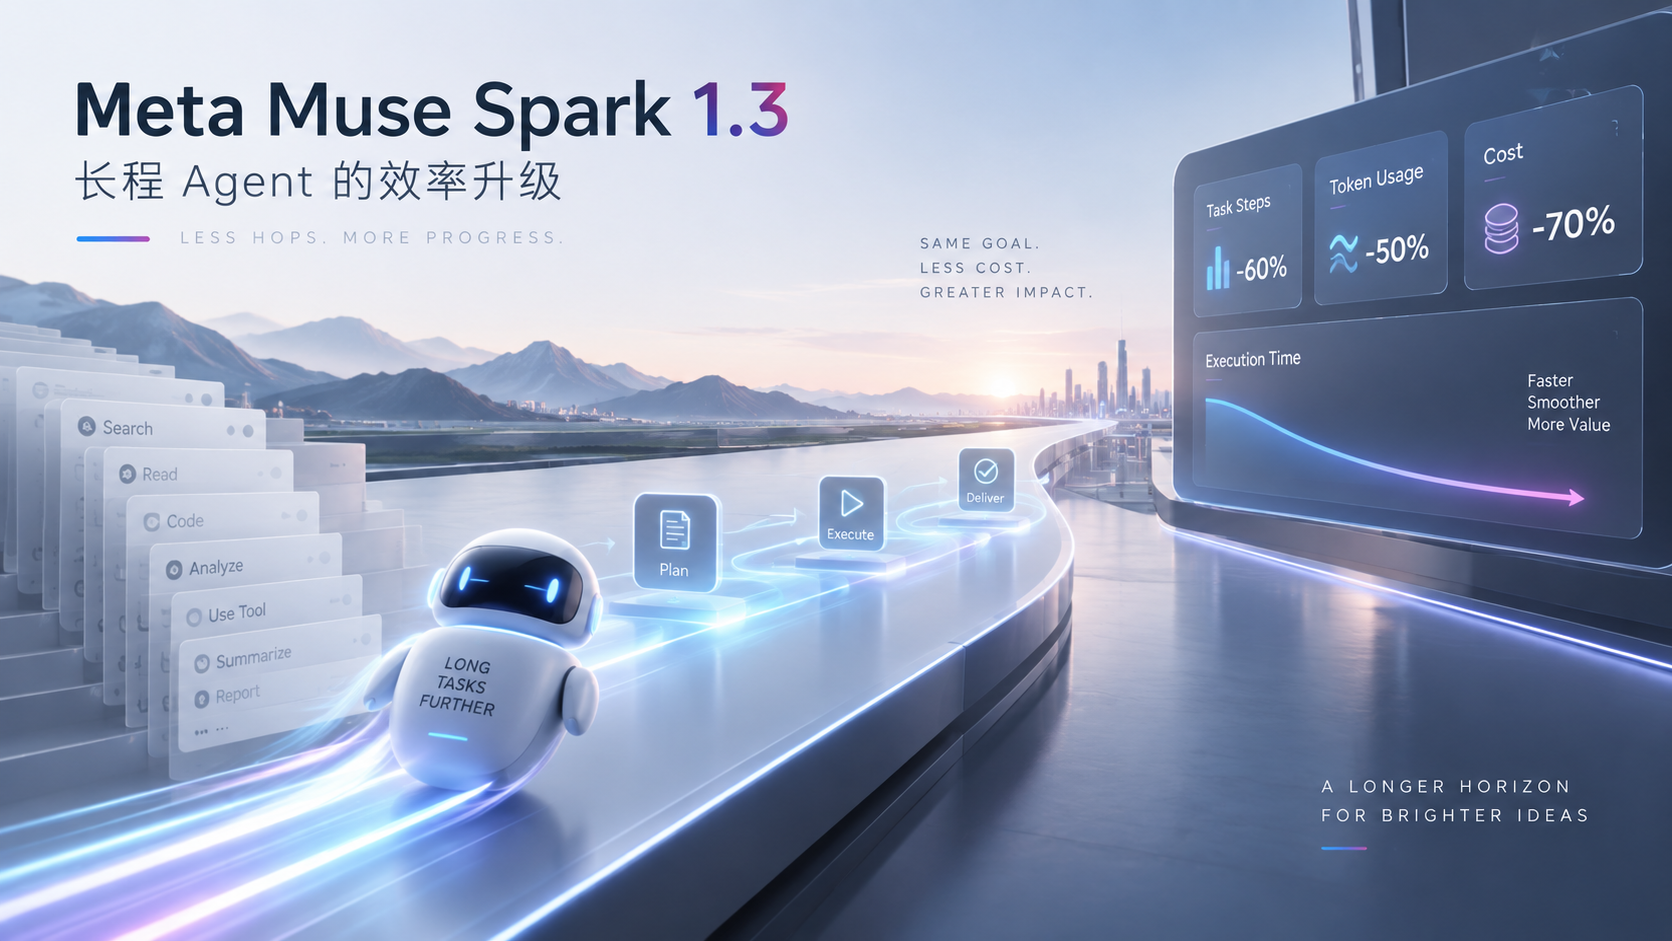 Meta Muse Spark 1.3:工具调用少 20%、Token 少 25%,长程 Agent 的“效率”开始不能只看 Token 单价
Meta 发布 Muse Spark 1.3,把长程 Agent 的重点从“会不会调用工具”推进到“是否知道何时澄清、何时求助、何时确认、何时少走无效轮次”。Meta 工程师内部对比称工具调用减少约 20%、Token 减少约 25%,但第三方评测提醒:这些节省不能直接外推到所有任务。
 Qwen3.8-Max-0902:不是换架构,而是继续 Post-training,发布时 Code Arena 从 1669 升到 1691
Qwen3.8-Max-0902 是 Qwen3.8-Max 的日期快照升级,不是一次新架构发布。阿里云官方文档把重点放在工程级 Coding、长程自主开发、多工具协作与端到端交付;发布时 Code Arena WebDev 从 1669 升到 1691,但实时榜单随后已经变化。
 Gemini 3.8 Flash 与 Flash Cyber:Google 把通用 Agent 和高权限安全能力拆成两条发布轨道
Google 同时发布 Gemini 3.8 Flash 与 Flash Cyber:前者已经 GA,面向长程软件工程和自主 Agent;后者共享基础智能,却通过 Fairwind Program 只向可信防御方开放更宽松的网络安全能力。
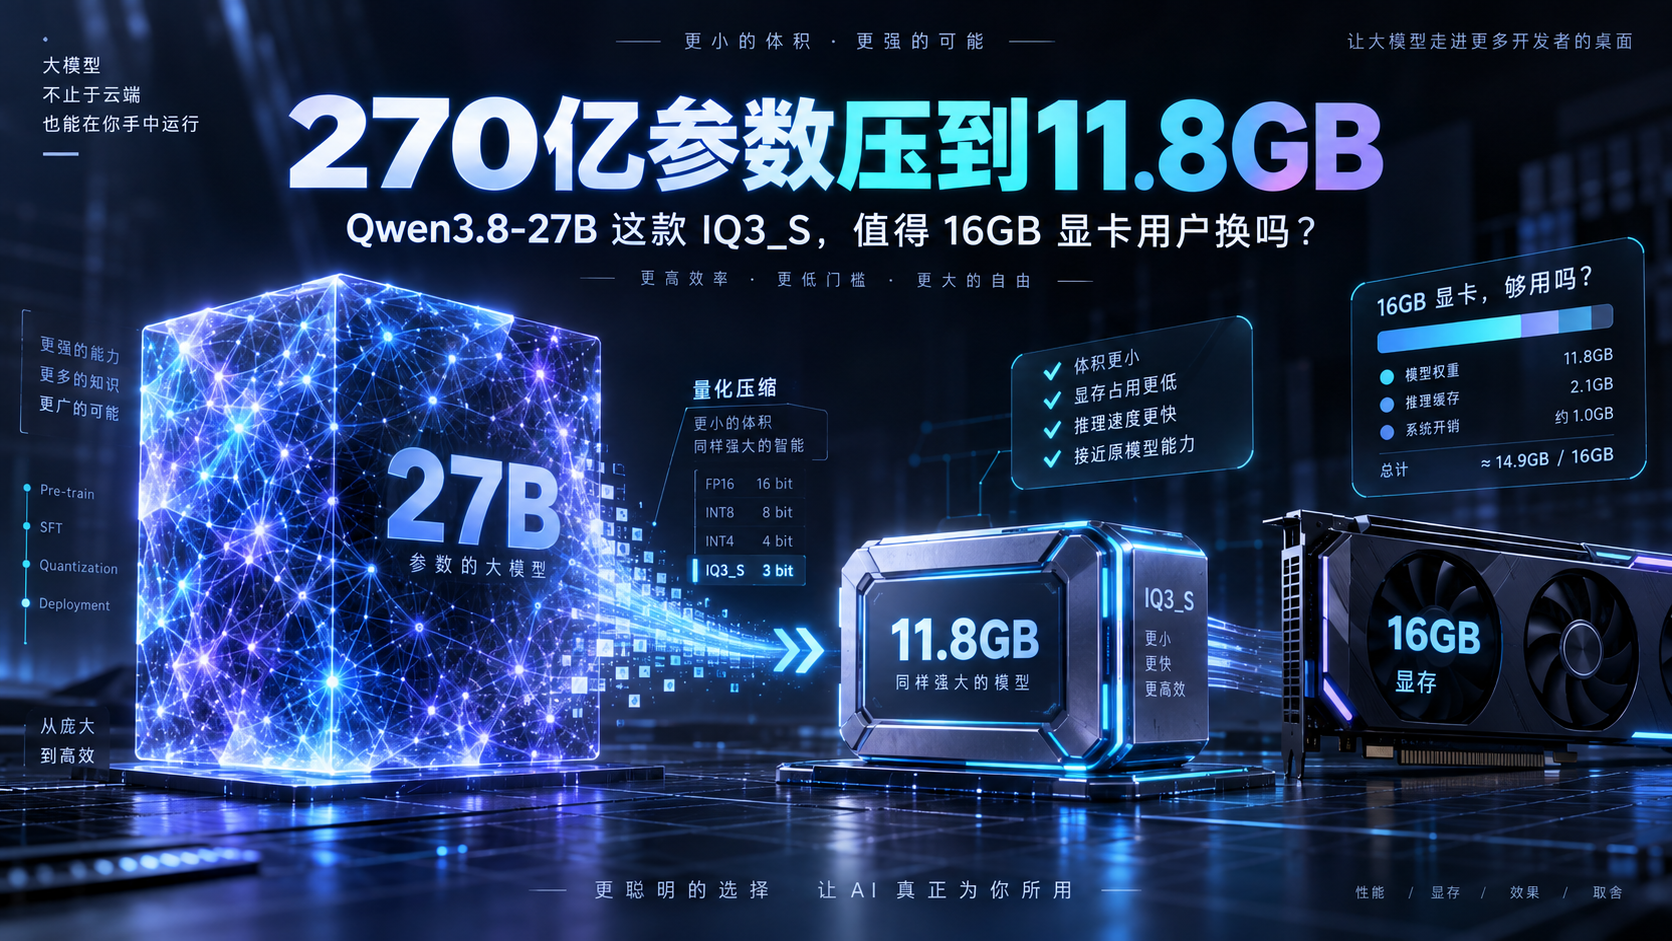 270亿参数压到11.8GB:Qwen3.8-27B这款IQ3_S,值得16GB显卡用户换吗?
奥地利 ISTA 团队把量化精度按张量重新分配,推出11.8GB的GSQ-RCO IQ3_S。它在发布方部分测试中接近BF16,但并非全面无损;本文核对四个IQ3文件、MTP开销与真实跑分,说明16GB显卡用户该比较什么。IQ3_S于9月1日加入仓库,本文于9月14日复核,不是近五天首发。
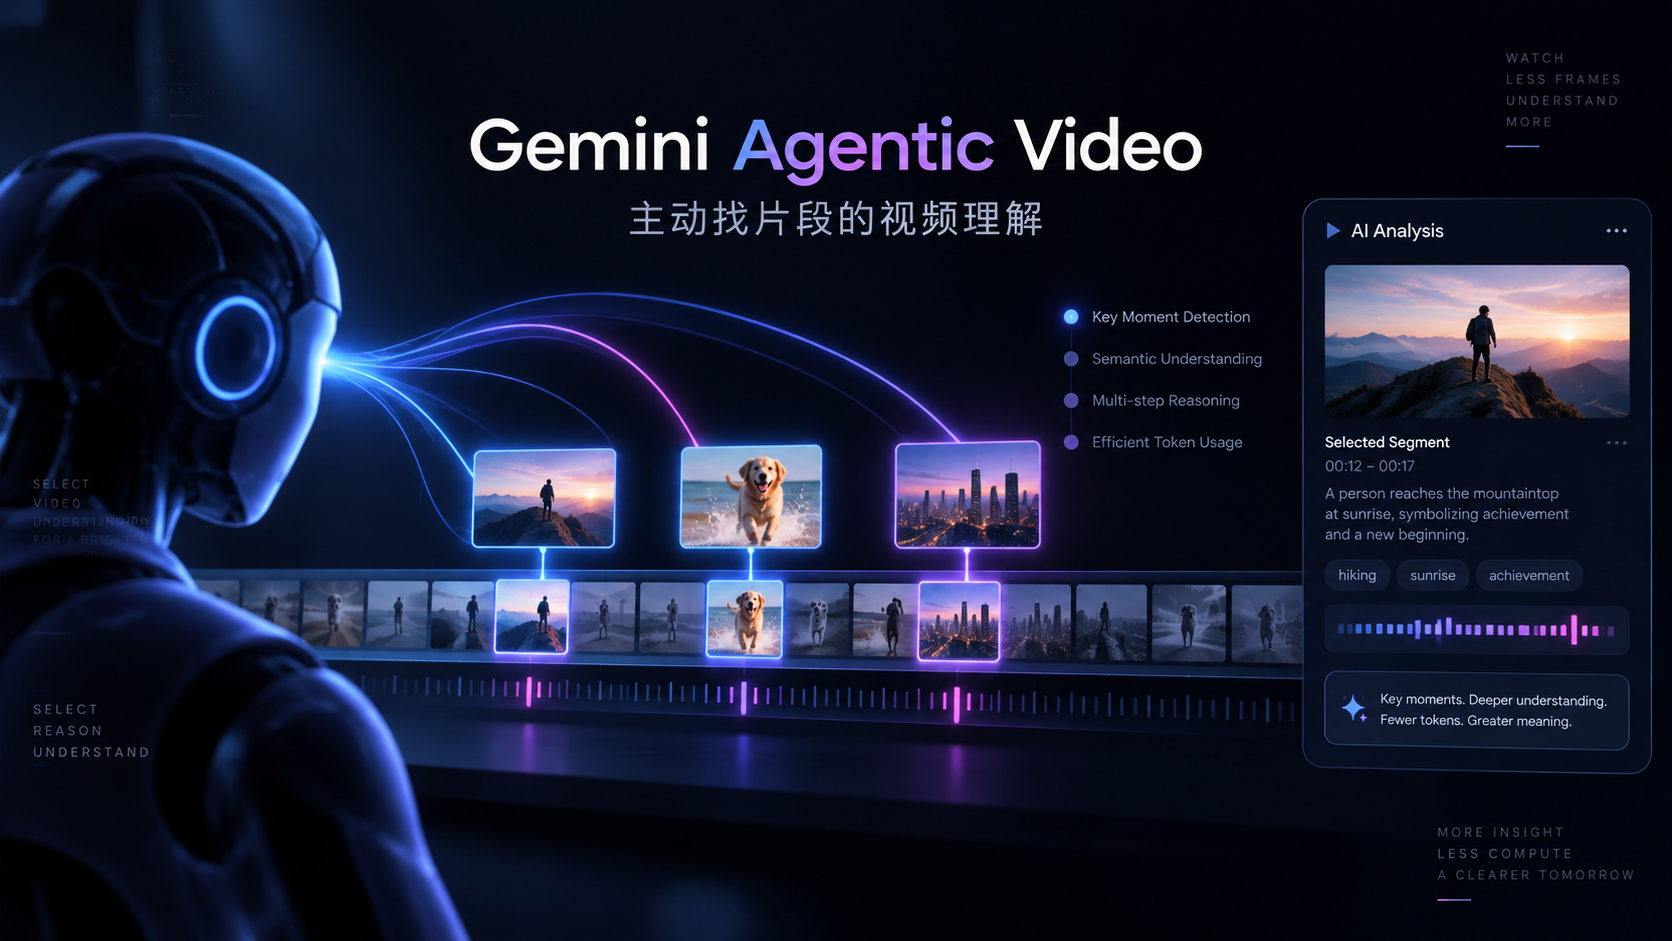 Gemini Agentic Video:不再按固定 FPS“看完整段视频”,Token 最多降 88% 的关键是主动找片段
Google 把视频理解从固定 1 FPS 采样升级成 Agentic Processing:模型根据问题主动搜索时间线、选择 Frames / Audio / Transcript,并对关键片段提高 FPS 重采样。Google 自报 Token 最多减少 88%、分析成本最多降低 66%、准确率最高提升 7%。
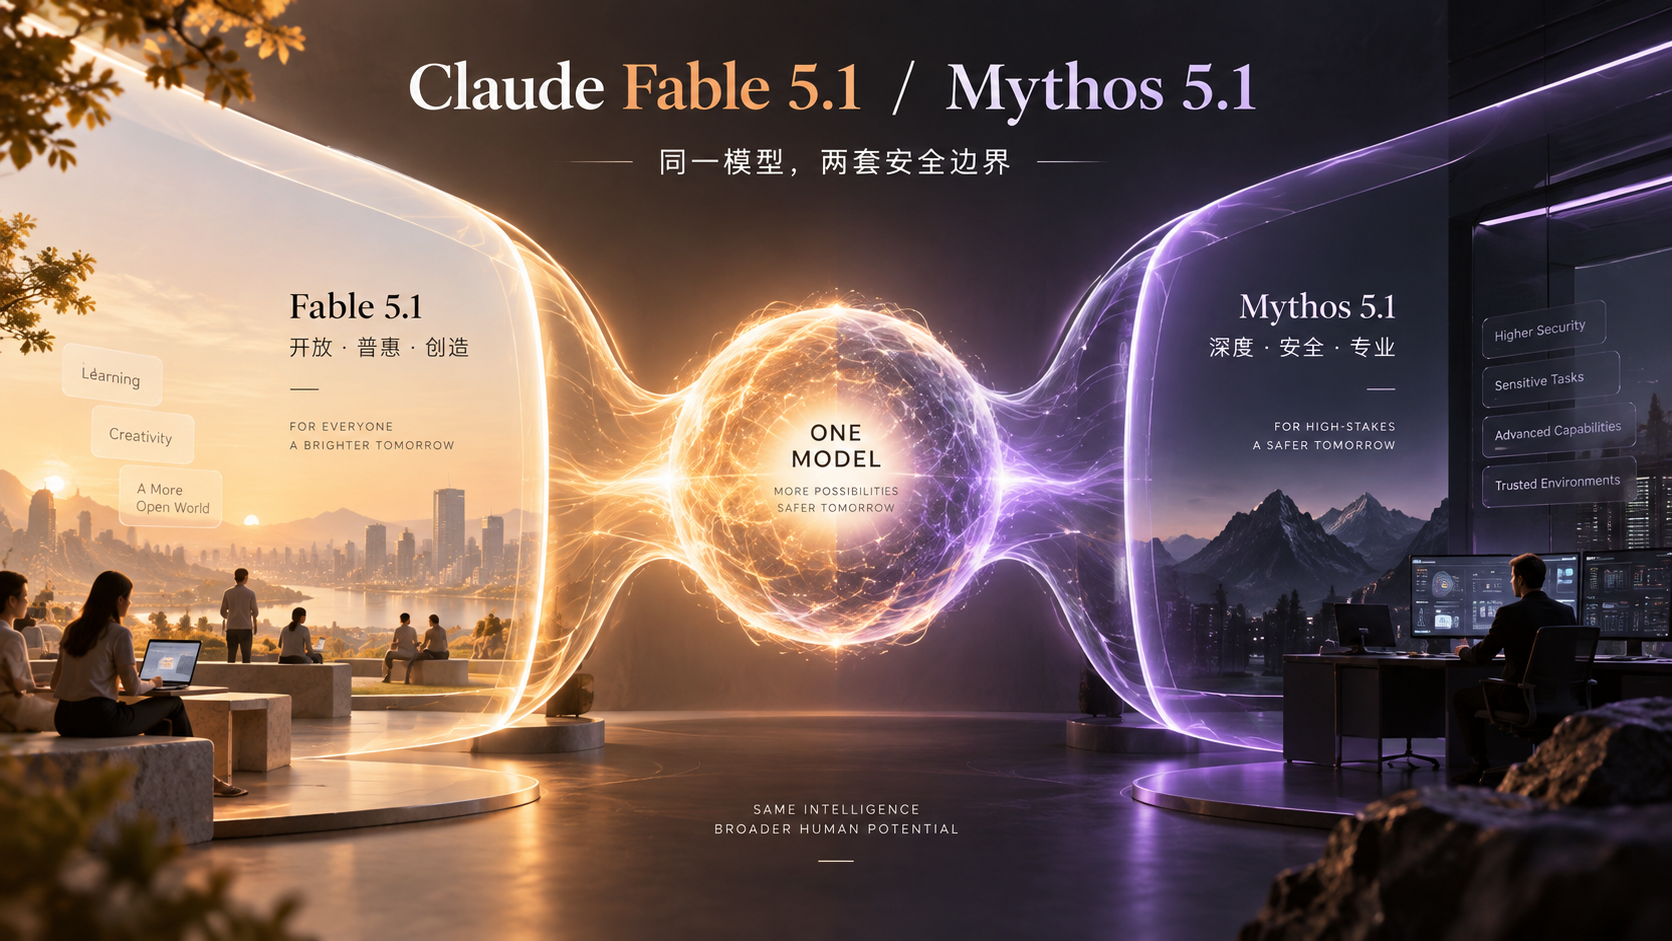 Claude Fable 5.1 与 Mythos 5.1:同一个模型、两套安全边界,Anthropic 开始分层开放前沿能力
Anthropic 同时发布 Claude Fable 5.1 与 Mythos 5.1。两者是同一个底层模型,真正的差异在安全护栏与 Trusted Access:Fable 面向一般用户,Mythos 为经过审核的网络安全与生命科学场景开放更高权限能力。
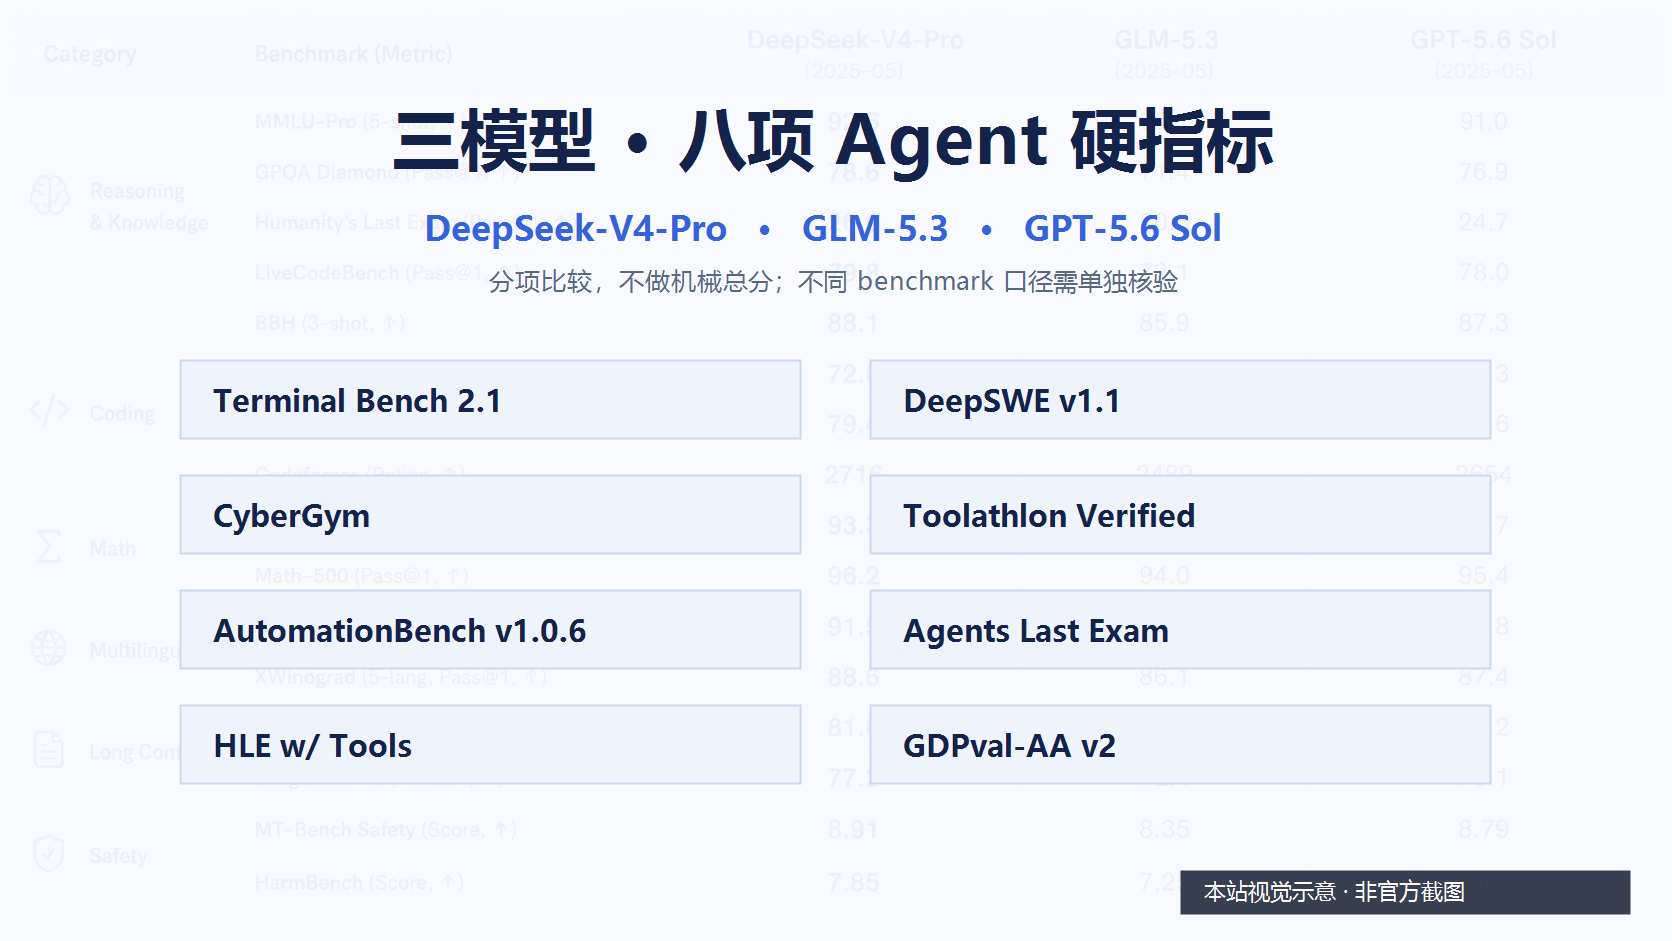 DeepSeek-V4-Pro、GLM-5.3、GPT-5.6 Sol:用八项硬指标做三模型测评
以终端、长程代码、安全、工具调用、自动化、专业工作、工具增强推理与职业任务八项硬指标比较三款模型;逐项标注图表数值与一手发布材料的口径边界。
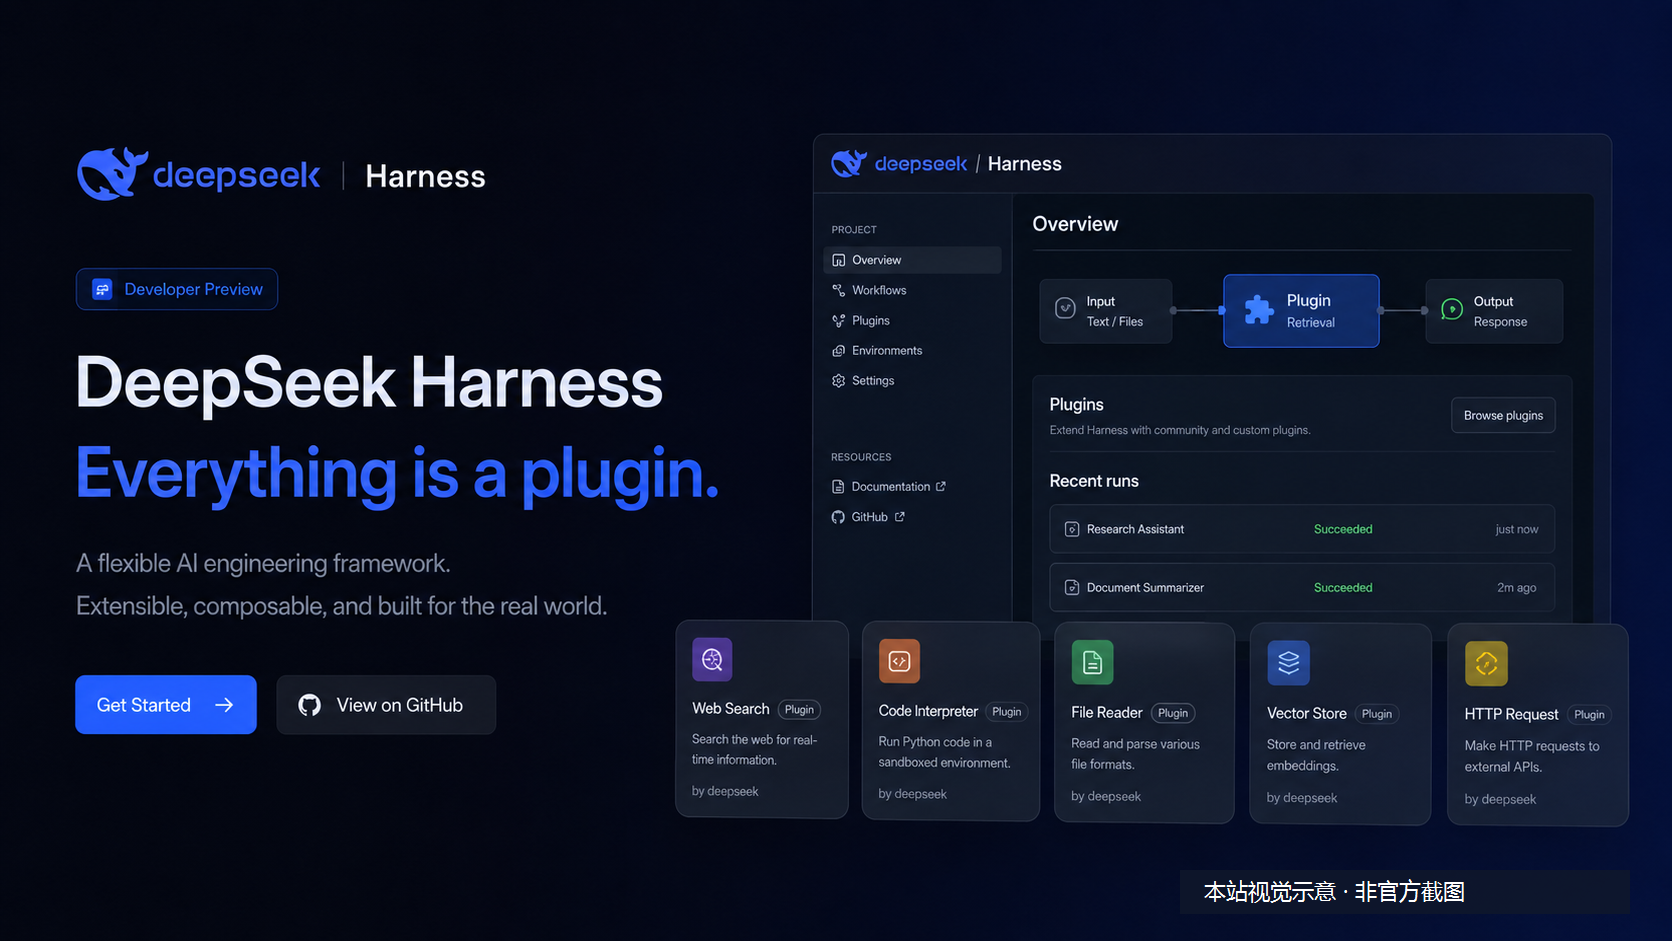 DeepSeek Harness:用“万物皆插件”组织 Agent 工程环境,但仍处于开发者预览
DeepSeek 在开源项目 DeepSeek Harness 中提出以插件为中心的 Agent 工程环境:命令行工具 dsh 基于 Cordis,既可通过 npm 启动本地 Web UI,也可从源码构建。项目当前明确标注为开发者预览,兼容性破坏性变更仍可能发生;它更适合作为团队研究 Agent 工作流组织方式的对象,而非直接当作稳定生产底座。
 DeepSeek-V4-Pro 正式版上线:Agent 能力提升之外,还应怎样读独立测评
DeepSeek-V4-Pro GA 新增 Responses API 与 Codex 适配,并公布了多项 Agent 分数;但这些属于厂商自报。本文补入 NIST/CAISI 与公开 AgentRE-Bench 的独立证据,说明它们评测的版本、脚手架、预算与未能覆盖的 GA 增量,帮助团队把“官方能力声明”与“可迁移的选型证据”分开。
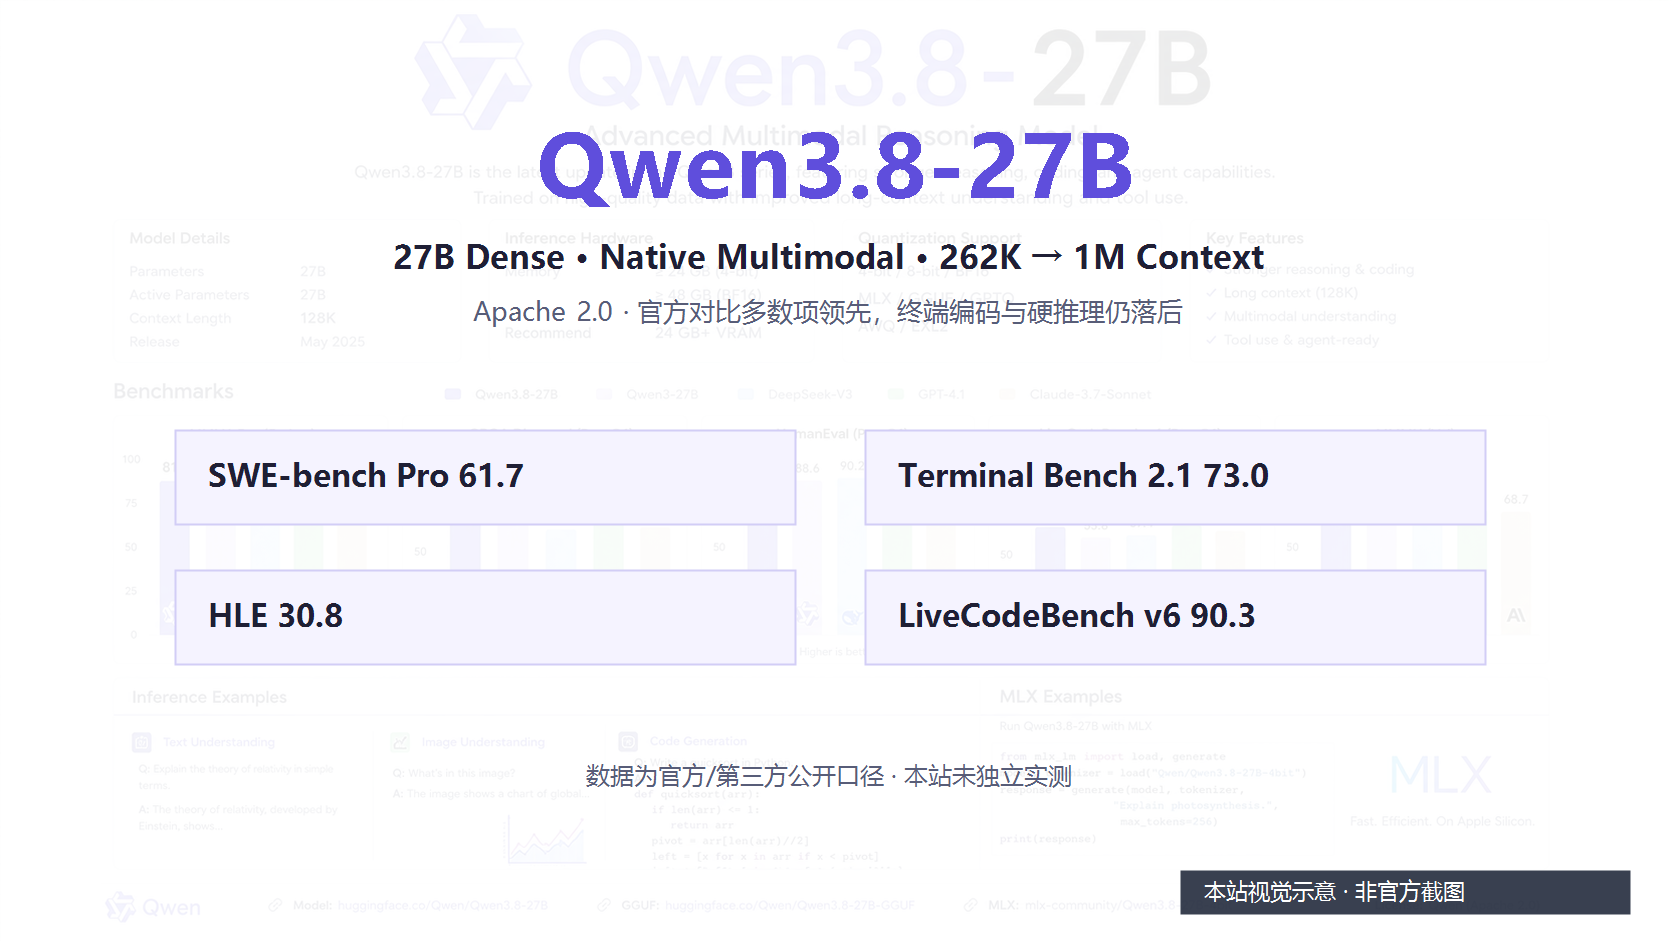 Qwen3.8-27B 评测观察:官方对比多项反超 Opus 4.6 Max,终端编码与硬推理仍落后
2026-08-14 阿里开源 Qwen3.8-27B:27B 稠密原生多模态模型,Apache 2.0,262K 上下文可扩至 1M,量化后单张 24GB 消费级显卡可跑。官方模型卡全表显示,与 Opus 4.6 Max 可直接对比的 17 项中 13 项领先(SWE-bench Pro 61.7 vs 53.4、OSWorld 84.3 vs 72.7),但 Terminal Bench 2.1、NL2Repo、GPQA、HLE 四项落后;第三方追踪榜单处于中游偏上,无单项进前三。本文对照 GLM-5.3、GPT-5.6 Sol、DeepSeek-V4-Pro 等热门模型给出选型观察,全部数据可溯源,未做独立实测。
工作场景
从代码、办公、运营和设计等真实任务开始练习 AI Agent


编程开发
从需求拆解、代码实现到调试测试和部署交付


自动化办公
会议纪要、表格整理、周报月报和资料归档


自媒体运营
选题、标题、脚本、封面和发布复盘


视频剪辑
分镜、素材清单、字幕结构和剪辑节奏


视觉设计
风格方向、版式参考、设计提示词和封面方案


原型设计
需求分析、页面拆解、交互说明和 HTML 原型
从一篇教程开始,把 AI 用到真实任务里
先用公开内容建立方法感,需要模板、资源包或陪跑时,再从文章和服务入口自然进入
开始学习