
Qwen3.8-27B 评测观察:官方对比多项反超 Opus 4.6 Max,终端编码与硬推理仍落后
2026-08-14 阿里开源 Qwen3.8-27B:27B 稠密原生多模态模型,Apache 2.0,262K 上下文可扩至 1M,量化后单张 24GB 消费级显卡可跑。官方模型卡全表显示,与 Opus 4.6 Max 可直接对比的 17 项中 13 项领先(SWE-bench Pro 61.7 vs 53.4、OSWorld 84.3 vs 72.7),但 Terminal Bench 2.1、NL2Repo、GPQA、HLE 四项落后;第三方追踪榜单处于中游偏上,无单项进前三。本文对照 GLM-5.3、GPT-5.6 Sol、DeepSeek-V4-Pro 等热门模型给出选型观察,全部数据可溯源,未做独立实测。
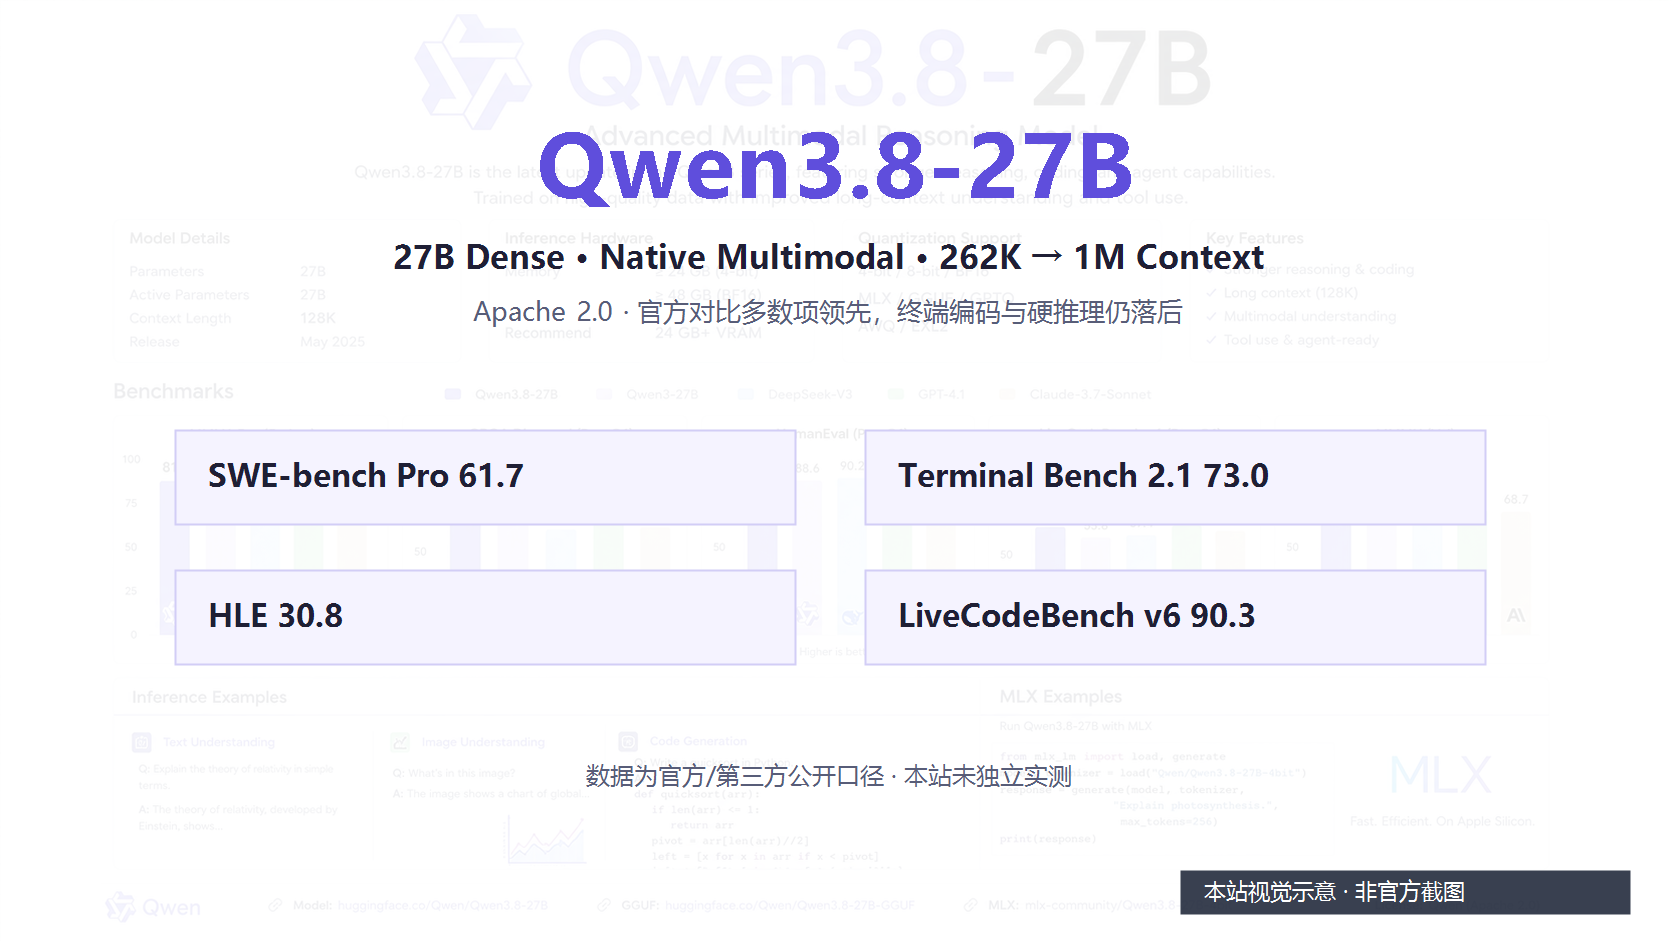
2026 年 8 月 14 日晚间,阿里千问团队通过"千问大模型"公众号宣布 Qwen3.8-27B 正式开源,权重同步上架 Hugging Face 与魔搭社区,许可证为 Apache 2.0。这是一个 27B 参数的稠密(Dense)原生多模态模型,支持图片与视频输入,原生 262K 上下文、经 YaRN 可扩展至 1M。由于量化后单张 24GB 消费级显卡即可整卡装载,发布当天即引发 Reddit r/LocalLLaMA 社区刷屏,网友用其复刻的俄罗斯方块、贪吃蛇等 demo 广泛传播(量子位报道)。
本文是一篇评测观察:把 Qwen 官方模型卡的对比全表、第三方追踪榜单的跨模型口径放在一起读,回答两个问题——它到底比 Opus 4.6 Max 强在哪、弱在哪;放到当前热门模型里它处于什么位置。本文全部数据来自厂商公布与第三方追踪口径,未做独立实测。
先说结论
- 官方口径下,Qwen3.8-27B 与 Opus 4.6 Max 可直接对比的 17 项中 13 项领先、4 项落后。领先集中在软件工程、Agent 办公与全部多模态项;落后集中在 Terminal Bench 2.1、NL2Repo、GPQA 与 HLE——即终端长程编码与硬推理。
- 第三方追踪口径(AI Release Tracker,截至 8 月 15/16 日)中,它没有单项进入前三,最接近的是 LiveCodeBench(90.3,第 4);与 GPT-5.6 Sol、Claude Fable 5 等前沿闭源模型在长程任务上仍有 15~30 分差距。
- 它的真正卖点不在"跑分第一",而在部署组合:Apache 2.0 + 27B 单卡可跑 + 原生多模态 + 262K 上下文,这是当前本地 Agent 开发者最难在别处同时拿到的东西。
模型本体:架构没换,训练换了
对照 NxCode 的架构核对,Qwen3.8-27B 的 config.json 与上一代 Qwen3.6-27B 完全一致:64 层、隐藏维度 5120、Gated DeltaNet 线性注意力与 Gated Attention 混合布局、多 token 预测(MTP),继续使用 qwen3_5 实现。也就是说,这一代的提升来自训练与后训练,而非新架构。
推理控制方面:思考模式默认开启,reasoning_effort 分 xhigh(默认)/ medium / low 三档,preserve_thinking 可跨轮保留推理上下文。官方最佳实践提示,调低 effort 不一定缩短总任务时间——分析不足会导致更多重试,Agent 场景应保留充足的输出预算。
部署侧,Ollama 已上架 18GB 标准包与 Apple Silicon MLX 包;官方同时发布面向 vLLM / SGLang / Transformers / TokenSpeed 的 FP8 权重。社区反馈 RTX 3090 / 4090(24GB)量化后可整卡装载,16GB 显存卡也能以更低量化档运行;API 侧 OpenRouter 定价为每百万 token 输入 $0.45 / 输出 $3.20。
单独对比:与 Opus 4.6 Max 的官方全表
先界定对比对象:Qwen 官方图表中的对手标注为 "Opus4.6 Max",即 Anthropic 2026 年 2 月 5 日发布的 Claude Opus 4.6(API 定价 $5 / $25,1M 上下文)在最高推理档的成绩。需要注意,第三方追踪站显示 Anthropic 此后已发布更新的 Opus 型号,因此这组对比并非"对阵 Anthropic 最新旗舰"。
文本能力(官方表,12 项):
| 基准 | Qwen3.8-27B | Opus 4.6 Max | 结果 |
|---|---|---|---|
| Terminal Bench 2.1 | 73.0 | 78.2 | 落后 5.2 |
| SWE-bench Pro | 61.7 | 53.4 | 领先 8.3 |
| NL2Repo-Bench | 42.3 | 47.6 | 落后 5.3 |
| DeepSWE 1.1 | 42.2 | -- | 无对比 |
| QwenSWEBench | 79.0 | 63.8 | 领先 15.2 |
| CoWorkBench | 70.7 | 68.2 | 领先 2.5 |
| JobBench | 33.4 | -- | 无对比 |
| Agents' Last Exam(Pass@1) | 20.4 | -- | 无对比 |
| IFBench | 79.5 | 62.5 | 领先 17.0 |
| GPQA Diamond | 89.2 | 91.3 | 落后 2.1 |
| HLE | 30.8 | 40.0 | 落后 9.2 |
| LiveCodeBench v6 | 90.3 | 88.8 | 领先 1.5 |
多模态能力(官方表):OSWorld-Verified 84.3 vs 72.7(领先 11.6)、AndroidWorld 81.9 vs 62.0(领先 19.9)、SWE-MM 38.6 vs 27.1、开启 CI 后 MathVision 94.6 vs 65.5、CharXiv 90.2 vs 85.9、OmniDocBench 1.5 91.1 vs 86.6、ClawEval-MM Pass@3 57.4 vs 52.5——凡 Opus 4.6 Max 有成绩的 VL 项,Qwen3.8-27B 全部领先;WebArena-Verified(64.8)与 Vision2Web(62.9)对方未提供数据。
两点值得展开。其一,媒体报道与全表的差异:中文社区传播最广的"反超 Opus"(SWE-bench Pro +8.3、QwenSWEBench +15.2)都是真实数字,但同一张官方表里 Terminal Bench 2.1、NL2Repo、GPQA、HLE 四项落后并未被同等传播——完整读表,它是一个"多数项领先、终端与硬推理落后"的格局,而非全面碾压。其二,一代跃迁的幅度确实惊人:对比 Qwen3.6-27B,DeepSWE 1.1 从 13.3 升至 42.2(约 3.2 倍)、QwenSWEBench 从 49.3 升至 79.0、OSWorld 从 63.9 升至 84.3、WebArena 从 48.8 升至 64.8,并在多数编程与办公项上反超更大规模的 Qwen3.7-Plus(GPQA 与 HLE 除外),这也是官方宣传"编程、办公场景超越 Qwen3.7-Plus"的依据。
与其他热门模型的对比:第三方追踪口径
把镜头拉远,AI Release Tracker 的跨模型榜单(截至 8 月 15/16 日)给出了另一个坐标系:
| 基准 | Qwen3.8-27B(排名) | 榜单最好成绩 | 保持者 |
|---|---|---|---|
| SWE-bench Pro | 61.7(#8/20) | 80.3 | Claude Fable 5 |
| DeepSWE 1.1 | 42.2(#13/18) | 73.0 | GPT-5.6 Sol |
| LiveCodeBench | 90.3(#4/7) | 93.5 | DeepSeek-V4-Pro |
| Terminal-Bench 2.1 | 73.0(#18/25) | 88.8 | GPT-5.6 Sol |
| GPQA Diamond | 89.2(#17/50) | 94.4 | GPT-5.4-Pro |
| HLE(无工具) | 30.8(#13/19) | 56.3 | Claude Opus 5 |
| Agents' Last Exam | 20.4(#3/3) | 28.5 | GLM-5.3 |
| JobBench | 33.4(#4/5) | 54.7 | Muse Spark 1.1 |
解读:一个 27B 开源模型能在 SWE-bench Pro 挤进前十、LiveCodeBench 距榜首 3 分以内,已经是尺寸上的超额表现;但 DeepSWE(差距 30.8 分)、Terminal-Bench(差距 15.8 分)、HLE(差距 25.5 分)说明在长程硬任务上,闭源前沿仍有明显身位差——这与官方表中"TB2.1 / HLE 落后"互相印证。
同期开源竞品的定位差异更值得注意:
- GLM-5.3(智谱,8 月 14 日同日发布):744B MoE 基座不变、纯后训练升级,官方口径 Terminal Bench 3.0 28.3 为开源 SOTA、DeepSWE v1.1 66.9、CyberGym 84.5%,权重预计 8 月 28 日后放出。它的 DeepSWE 与 ALE 成绩都明显高于 Qwen3.8-27B——但那是 744B 对 27B 的对比,部署生态位完全不同。
- DeepSeek-V4-Pro(8 月 13 日 GA):LiveCodeBench 93.5 榜首,本站已在前文覆盖;API 形态强、暂未开源权重。
- Muse Glimmer-30B(Meta,8 月 10 日,Apache 2.0):最直接的尺寸竞品,但在 Qwen 官方表中全面被压制(TB2.1 51.7 vs 73.0、SWE-bench Pro 51.2 vs 61.7、OSWorld 65.9 vs 84.3)。
- NVIDIA Nemotron 3.5 Lightning(8 月 11 日):30B-A3B MoE 走速度与效率路线,与本文主角的"稠密全能"路线形成互补。
口径与限制:怎么读这些数字
- 官方表全部为 Qwen 自报口径;其中 QwenSWEBench、CoWorkBench、ClawEval-MM 为 Qwen 自有基准,跨厂商可比性有限。
- 部分多模态软件工程基准(如 SWE-bench 多模态变体)由其他前沿模型参与评分而非确定性测试,第三方分析均提示应视为"待验证信号"。
- 本地部署的量化档位会改变 Agent 行为,官方分数基于原始权重与特定 harness;第三方榜单为追踪站汇总口径,会随后续复测变动。
- 本文未做独立实测;所有结论均为对公开口径的整理与对照。
选型建议
- 适合:本地常驻 Agent(隐私 / 数据驻留要求)、UI 驱动型 Agent(原生视觉输入 + OSWorld / AndroidWorld 领先正是这类任务的画像)、高频低成本调用(OpenRouter 定价约为 Opus 4.6 的 1/11~1/8)、需要 262K 长上下文装下代码库切片的本地循环。
- 不适合:追求绝对最强终端编码与深度推理(GPT-5.6 Sol、Claude Fable 5 等闭源前沿仍领先 15~30 分)、没有本地 GPU 与运维意愿的团队。
- 与 GLM-5.3 怎么选:要"今天就能在单卡上跑的权重"选 Qwen3.8-27B;能等 8 月 28 日权重放出并有数据中心资源、追求开源最强编码,再评估 GLM-5.3。
一句话总结:Qwen3.8-27B 不是"本地 Opus 平替"——它在终端与硬推理上还没到那个位置;但它可能是目前"一张消费级显卡上最完整的多模态 Agent 模型",官方表中那 4 个落后项,恰好就是下一步选型时需要用你自己任务集去验证的地方。
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 17GB对100GB:Qwen3.8-27B与Flash-Next做同一批任务,省下的容量换来了什么?
同做89项终端任务,17GB的27B首轮完成35项,100GB的Flash-Next完成45项;最多两次是46对53,最多四次是48对60。本文追到9月13日后续结果,区分模型能力、环境故障和返工时间;测试为苹果MLX四位量化,不是GSQ-RCO IQ3_S,也不能套到16GB显卡。
 Qwen3.8-Flash-Next每秒70词元?本地加速之前,先看模型究竟改了什么
同样叫Flash-Next,70词元/秒背后可能是另一条计算路径:每词元激活专家从10减到5,再训练共享专家补偿。本文对照单台DGX Spark的两套原始资料,拆开量化、MTP、输入速度、输出速度和并发吞吐,不把128GB统一内存结果套到16GB显卡。
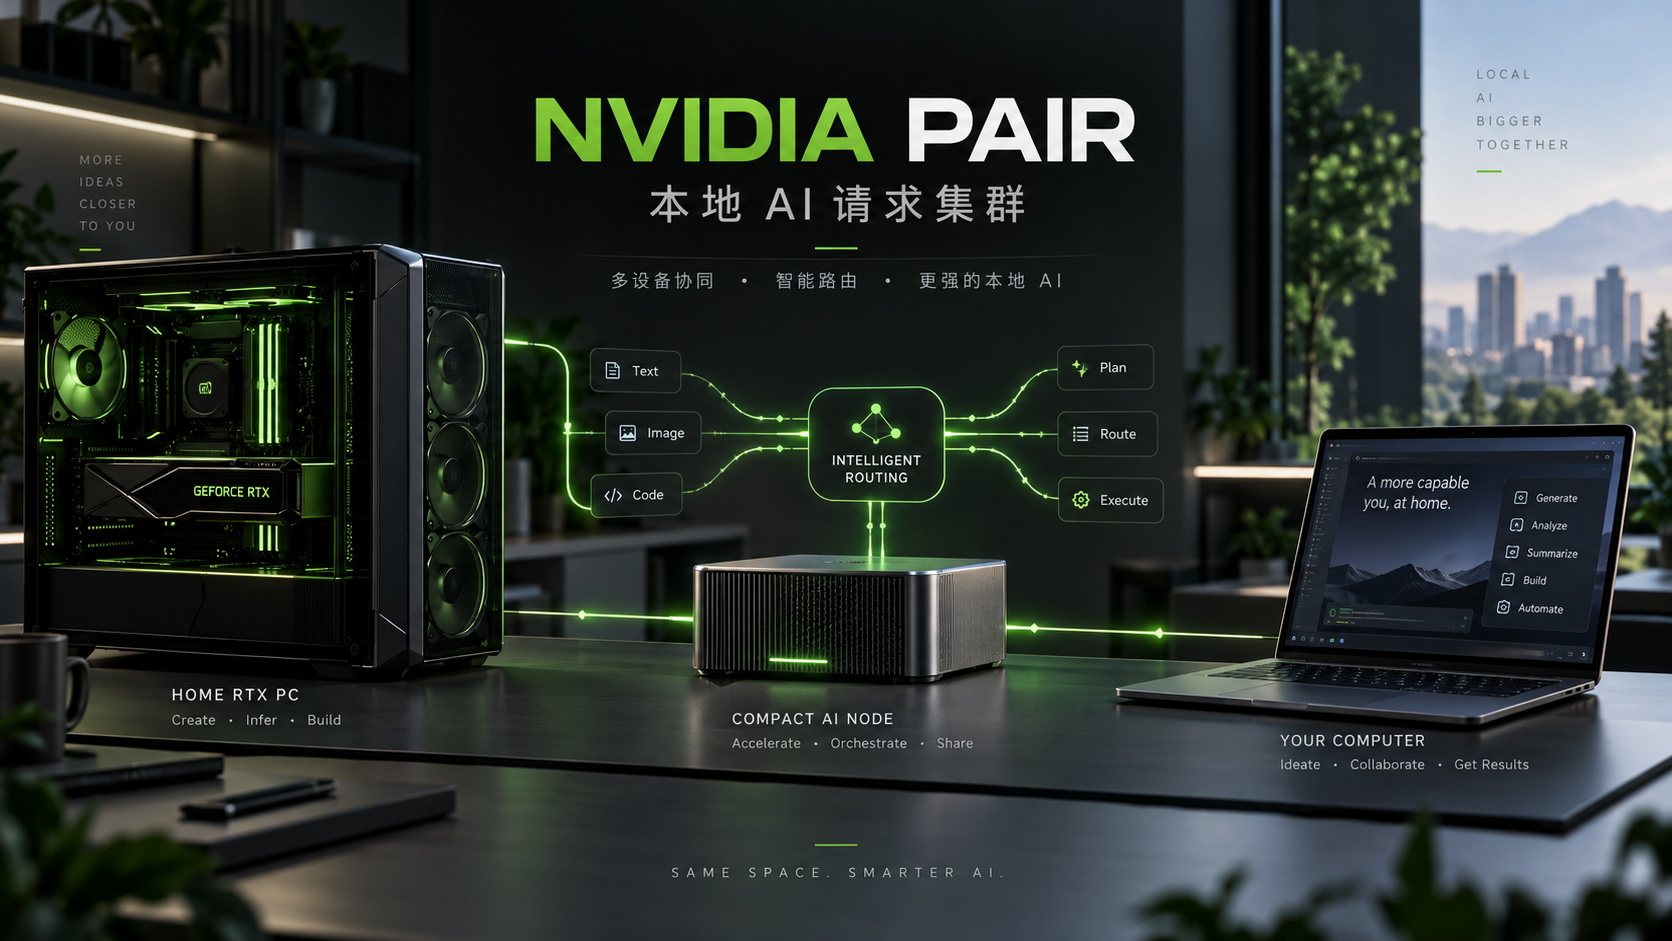 NVIDIA PAIR:把家里的 RTX、DGX Spark 和 Mac 变成本地 AI 请求集群,但它不是“显存池化”
可以把 NVIDIA PAIR 理解成家里本地 AI 的“派单前台”:RTX 主机、DGX Spark、Mac 就像几名能力不同的员工,PAIR 看谁在线、谁装了对应模型、谁现在最空闲,就把下一份 AI 工作交给谁。它特别适合多 Agent 并发,但不会把 16GB + 24GB 显存拼成 40GB,也不会把一个大模型拆到多台机器上。