Strata 让大模型跑上家用电脑:8GB 显存够不够?
从 Strata 仓库中标为 9 月 29 日的速度记录出发,先分清 8GB 可运行与 12GB 测试成绩,再解释显卡、内存和处理器如何分工,以及 128K 长输入、量化和代码裁剪版的取舍。
在 Strata 的 GitHub 项目仓库里,一份日期标为 2026 年 9 月 29 日的速度记录,给本地模型玩家提供了一个值得研究的例子:项目开发者用 RTX 5070 12GB 和 64GB 系统内存,运行 Qwen3.8-Flash-Next,在 128K 长输入之后仍测到了每秒数十个词元的输出。作者原始记录
围绕 Strata(本地推理引擎,读音 strah-tuh),一个更吸引人的说法是“8GB 显存也能跑”。项目文档确实写了可以运行,同时提醒速度会慢一些;上面的高速记录,用的是 12GB 显卡。把这两点放在一起,才好回答大家关心的问题:不用买大显存卡,究竟能把模型用到哪一步?硬件条件说明
先弄清楚,它为什么装得下
Strata 要做的是利用整台电脑的资源。模型有多大固然重要,每一步实际要计算哪部分,也很关键。
它运行的 Qwen3.8-Flash-Next 采用 MoE(混合专家,读音 em-oh-ee)结构。可以把这些“专家”理解为许多计算模块:处理当前内容时,模型挑出其中一部分参与工作,不需要每一步都让全部模块一起计算。Qwen 官方模型卡
在逐步生成答案时,Strata 这样安排硬件分工:显卡处理经常要算的部分,并缓存一部分常用专家;系统内存保存专家权重;这一步需要的专家不在显卡缓存里时,由处理器在内存侧计算。模型还有一张很大的查找表,放在固态硬盘上,运行时读取需要的部分。项目的原理说明
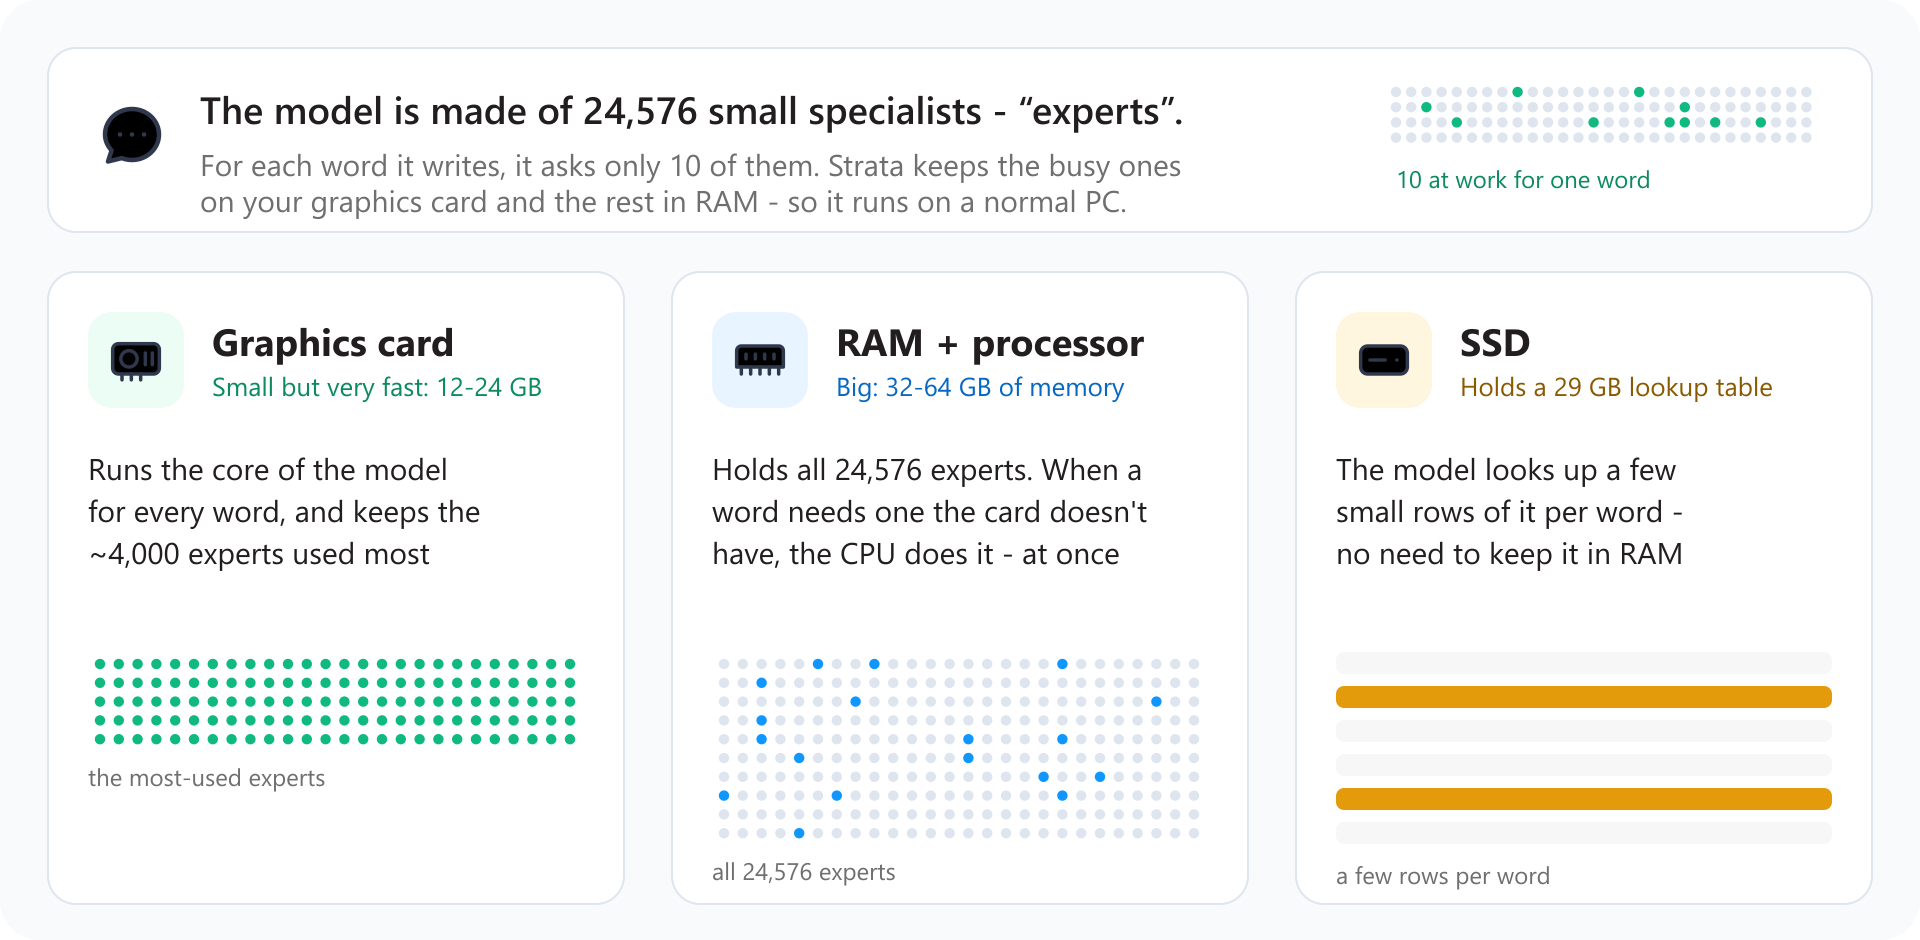
读取长输入时,处理方式有所不同。项目会分块处理文本,在计算当前层的注意力时,把下一层所需的专家数据通过主机与显卡之间的数据通道传到显卡。读材料和逐步写答案,不能都套用上面同一套分工来理解。长输入处理说明
因此,模型不必全部挤进显存。不过,显卡分出去的工作仍然要有人做。内存够不够、带宽如何、处理器算得快不快,都会影响这套分工的效果。
参数口径也顺便说清楚:官方模型卡将语言模型主体列为 125B,每次激活约 6B,另外列出 51B 的查表嵌入和 4B 的多词元预测模块。B 表示十亿;这些数字描述不同部分,不能只拿“125B”推算全部文件大小。参数构成
装得下之后,还得让它算得快
除了分配硬件,Strata 还会利用模型自带的预测模块。小模块先提出后面几个词元的候选,主模型再一起检查;接受的候选多,一轮就能推进更多内容。这就是它所用的多词元预测加速思路。预测与验证机制
下面看实际记录。三个量化版本都来自引擎 0.1.26 的同一组作者测试,单位为词元/秒。Token(词元,读音 toh-kuhn)是模型处理文本的单位,与中文字数没有固定的一一对应关系。
| 量化版本 | 4K 输入后的生成速度 | 128K 输入后的生成速度 |
|---|---|---|
| Q2_0 | 93.0 | 73.7 |
| IQ3_XXS | 61.6 | 49.0 |
| IQ3_S | 53.3 | 45.5 |
测试电脑为 RTX 5070 12GB、Ryzen 5 7600、64GB DDR5-5200,运行 Windows 10,并开启多词元预测加速。每个测试格运行一次,使用代码智能体提示,生成 256 个词元。这里的 128K 是长输入测试档位,不是只把启动参数设成 128K、然后问一句“你好”。完整测试条件
其中 IQ3_S 在长输入之后测到 45.5 词元/秒,说明这台机器没有因为显存装不下全部模型,就只能慢慢往外吐字。至于中文长文和持续运行的表现,这组代码短输出测试还没有回答。
还要把“读材料”和“写答案”分开。模型收到长文档后,得先处理输入,之后才开始生成。输出速度很快,第一次等待仍可能不短;经常让助手读项目资料的人,需要把这段时间一起算上。
只有 32GB 内存,选择又会变
截至 10 月 6 日,Strata 首页把常规显卡条件写为 12GB 或以上,详细文档保留了 8GB 可运行但较慢的说明。显存较少的用户可以继续研究,但不能照搬上表作为自己机器的预期速度。项目首页与详细说明
系统内存紧张时,模型选择也不同。项目为 32GB 内存提供了 Coder(代码版,读音 koh-der)方向。它为了节省资源裁掉了一部分专家,作者提醒其非代码、非英语表现有损失。另有大显存配合低内存模式的配置路径,所以还要连同显卡一起判断。模型与内存选择说明
如果主要拿模型写中文需求、读合同、整理内容,这个差别比“能不能启动”更重要。一个在代码任务上表现不错的裁剪版,未必适合接手这些工作。
裁剪和量化也别混在一起。裁剪减少参与模型结构的专家;量化则用更紧凑的数值表示权重。上表里 Q2_0 更快,但这份速度记录没有同时给出三种量化在目标任务上的质量对照。选模型时,仍要看答案能不能用,不能只选速度最高的一行。
先用现有电脑确认瓶颈,再考虑加硬件
Strata 提供了一条值得尝试的路线:把部分压力从显卡分到处理器、内存和存储,让消费级电脑承担更大的模型。但它也让“这台电脑够不够用”变成了整机问题。
已经有机器的人,可以先拿一份真实长度的工作材料测试,记录首次读取、继续追问和长篇输出各需要多久,再检查内存占用、程序稳定性与答案质量。不要只凭一次短对话的峰值,决定要不要换显卡或加内存。
涉及内部资料时,还要确认外层助手的插件和日志去向。本地引擎在本机推理,不等于整条工具链都没有外部服务。
对于“8GB 够不够”,当前能给出的回答是:项目提供了运行路径,速度需要看整机和任务;这篇引用的 128K 成绩来自 12GB 显卡加 64GB 内存。先按这个条件核对自己的机器,再决定研究哪种模型,比追着一个脱离配置的速度数字更有帮助。
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 Grok Bot、Meta Muse 和 OpenAI Dot:个人 AI 助手该怎么选?
Grok Bot、Meta Muse 和 OpenAI Dot 接连登场。把三家放到个人或团队使用、应用接入、重复任务、记忆控制和额度这些共同问题下比较,给出有条件的试用顺序;本文为公开资料对照。
 OpenAI Dot:关掉聊天窗口之后,AI 还会继续帮你干什么?
OpenAI 于 9 月 29 日发布 Dot。以产品临时延期为例,看持续型助手怎样跟进材料变化、准备修改稿,以及哪些决定仍要交回用户;同时说明当前入口、记忆控制和工作额度。
 特朗普把 AI 改称 SI,科技巨头在白宫承诺了什么?
从白宫午餐会的座次图、特朗普与马斯克的改口,到阿莫代伊回应风险和引发X讨论的签名页错字,结合现场照片与原始文件,读懂AI改称SI及六家企业承诺的实际内容。