
17GB对100GB:Qwen3.8-27B与Flash-Next做同一批任务,省下的容量换来了什么?
同做89项终端任务,17GB的27B首轮完成35项,100GB的Flash-Next完成45项;最多两次是46对53,最多四次是48对60。本文追到9月13日后续结果,区分模型能力、环境故障和返工时间;测试为苹果MLX四位量化,不是GSQ-RCO IQ3_S,也不能套到16GB显卡。

一个模型17GB,另一个100GB;如果聊天时感觉都能答,是不是较小的那个更划算?BRAIN OS INSTITUTE博客作者在2026年9月10日公布了一组更接近“实际交活”的测试:让Qwen3.8-27B与Flash-Next执行同一套89项终端任务,而不是只回答几个短问题。结果是,小模型省下了约83%的模型存储体积,但没有同时省下等待与返工。作者首轮测试
本文复核到9月13日的第四轮更新。以下结果来自这位作者的公开记录,不是本站实测,也不代表正式排行榜成绩。它最有价值的地方,是把“能聊天”和“能按要求交付”之间的差别摊开了。
先认清比较对象:不是IQ3_S,也不是原始全精度模型
小模型是ddalcu/Qwen3.8-27B-MLX-Serve-4bit:作者记录约17GB,四位仿射量化、分组大小64,带MTP预测头。大模型是约100GB的Flash-Next混合4/8位量化。“stock”在这里指未做该系列去限制处理的对照版本,并不等于BF16原始权重。首轮配置说明
这套测试跑在M5 Max、128GB统一内存上,使用苹果平台的MLX推理体系。主要设置是mlx-serve 26.8.11、MTP开启、8位上下文缓存;任务使用Terminal-Bench 2.1的89项任务与terminus-2执行框架,上下文设置120K、温度0.3、推理档位xhigh、超时倍率1.0。作者还校正了旧文中的high:在该版本软件里实际被模板按xhigh处理;不能把这个映射推广到其他软件。环境与参数核对
因此,这篇不能用来证明另一款GSQ-RCO IQ3_S的真实任务质量,也不能预测Windows加16GB独立显卡的表现。17GB和100GB首先是作者使用的模型体积口径,不是两台机器的显存占用对比。
同样的重试预算,才有资格摆在一行
首轮是35对45;最多两次尝试,变成46对53。把小模型的46与大模型首轮45并排,就会制造“小模型反超”的错觉,实际上双方试的次数不同。第二轮原文
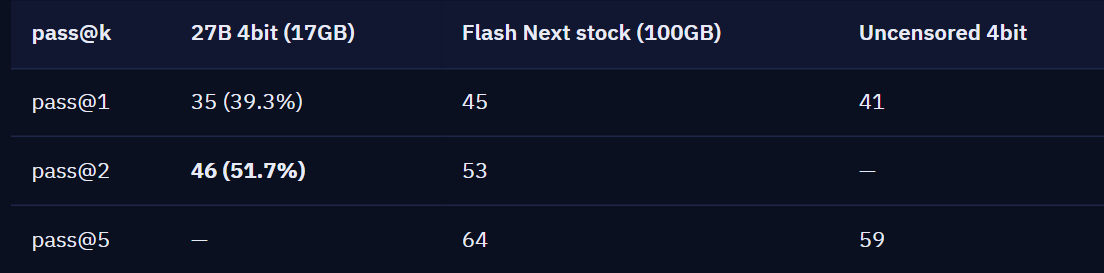
*图:原作者9月11日页面的真实表格截图。应沿同一行比较;原表中的去限制版本不是本文主要比较对象,空白项也不代表零分。*
继续沿作者此前的大模型系列查找,能补齐同预算的第三、四轮,而不必拿27B的第四轮去对比Flash-Next的第五轮:27B第四轮 · Flash-Next第三轮 · Flash-Next第四轮
| 每题最多尝试次数 | 27B累计完成 / 89 | Flash-Next累计完成 / 89 |
|---|---|---|
| 1次 | 35(39.3%) | 45(50.6%) |
| 2次 | 46(51.7%) | 53(59.6%) |
| 3次 | 46(51.7%) | 58(65.2%) |
| 4次 | 48(53.9%) | 60(67.4%) |
这里是“给未通过的任务继续机会,统计至少成功一次”的累计口径,不是重复全部任务后取平均,也不是自动等同官方排行榜的统计估计。次数对齐只是必要条件,不代表所有实验因素都已完全受控:测试跨不同日期,期间还有环境故障与服务重启。
第四轮不是重复新闻:它改变了对失败原因的解释
27B每轮新增完成量依次是35、11、0、2。第三轮没有增量,看起来像能力彻底触顶,但作者查到其中13项在模型开始生成之前,就因容器安装依赖触及120秒超时而退出。它们属于任务环境故障,不能直接描述成模型连续答错13题。第三轮及其故障更正
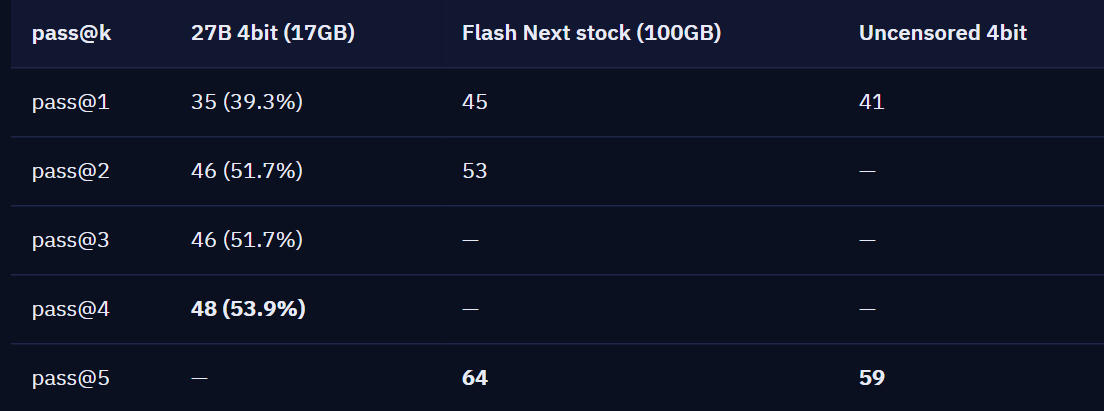
*图:原作者9月13日的更新截图,27B累计48项。原表未重列大模型第三、四轮;上文中文对齐表的数据另取自作者对应的大模型原文,没有用空白猜数。*
第四轮重启服务、以相同启动参数重跑剩余43项后,新增2项,环境错误降至1项;那1项发生于任务已运行之后,与前一轮的安装阶段错误不同。这些日志让“失败发生在哪一步”更清楚,但一次跨日期重跑不能单独证明网络或重启的因果效果。第四轮日志解释
截至本文9月14日核查,作者订阅源中这条系列的最新文章是第四轮;文中只说第五轮正在运行,没有给出最终数字。因此本文不补写27B第五轮分数。作者订阅源
存储便宜,不等于每次交付也便宜
首轮27B耗时31小时11分钟,Flash-Next约24.7小时;27B第二轮只重试54个失败任务,仍用了23小时49分钟,第四轮又用了21小时49分钟。这些是作者整轮运行时间,不是你处理一份文档所需的时间,更不是收费模型的账单。首轮耗时 · 第二轮耗时 · 第四轮耗时
一个容易误读的细节是:第二轮11项成功补做任务的耗时中位数只有6.5分钟,却不能说每补成一项只花6.5分钟。中位数只看成功者,没有计入其他失败任务消耗的等待。这就像只统计返修成功的工单,不统计修了很久仍没修好的工单,成本会显得过分乐观。
文件小也没有直接转化为输出快。作者按请求长度统计的中位数中,小于8K的请求里,27B输出53.9词元/秒,Flash-Next为73.3;8K—32K分别为56.4与65.5。大模型采用混合专家结构,每次并非动用全部权重;但这些是不同请求集合的日志统计,不能作为严格同提示词的加速比。原始速度口径
产品经理该比较的,不只有分数,还有“谁来收尾”
作者列出的失败并不都是“不会写代码”:有的重复同一条命令直到超时,有的自称验证通过,实际产物却漏掉日志字段、环境变量或验收条件。大模型也有这些问题,只是这组记录中的频率和分布不同。另一方面,小模型也完成过大模型多轮未完成的具体任务,因此总体落后不等于每道题都更差。首轮失败案例 · 第二轮个别反例
本站的判断是:对于人工随时检查的需求整理、格式转换和小范围修改,可以把小模型视为低资源候选;对于长时间自主执行,更要计入监督、重试和验收成本。这是从案例提炼的选型方法,不是这套终端测试已经测过所有产品经理工作。
与其问“17GB能不能替代100GB”,不如问:在你自己的任务清单里,它需要多少次纠正,失败能否及早被发现,最终由谁负责确认结果?模型体积决定能不能放进机器,可靠交付决定值不值得放进工作流。
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 Qwen3.8-Flash-Next每秒70词元?本地加速之前,先看模型究竟改了什么
同样叫Flash-Next,70词元/秒背后可能是另一条计算路径:每词元激活专家从10减到5,再训练共享专家补偿。本文对照单台DGX Spark的两套原始资料,拆开量化、MTP、输入速度、输出速度和并发吞吐,不把128GB统一内存结果套到16GB显卡。
 NVIDIA PAIR:把家里的 RTX、DGX Spark 和 Mac 变成本地 AI 请求集群,但它不是“显存池化”
可以把 NVIDIA PAIR 理解成家里本地 AI 的“派单前台”:RTX 主机、DGX Spark、Mac 就像几名能力不同的员工,PAIR 看谁在线、谁装了对应模型、谁现在最空闲,就把下一份 AI 工作交给谁。它特别适合多 Agent 并发,但不会把 16GB + 24GB 显存拼成 40GB,也不会把一个大模型拆到多台机器上。
 GPT-6 Astra 发布:游戏开发、3D 建模与长程 Agent,距离 AGI 通用人工智能还有多远?
2026 年 9 月 3 日,OpenAI 发布 GPT-6 Astra,强化电脑操作、专业制作与长程任务能力。先看本次发布的核心升级,再结合游戏开发、Blender 房屋、Playco 与 ARC Prize 评估,理解它在 AGI 通用人工智能方向的进展和仍待验证的问题。