
OpenAI 发布 GPT-5.2,专业知识工作成为模型竞争主战场
OpenAI GPT-5.2 强调专业知识工作、长任务、工具调用、表格和演示文稿生成,模型能力进一步指向真实工作场景。

GPT-5.2 面向专业知识工作:表格、演示、长上下文和工具调用成为主线
OpenAI 在 2025 年 12 月 11 日发布 GPT‑5.2,将其称为面向 professional knowledge work 的最强模型系列。按照官方说明,GPT‑5.2 更擅长创建 spreadsheets、构建 presentations、写代码、理解图像、处理长上下文、使用工具,以及完成复杂多步骤项目。
OpenAI 引用了 ChatGPT Enterprise 用户数据作为背景:平均用户表示 AI 每天节省 40 到 60 分钟,重度用户每周节省超过 10 小时。GPT‑5.2 的目标,是让这类经济价值进一步扩大。
GDPval 显示专业任务能力显著提升
OpenAI 在发布中提到,GPT‑5.2 在 GDPval 上达到新的 state of the art。GDPval 是衡量 44 个职业中 well-specified knowledge work tasks 的评估。GPT‑5.2 Thinking 在 GDPval 中赢或打平顶级行业专业人士的比例达到 70.9%。
这说明 GPT‑5.2 的定位不是只面向聊天、写作或代码,而是覆盖更广泛的经济价值任务。专业知识工作往往需要理解上下文、遵守约束、使用工具、处理数据,并产出可交付材料。
OpenAI 在同一部分还列出多个合作伙伴反馈:Notion、Box、Shopify、Harvey 和 Zoom 观察到 GPT‑5.2 在 long-horizon reasoning 和 tool-calling 上表现强;Databricks、Hex 和 Triple Whale 认为它适合 agentic data science 和 document analysis;Cognition、Warp、JetBrains、Augment Code 等则强调它在 agentic coding 方面的提升。
长上下文支持更复杂的文档和项目分析
GPT‑5.2 Thinking 在 long-context reasoning 上也被 OpenAI 单独强调。原文称,它在 OpenAI MRCRv2 上达到新的领先表现,这项评估测试模型能否整合长文档中分散的信息。
OpenAI 特别提到,GPT‑5.2 是其看到的首个在 4-needle MRCR variant 中接近 100% 准确率的模型,范围达到 256k tokens。
这对专业工作很关键。真实任务往往不是短问题,而是长报告、合同、研究论文、会议记录、多文件项目和跨来源材料。模型如果不能在长上下文中保持准确,就很难承担深度分析、综合和复杂多来源工作流。
工具调用让模型更接近执行
GPT‑5.2 的专业工作能力还体现在 tool calling 上。OpenAI 将它定位为更适合 complex, real-world tasks end-to-end 的模型,而不是只给出文本建议。
专业工作往往需要模型调用工具、分析数据、创建文档、生成表格、构建演示、读取图像、处理长文本,并在多个步骤之间保持目标一致。工具调用能力越强,模型越能从“告诉用户怎么做”转向“帮助用户实际完成”。
这也是 GPT‑5.2 与 professional work 绑定的原因。对于企业用户,价值不只在生成一段文字,而在于能否把原始材料加工成可靠的交付物。
安全和可用性是专业场景的前提
OpenAI 在发布中也设置了 Safety 和 Availability & pricing 部分。对于面向专业知识工作和企业部署的模型来说,安全、价格和命名规则都不是附属信息,而是决定是否能进入日常工作流的前提。
专业场景中,模型可能处理合同、财务、医疗、研发、客户材料和内部文档。越是高价值任务,越需要用户对输出进行核查,并需要组织设置权限、数据边界和审查流程。
OpenAI 在 factuality 部分也提醒,GPT‑5.2 仍然不完美,关键事项需要 double check。这一点对专业工作尤其重要:模型能力越强,越容易被用于高影响决策,越需要保留人工验证。
这次发布的实际看点
GPT‑5.2 的核心变化,是把模型能力集中到真实专业工作:表格、演示、代码、视觉、长上下文、工具调用和复杂多步骤项目。这让它不只是聊天模型升级,而更像面向企业和个人高价值工作的生产力基础模型。
对用户来说,后续真正值得观察的是 GPT‑5.2 在真实工作中的稳定性:能否准确处理长文档,能否可靠生成表格和演示,能否在多步骤任务中正确使用工具,能否减少事实错误,并在关键任务中让用户保持足够控制。
参考来源
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 17GB对100GB:Qwen3.8-27B与Flash-Next做同一批任务,省下的容量换来了什么?
同做89项终端任务,17GB的27B首轮完成35项,100GB的Flash-Next完成45项;最多两次是46对53,最多四次是48对60。本文追到9月13日后续结果,区分模型能力、环境故障和返工时间;测试为苹果MLX四位量化,不是GSQ-RCO IQ3_S,也不能套到16GB显卡。
 Qwen3.8-Flash-Next每秒70词元?本地加速之前,先看模型究竟改了什么
同样叫Flash-Next,70词元/秒背后可能是另一条计算路径:每词元激活专家从10减到5,再训练共享专家补偿。本文对照单台DGX Spark的两套原始资料,拆开量化、MTP、输入速度、输出速度和并发吞吐,不把128GB统一内存结果套到16GB显卡。
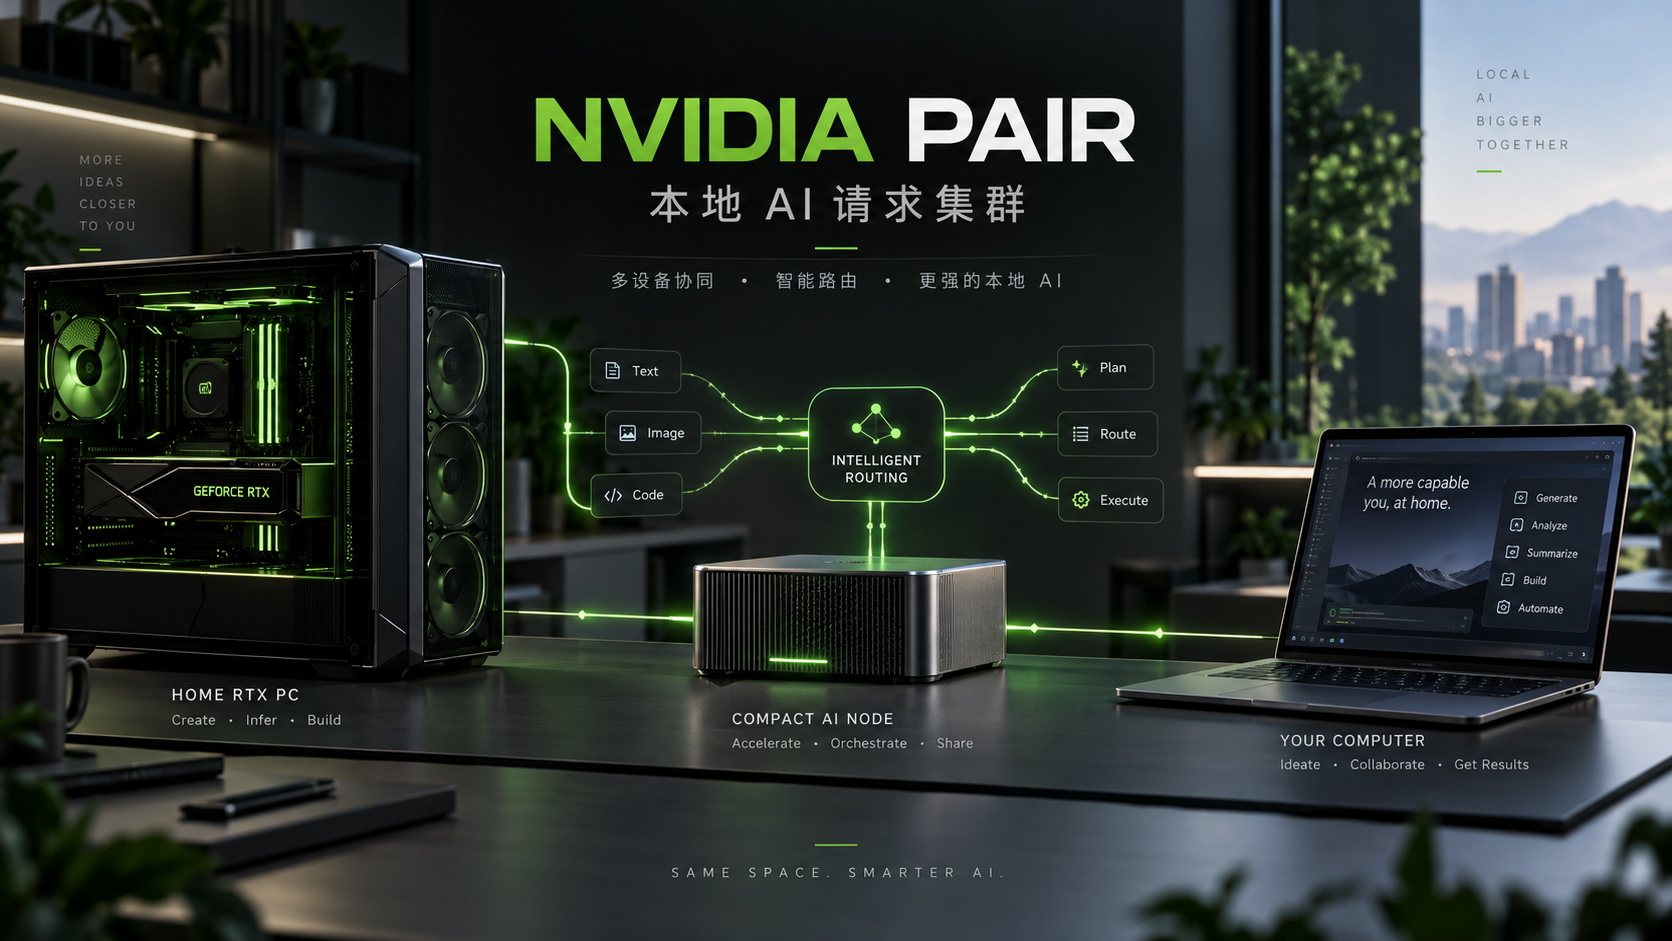 NVIDIA PAIR:把家里的 RTX、DGX Spark 和 Mac 变成本地 AI 请求集群,但它不是“显存池化”
可以把 NVIDIA PAIR 理解成家里本地 AI 的“派单前台”:RTX 主机、DGX Spark、Mac 就像几名能力不同的员工,PAIR 看谁在线、谁装了对应模型、谁现在最空闲,就把下一份 AI 工作交给谁。它特别适合多 Agent 并发,但不会把 16GB + 24GB 显存拼成 40GB,也不会把一个大模型拆到多台机器上。