
OpenAI 把 Codex 从代码工具扩展到多岗位工作流
OpenAI 发布面向不同角色和工具链的 Codex 更新,插件、Sites 和批注能力让 Codex 更像一个跨岗位工作代理。

OpenAI 扩展 Codex:从代码工具走向多角色、多工具、多工作流代理
OpenAI 在 “Codex for every role, tool, and workflow” 中介绍 Codex 的新方向。按照标题和草稿来源,这次更新不再把 Codex 只放在“程序员写代码”的单一场景里,而是强调不同角色、工具和工作流都可以使用 Codex 来推进任务。
这条动态的重点,是 Codex 的定位正在从 coding assistant 扩展为更广义的 work agent。它仍然以代码和工程任务为核心,但使用范围正在外延到产品、设计、文档、测试、运营和跨工具协作。
Codex 的定位正在外扩
早期 Codex 更容易被理解为代码生成或编程辅助工具。用户给出需求,模型生成代码、解释错误、修改文件或协助调试。随着 agent 能力增强,Codex 能处理的任务开始从单个代码片段转向完整工作流。
如果 Codex 面向 “every role”,它需要理解的不只是代码语法,还包括角色目标。产品经理关注需求、验收标准和交付风险;设计师关注界面、体验和规范;测试人员关注用例、边界和回归;开发者关注实现、架构、性能和维护。
这意味着 Codex 的能力不再只是“会写代码”,而是要能在不同角色的上下文中理解任务,并把任务转化为可执行步骤。
多工具接入决定它能走多远
OpenAI 这类更新通常会把 Codex 放进工具链中,而不是只让它停留在聊天框里。一个能处理真实工作流的 Codex,需要连接仓库、编辑器、任务管理、文档、终端、浏览器、测试框架和部署环境。
多工具接入让 Codex 可以从“回答如何做”变成“实际去做”。例如,它可以根据需求修改代码,读取文档,运行测试,解释失败原因,生成变更摘要,甚至为不同角色准备交付材料。
但工具越多,边界也越重要。Codex 需要知道哪些文件可以改,哪些命令可以执行,哪些环境不能碰,哪些操作必须让用户确认。这是它从个人 coding helper 走向团队工作代理时必须补齐的控制面。
跨岗位工作流比单次生成更重要
多角色 Codex 的实际价值,不在于让每个人都问同一个模型,而在于让一个项目中的不同任务可以被连续处理。
例如,一个产品需求可以先转化为验收清单,再生成技术计划,再修改代码,再运行测试,再整理发布说明。这条链路里涉及产品、开发、测试和文档。Codex 如果能在不同阶段保持上下文,并使用不同工具推进任务,就会比单次代码生成更接近真实项目协作。
这也是 “workflow” 这个词的重要性。工具只解决入口问题,workflow 解决的是任务如何被拆解、执行、验证和交付。
这次更新的实际看点
Codex 从代码工具扩展到多角色、多工具、多工作流,说明 AI 编程工具正在变成更广义的项目执行代理。它不再只是 IDE 里的补全功能,而可能成为连接需求、代码、测试、文档和交付的中间层。
对团队来说,采用 Codex 时更应该关注任务边界和验证机制。让 Codex 写代码只是第一步;真正进入工作流后,还需要明确输入文档、修改范围、测试命令、审查规则、回滚方式和最终责任。
如果这些控制机制足够清楚,Codex 这类工具可以帮助团队把重复开发流程、文档同步、代码审查准备和测试反馈处理变得更连续。但如果缺少边界,它也可能让错误更快进入项目。
参考来源
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 17GB对100GB:Qwen3.8-27B与Flash-Next做同一批任务,省下的容量换来了什么?
同做89项终端任务,17GB的27B首轮完成35项,100GB的Flash-Next完成45项;最多两次是46对53,最多四次是48对60。本文追到9月13日后续结果,区分模型能力、环境故障和返工时间;测试为苹果MLX四位量化,不是GSQ-RCO IQ3_S,也不能套到16GB显卡。
 Qwen3.8-Flash-Next每秒70词元?本地加速之前,先看模型究竟改了什么
同样叫Flash-Next,70词元/秒背后可能是另一条计算路径:每词元激活专家从10减到5,再训练共享专家补偿。本文对照单台DGX Spark的两套原始资料,拆开量化、MTP、输入速度、输出速度和并发吞吐,不把128GB统一内存结果套到16GB显卡。
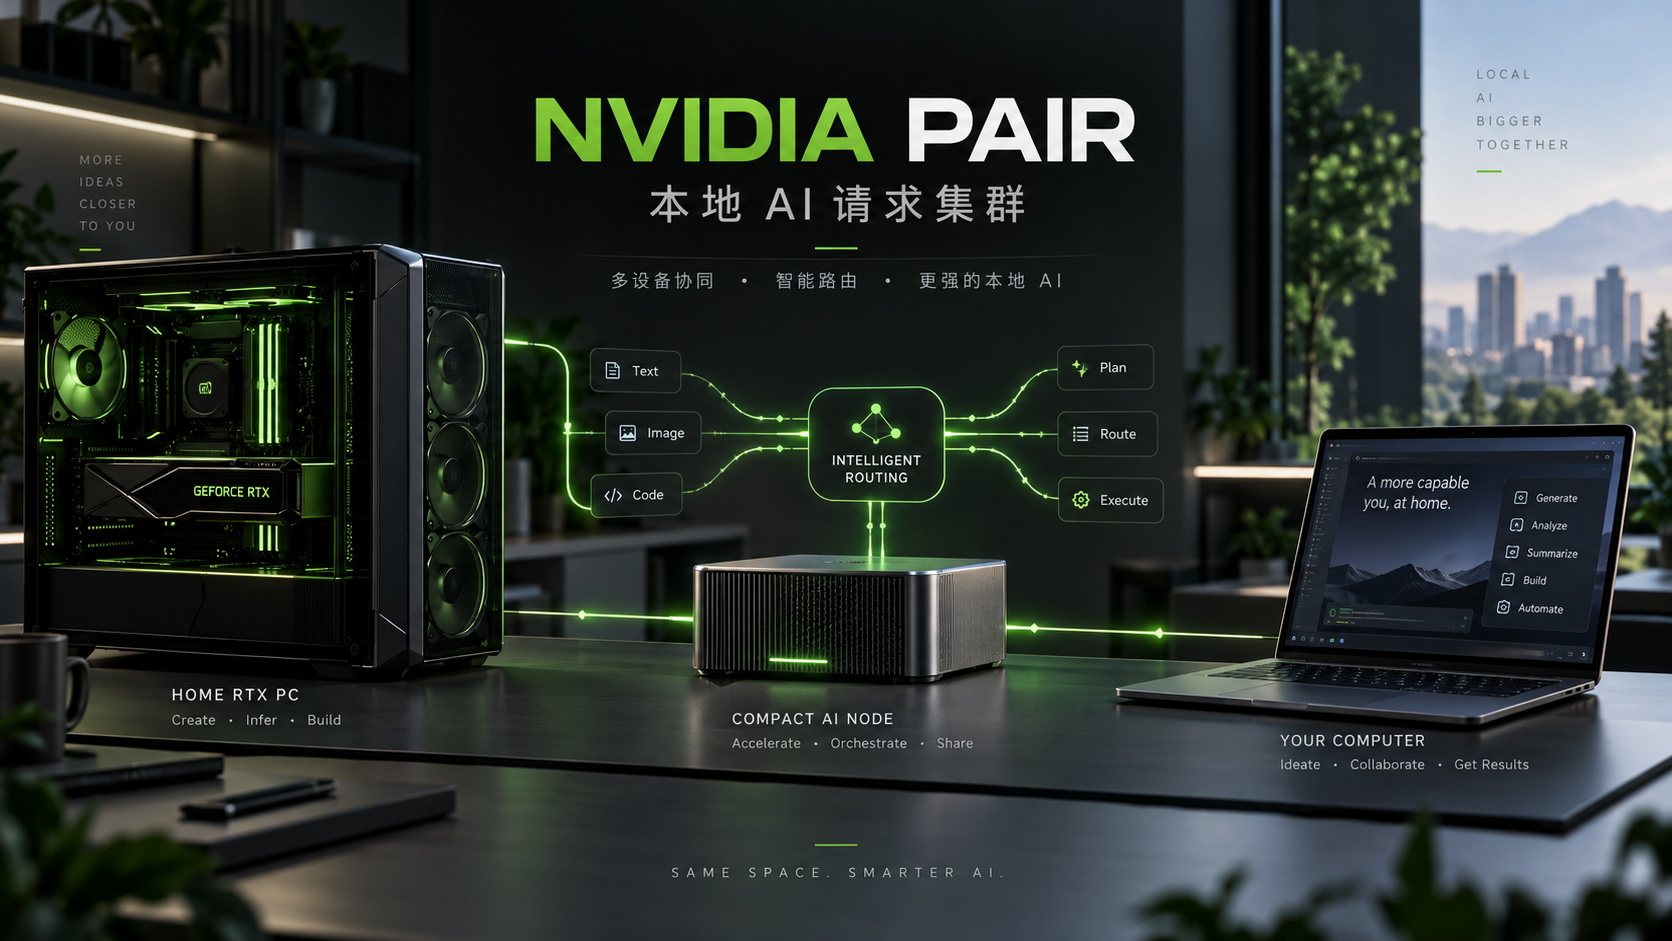 NVIDIA PAIR:把家里的 RTX、DGX Spark 和 Mac 变成本地 AI 请求集群,但它不是“显存池化”
可以把 NVIDIA PAIR 理解成家里本地 AI 的“派单前台”:RTX 主机、DGX Spark、Mac 就像几名能力不同的员工,PAIR 看谁在线、谁装了对应模型、谁现在最空闲,就把下一份 AI 工作交给谁。它特别适合多 Agent 并发,但不会把 16GB + 24GB 显存拼成 40GB,也不会把一个大模型拆到多台机器上。