NVIDIA Nemotron 3.5 Lightning:开源 30B MoE 模型定位长时运行 Agent 的执行层
NVIDIA 于 2026-08-11 发布 Nemotron 3.5 Lightning,一个约 30B 总参数、3B 激活的开源 MoE 模型,专为长时运行 Agent 的高频执行层设计:工具调用、结果校验与子 Agent 委派。模型配 MTP/DFlash/DSpark 投机解码与 NVFP4/BF16 量化,配合 NeMo Switchyard 做模型路由,可在 DGX Spark、RTX 5090 与数据中心本地部署。
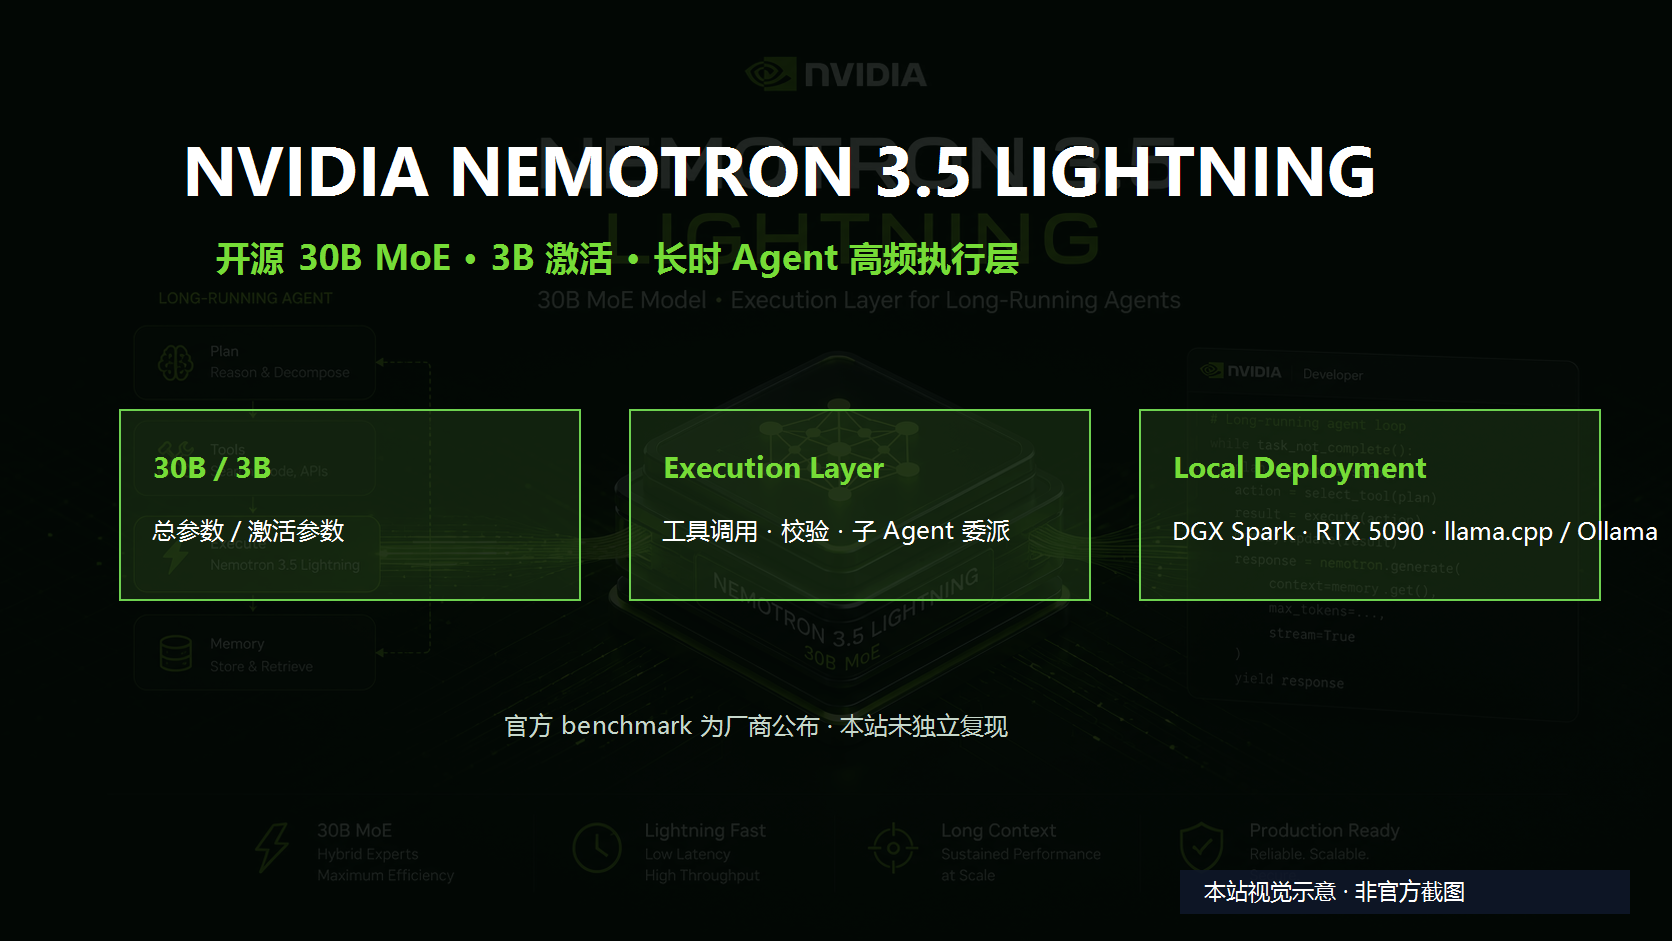
2026 年 8 月 11 日,NVIDIA 在 开发者博客 发布了 Nemotron 3.5 Lightning,一个约 30B 总参数、3B 激活参数的开源 MoE 模型。它的定位很明确:长时运行 AI Agent 的高频执行层。官方指出,长时 Agent 的大部分时间花在高频执行上——工具调用、结果校验和子 Agent 委派;如果每一步都用前沿推理模型处理,成本和延迟都会过高。Nemotron 3.5 Lightning 就是为这类执行型工作设计的。
为什么长时 Agent 需要专门的执行层模型
长时运行 Agent 的典型负载是大量重复的、低延迟的执行动作,而不是单次高难度的推理。NVIDIA 官方用它对接 OpenClaw、Hermes Agent 等 harness,并配套了 NemoClaw 开源安全与管理栈来运行 always-on 智能体。在这种「系统化多模型」架构里,前沿推理模型负责编排与复杂规划,而更小、更高效的模型负责高频执行层。Nemotron 3.5 Lightning 就承担后者,它负责处理 git pull、校验工具输出、格式化结果以及长时 Agent 里占 token 预算的常规调用。
30B MoE 与 3B 激活的设计
Nemotron 3.5 Lightning 是 Nemotron 3 模型家族里最小的成员。MoE 架构通过路由器把每个 token 只发送给少数专家,因此每次推理实际只运行模型参数的一小部分,用较小的计算成本获得接近大稠密模型的能力。官方称这是「以小型模型的计算成本获得大型稠密模型的能力」。它支持从 DGX Spark 到数据中心的各种部署环境,并加入了与 Nemotron 3 Super、Ultra 一致的推理优化技术。
速度来源:投机解码与量化
速度是这款模型的卖点。Nemotron 3.5 Lightning 在训练阶段就加入了多 token 预测(MTP),并附带了 DSpark 与 DFlash 两个草稿模型:DSpark 适合 DGX Spark 推理与低并发数据中心负载,MTP 适合中高并发场景,DFlash 则可在 Blackwell 上最高提升 15 倍推理性能。官方称它在同尺寸模型中输出速度最高可达 4 倍,同时保持领先精度,在 Artificial Analysis Intelligence Index 上占据「精度—速度」Pareto 前沿。量化方面,它提供 NVFP4 与 BF16 两种 checkpoint,NVFP4 与 Nemotron 3 Ultra 共用同样的低精度 kernel,覆盖 Blackwell、Hopper 与 Ampere GPU。
本地部署与开源许可
Nemotron 3.5 Lightning 强调本地 AI 能力,可在 NVIDIA Jetson、GeForce RTX 5090 与 DGX Spark 上运行,并支持 LM Studio、llama.cpp、Ollama、Unsloth 等主流工具。与既往 Nemotron 开放模型一致,本次发布按 OpenMDW-1.1 许可开放权重、训练数据与 recipe,可用 LoRA 或全量 SFT 微调,或用 NeMo RL、NeMo Gym 做强化学习与评估。官方还发布了用于编码 Agent 能力训练的开放 RL 数据集 Nemotron-RL Agentic Terminal Pivot。
用 NeMo Switchyard 做模型路由
配合 NeMo Switchyard,Nemotron 3.5 Lightning 可以作为一个路由目标,与开源、闭源模型并存。路由策略是「规划上抬到前沿模型,执行下放到 Lightning」:用户请求按复杂度派发到最合适且最经济的模型,从而更高效地使用 token 预算。例如,复杂规划交给 Nemotron 3 Ultra,常规执行交给 Lightning。
生态与接入方式
Nemotron 3.5 Lightning 生态覆盖后训练(AgileRL、ReasonabLe、Thinking Machines Lab 等)、推理软件(Ollama、LM Studio、Unsloth、Canonical)、harness 与 Agent 框架(OpenClaw、OpenCode、LangChain、Cline、Kilo Code 等)以及云服务商平台(SageMaker JumpStart、Google Cloud、MSFT Foundry 等)。开发者可从 build.nvidia.com 在线试用,或从 Hugging Face 下载权重自行部署。需要说明的是,官方所有基准均为厂商公布,未做独立复现;读者在替换生产模型前,仍应使用自己的 Agent 任务集验证任务完成率、延迟与 token 成本。
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 Kimi K3.1 Pro:跑分逼近 Opus 5.5,白模能变成动画吗?
终端任务与Opus只差0.7个百分点,科学任务却仍有明显距离。结合官方游戏、3D网页和Blender白模案例,拆解Kimi、三维软件与视频模型的分工,并给出可访问的试玩入口。
 71 个 Agent 真会一起干活?ECC 给 Codex 加了什么
ECC的71份Agent定义和311个技能怎样进入Codex?从CSV导出的一次交付拆解规划、验证、Hooks与记忆,核对原生插件和旧同步路径,讲清目录规模、安装成功与任务效果的区别。
 Codex 总在翻整份代码?Serena 能让它少走多少弯路
Serena能按函数和引用关系为Codex取代码,但“省90% token”缺少统一对测依据。结合官方案例,看默认LSP与JetBrains后端的能力差异、接入步骤,以及哪些任务原生工具更省事。