
Kimi K3 开放了什么:从模型代码到 Vendor Verifier 的生态清单
Kimi K3 的开放资产不止权重:Hugging Face 提供模型与处理代码,技术报告解释架构和训练方法,vLLM、SGLang、TokenSpeed 给出部署适配,Vendor Verifier 则检查参数、工具调用、K3 特性和 prompt token。它们提高了可部署与可验证性,但仍不等于训练数据、完整训练代码或独立复现已经公开。

Kimi K3 在 2026 年 7 月 27 日开放完整权重后,真正值得检查的不只是“能否下载”,而是围绕模型形成了哪些可用、可读和可验证的公开资产。MoonshotAI/Kimi-K3 官方仓库把权重、技术报告、部署入口与使用约定连在一起;另一个官方仓库 Kimi Vendor Verifier 则尝试让不同推理服务的接口行为可以用同一套检查项对照。
这套开放生态提高了外部团队部署和排错的起点,但不能被概括成“训练全栈已开源”。权重、加载代码、推理引擎适配、验证工具、技术报告、训练代码、训练数据和独立复现是七类不同证据。
Hugging Face 公开的是权重,也包含模型与处理代码
Kimi K3 的 Hugging Face 文件树显示 1.56TB 模型资产和 96 个 safetensors 权重分片,同时提供 configuration_kimi_k3.py、modeling_kimi_k3.py、modeling_kimi_linear.py、tokenization_kimi.py、kimi_k3_processor.py、视觉处理和媒体工具等文件。
这些文件说明外部推理框架不是只能面对一个黑盒 checkpoint:它们可以读取架构配置、加载模型、处理 tokenizer 和多模态输入。这里的“自定义代码”主要服务模型定义、加载与输入处理,不能直接等同于完整训练管线。
官方 GitHub 仓库还提供 README、许可证和技术报告 PDF,并明确推荐 vLLM、SGLang 与 TokenSpeed 三条推理入口。对于准备接入 K3 的平台团队,这些公开资产至少让“模型是什么、文件在哪里、按什么输入输出约定服务”有了统一事实源。
技术报告解释方法,但不是可执行训练复现包
arXiv 技术报告于 7 月 27 日提交,说明 K3 是 2.8T 总参数、104B 激活参数的 MoE 模型,结合 Kimi Delta Attention、Attention Residuals、Stable LatentMoE、原生视觉和 100 万 token 上下文,并描述训练、强化学习和系统协同设计方法。
报告的价值是公开架构选择、训练思路、基础设施方法与评估设置,让外部研究者能审查厂商叙事,并将实现与论文描述对照。但论文不是数据集,也不是可直接执行的端到端训练仓库。
截至本次核验,Kimi K3 GitHub 与 Hugging Face 文件树没有显示完整训练流水线、训练数据清单或从原始数据到最终 checkpoint 的复现脚本。因此,训练数据是否完整公开、训练代码能否独立复现 K3,均应写为 unknown;不能用“论文已发布”替代这些证据。
vLLM、SGLang 与 TokenSpeed 解决的是部署适配
vLLM 官方 K3 recipe给出 K3 专用镜像、CUDA/驱动要求、至少 8 张 GB300 或 8 张 MI350X/MI355X 的硬件起点,以及跨节点通信和 MoE backend 建议。文档还提醒 K3 偶尔可能输出自身 parser 不期望的工具调用格式,建议做 schema 验证并重试。这说明“框架支持”不仅是权重能加载,还包括多节点、模型 runner、视觉输入和工具调用的兼容细节。
SGLang K3 cookbook覆盖 NVIDIA 与 AMD 多种拓扑、并行策略、KDA/MLA 状态内存和推理特性。它同时明确标注:部分最终权重与当前代码组合仍需重新测量,团队应在自己的吞吐、上下文与准确性目标上复核,而不是把文档命令当成生产验收结果。
TokenSpeed 的 K3 recipe进一步记录 FlatKV、KDA kernel、reasoning/tool-call parser、模型文件展开方式和 NVIDIA/AMD 路径;文档特别指出 Hugging Face snapshot 的符号链接布局可能影响自定义 tokenizer 导入,并说明部分 KV scaling 或平台构件的限制。这类说明属于部署适配证据,不是 Moonshot 对所有硬件组合的性能保证。
本站没有安装或运行上述框架,也没有下载 1.56TB 权重。三条文档能证明社区主流推理栈已有明确接入路径,不能证明任意硬件、任意版本都能无修改上线。
Vendor Verifier 把“兼容”拆成可检查的接口契约
MoonshotAI/Kimi-Vendor-Verifier不只是排行榜脚本。它把接入前检查拆成四类 pytest 套件:
- 参数约束:检查
temperature、top_p、presence/frequency penalty、n等固定或受限参数是否按约定处理。 - 工具调用 JSON Schema:让服务接收指定工具参数 schema,强制触发工具调用,并在本地验证返回的
function.arguments。 - K3 特性:检查 dynamic tools、
response_format、tool_choice与 thinking effort 等接口行为。 - prompt token:用固定文本和视觉样例,对照供应商返回的
usage.prompt_tokens是否符合预期常量。
仓库还包含 OCRBench、MMMU Pro Vision、BEAM 1M 和 DeepSWE 等评估入口,并列出多家供应商提交结果。这里必须区分两层:公开测试代码提高了测试方法的可见性;表中的供应商成绩仍是官方维护仓库里的提交结果,不等于本站或独立第三方已经复现。
Vendor Verifier 的实际价值,是让团队在跑成本高昂的正式 benchmark 前,先验证 API 参数、工具调用、K3 专属能力和计费相关 token 统计。它不能替代应用层质量评测、安全审计、许可证审查或生产容量测试。
一张开放资产清单,避免把不同证据混为一谈
| 资产 | 当前可核验状态 | 能证明什么 | 不能证明什么 |
|---|---|---|---|
| 完整模型权重 | 已公开 | 可取得 checkpoint,自行部署或研究 | 普通硬件可运行 |
| 模型/处理代码 | 已公开 | 可加载模型并处理文本、视觉输入 | 完整训练管线已公开 |
| 技术报告 | 已公开 | 架构、训练方法与评估有文档说明 | 训练结果可独立复现 |
| vLLM/SGLang/TokenSpeed 适配 | 已公开 | 有具体部署路径和兼容说明 | 所有组合已生产验收 |
| Vendor Verifier | 已公开 | API 合同和部分评估可重复执行 | 供应商结果已被本站独立复测 |
| 完整训练代码 | unknown | — | 不能据许可证或论文推断已发布 |
| 训练数据与完整数据清单 | unknown | — | 不能据开放权重推断可追溯 |
因此,Kimi K3 的开放生态已经超过“只扔出一个权重文件”:它同时给出加载代码、技术说明、推理适配和供应商验证入口。准确表述仍应是 open-weight 模型及其开放推理/验证生态,而不是完整开源训练全栈。
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 17GB对100GB:Qwen3.8-27B与Flash-Next做同一批任务,省下的容量换来了什么?
同做89项终端任务,17GB的27B首轮完成35项,100GB的Flash-Next完成45项;最多两次是46对53,最多四次是48对60。本文追到9月13日后续结果,区分模型能力、环境故障和返工时间;测试为苹果MLX四位量化,不是GSQ-RCO IQ3_S,也不能套到16GB显卡。
 Qwen3.8-Flash-Next每秒70词元?本地加速之前,先看模型究竟改了什么
同样叫Flash-Next,70词元/秒背后可能是另一条计算路径:每词元激活专家从10减到5,再训练共享专家补偿。本文对照单台DGX Spark的两套原始资料,拆开量化、MTP、输入速度、输出速度和并发吞吐,不把128GB统一内存结果套到16GB显卡。
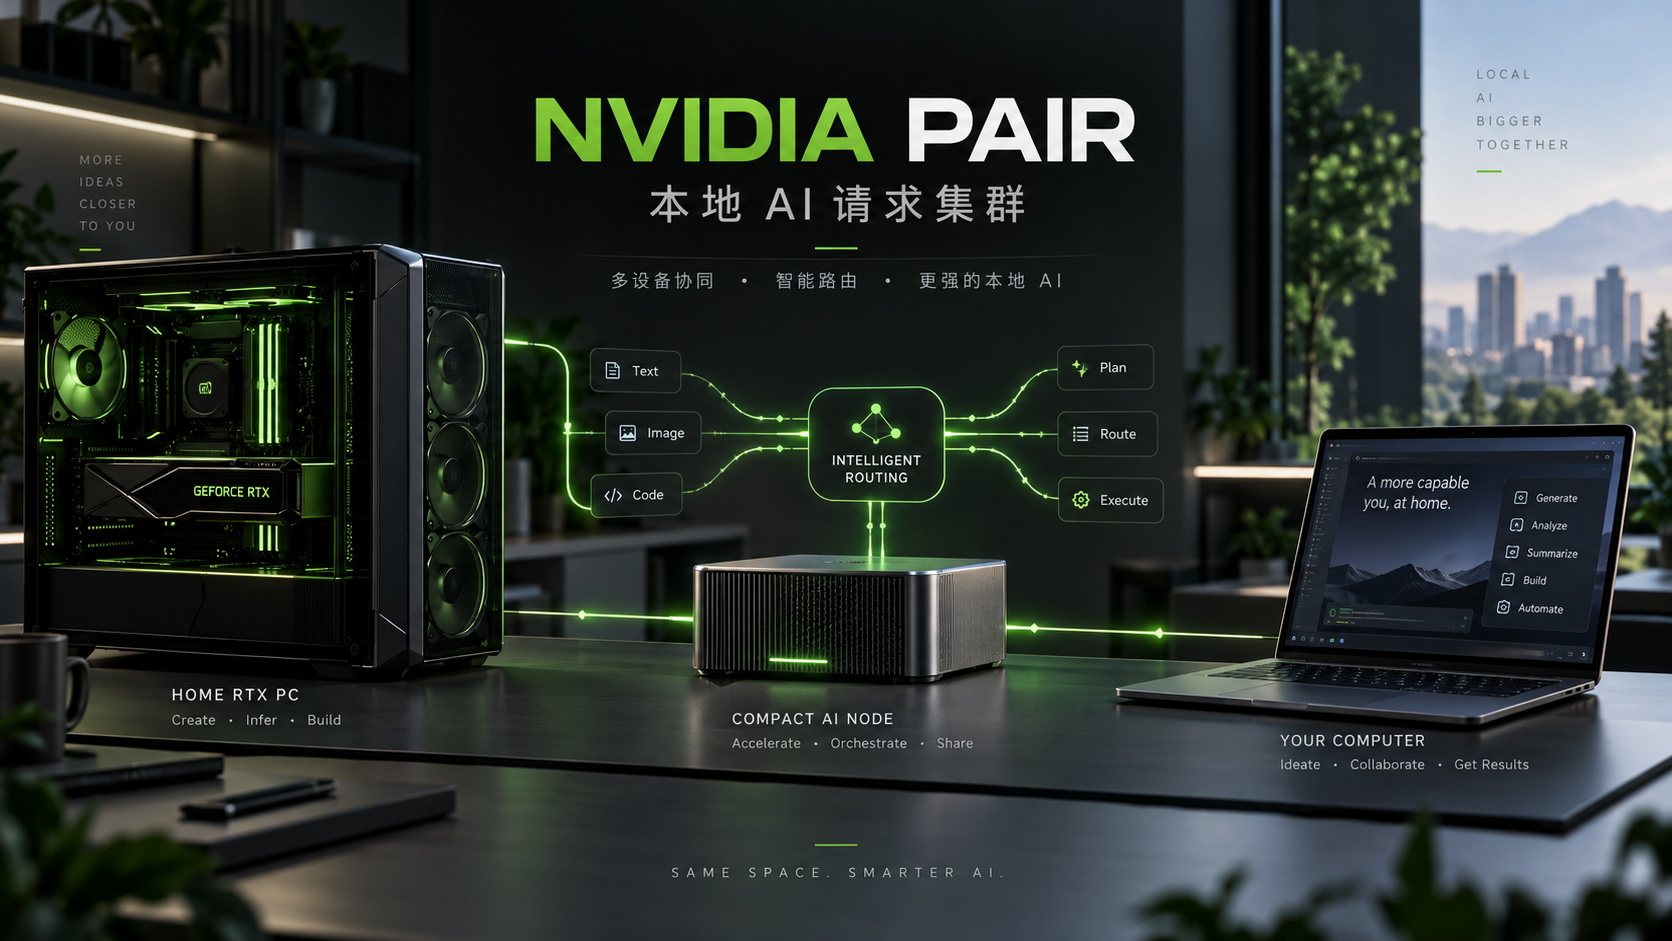 NVIDIA PAIR:把家里的 RTX、DGX Spark 和 Mac 变成本地 AI 请求集群,但它不是“显存池化”
可以把 NVIDIA PAIR 理解成家里本地 AI 的“派单前台”:RTX 主机、DGX Spark、Mac 就像几名能力不同的员工,PAIR 看谁在线、谁装了对应模型、谁现在最空闲,就把下一份 AI 工作交给谁。它特别适合多 Agent 并发,但不会把 16GB + 24GB 显存拼成 40GB,也不会把一个大模型拆到多台机器上。