Hugging Face 与 Cerebras 展示实时语音 AI:开放语音栈开始追求低延迟对话体验
Hugging Face 与 Cerebras 展示了基于开放模块的 speech-to-speech 语音 AI 栈,把 Parakeet 语音识别、Gemma 4 VLM、Cerebras 推理和 Qwen3TTS 串成低延迟对话链路。它说明语音 Agent 的竞争正在从能说话转向响应速度和开放组合。
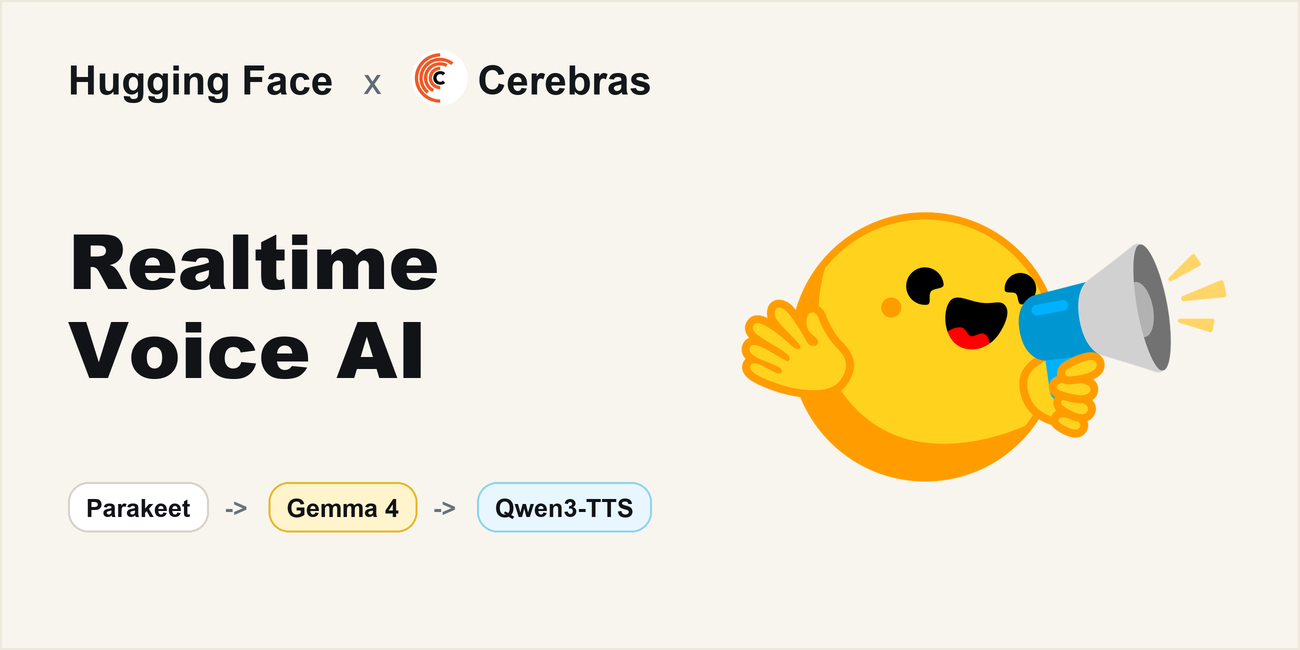
Hugging Face 在 7 月 1 日发布文章,介绍它与 Cerebras 展示的实时 speech-to-speech 语音 AI 体验。这个案例不只是“让模型开口说话”,而是把低延迟、开放模块和机器人交互放在一起,说明语音 Agent 的竞争点正在变化。
很多语音助手能听懂,也能回答,但用户真正感受到的往往是等待时间。只要中间有几秒停顿,对话就会从自然交流变成排队等机器处理。Hugging Face 这篇文章把 latency 放到核心位置,是一个很现实的判断。
开放的级联式 speech-to-speech 架构
文章展示的 demo 是一个实时语音到语音 pipeline,每一层都可替换。整体链路是:
- 语音输入。
- 使用 NVIDIA Parakeet 做语音识别。
- 在 Cerebras 上运行 Gemma 4 VLM 推理。
- 使用 Alibaba Qwen3TTS 做文本转语音。
- 输出语音回复。
这个结构的关键不是某一个模型,而是“开放且模块化”。开发者可以替换识别模型、语言模型、推理服务或 TTS 模型,让语音 Agent 更容易适配机器人、产品、研究项目和企业场景。
Cerebras 解决的是长尾延迟问题
Hugging Face 文章明确指出,很多生产系统的中位数延迟看起来可以接受,但 P95 上的多秒延迟仍然会让用户感到卡顿。一旦语音对话还要叠加工具调用、多模态理解或多轮交互,慢响应会更加明显。
Cerebras 在这个链路里的价值,是把语言模型响应时间压低并变得更稳定。对语音 Agent 来说,稳定的低延迟不是锦上添花,而是体验的基础。如果系统有时很快、有时突然停几秒,用户会很难建立信任。
这也解释了为什么推理基础设施正在成为 AI 产品竞争的一部分。模型质量重要,但真实产品还要回答另一个问题:能不能在用户说完话之后快速、稳定、自然地接上。
已经接入 Reachy Mini 机器人场景
文章提到,这套 Hugging Face speech-to-speech pipeline 已经用于 Reachy Mini 机器人,并且有超过 9000 台机器人在野外使用。这个细节让它不只是一个网页 demo,而是更接近 embodied AI 和真实交互产品。
机器人、语音助手和可穿戴设备的共同特点,是交互节奏很敏感。网页聊天可以等几秒,语音对话不能总是等几秒;机器人如果反应慢,也会显得机械和不可靠。
因此这条前沿最值得看的不是某个模型名字,而是“语音 Agent 的产品指标”正在变得更具体:低延迟、长尾稳定、开放替换、可部署到真实设备。
对网站和个人工作流的启发
HelloAIFlow 最近也在优化文章朗读和 TTS 体验。这个来源对我们有直接启发:语音功能不能只看“有没有声音”,还要看响应是否快、是否可控、失败后是否有兜底。
如果未来个人站点、教育工具或办公助手都要加入语音 Agent,最稳的做法不是把所有能力绑死在一个闭源服务上,而是保留可替换的识别、推理和 TTS 层。这样当某个服务受限、变贵或不可用时,系统仍然能降级运行。
参考来源
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 Kimi K3.1 Pro:跑分逼近 Opus 5.5,白模能变成动画吗?
终端任务与Opus只差0.7个百分点,科学任务却仍有明显距离。结合官方游戏、3D网页和Blender白模案例,拆解Kimi、三维软件与视频模型的分工,并给出可访问的试玩入口。
 71 个 Agent 真会一起干活?ECC 给 Codex 加了什么
ECC的71份Agent定义和311个技能怎样进入Codex?从CSV导出的一次交付拆解规划、验证、Hooks与记忆,核对原生插件和旧同步路径,讲清目录规模、安装成功与任务效果的区别。
 Codex 总在翻整份代码?Serena 能让它少走多少弯路
Serena能按函数和引用关系为Codex取代码,但“省90% token”缺少统一对测依据。结合官方案例,看默认LSP与JetBrains后端的能力差异、接入步骤,以及哪些任务原生工具更省事。