
GLM-5.3:Z.ai 将后训练推向编码与安全能力,权重发布先经过两周加固
Z.ai 于 2026-08-14 发布 GLM-5.3:官方称其沿用 GLM-5.2 的基础模型,主要增益来自扩大后训练环境、任务多样性与计算投入。发布页同时披露了显著增强的漏洞发现能力,并将开放权重延后约两周,先完成安全评估和加固。本文区分厂商评测、已开放 API 能力与尚未开放的模型权重。
2026 年 8 月 14 日,Z.ai 发布 GLM-5.3 官方说明。这次更新最值得关注的并不只是又一个版本号:官方称 GLM-5.3 与 GLM-5.2 使用相同基础模型,能力提升主要来自继续扩大后训练的环境、任务多样性与计算投入。与此同时,Z.ai 披露模型在漏洞发现相关评测上的能力提升,并决定将开放权重的时间推迟约两周,以完成安全评估和加固。
这是一篇公开资料整理:文中的模型分数、漏洞数量和能力描述均为 Z.ai 的发布与评测口径,不等同于独立第三方复现,也不提供漏洞利用操作。
同一基础模型,重点放在后训练与任务环境
Z.ai 的发布页把 GLM-5.3 的变化概括为后训练扩展:在 GLM-5.2 已有的长上下文、长程任务训练栈之上,增加更多可执行环境、更丰富的任务类型和更多训练计算。官方特别强调,这一轮不是更换基础模型,而是继续放大后训练对编码与长期 Agent 任务的影响。官方发布说明 将这类环境描述为接近真实工程和研究工作:任务包含多步依赖、可验证结果与隐藏状态,而不仅是一次性的代码题。
这对 Agent 使用者有现实启发。长程任务的瓶颈常常不是“能不能写出一段代码”,而是能否在多轮计划、工具调用、调试和验收之间保持目标一致。模型训练环境越接近这种闭环,越可能提升端到端交付;但这仍不能替代团队自身的权限控制、测试和人工复核。
编码与 Agent 分数应按厂商评测条件阅读
Z.ai 报告 GLM-5.3 在多项编码和 Agent 基准上相较 GLM-5.2 有提高,例如 Terminal-Bench 3.0、DeepSWE 与 Agents' Last Exam。发布页同时公开了部分评测设置:例如 Terminal-Bench 3.0 使用 Claude Code harness、固定上下文与输出上限、隔离容器及官方独立验证器;不同基准的超时、轮数和聚合方式并不相同。官方评测脚注 因此比单个总分更值得阅读。
这意味着“领先”只能在对应基准、harness、推理档位和预算之内解释。它不能直接推出某个团队的仓库修复速度、成本、稳定性或安全性也会等比例提升。对打算试用 API 的团队,更可靠的路径是选取自己的非敏感任务,固定模型版本、工具权限、上下文长度和验收脚本,再对照现有工作流做小规模评估。
网络安全能力上升,公开权重被延后
Z.ai 在发布中称,随着后训练规模扩大,GLM-5.3 在漏洞发现及更深层安全评测上的表现增长明显。官方报告 CyberGym 为 84.5%,并同时披露了 ExploitBench、ExploitGym 等评测结果;这些都是厂商报告的受控评测数据,不能被理解为对任意真实系统的攻击能力承诺或独立安全审计结论。Z.ai 的安全能力说明与评测表 也列出模型比较和具体测试条件。
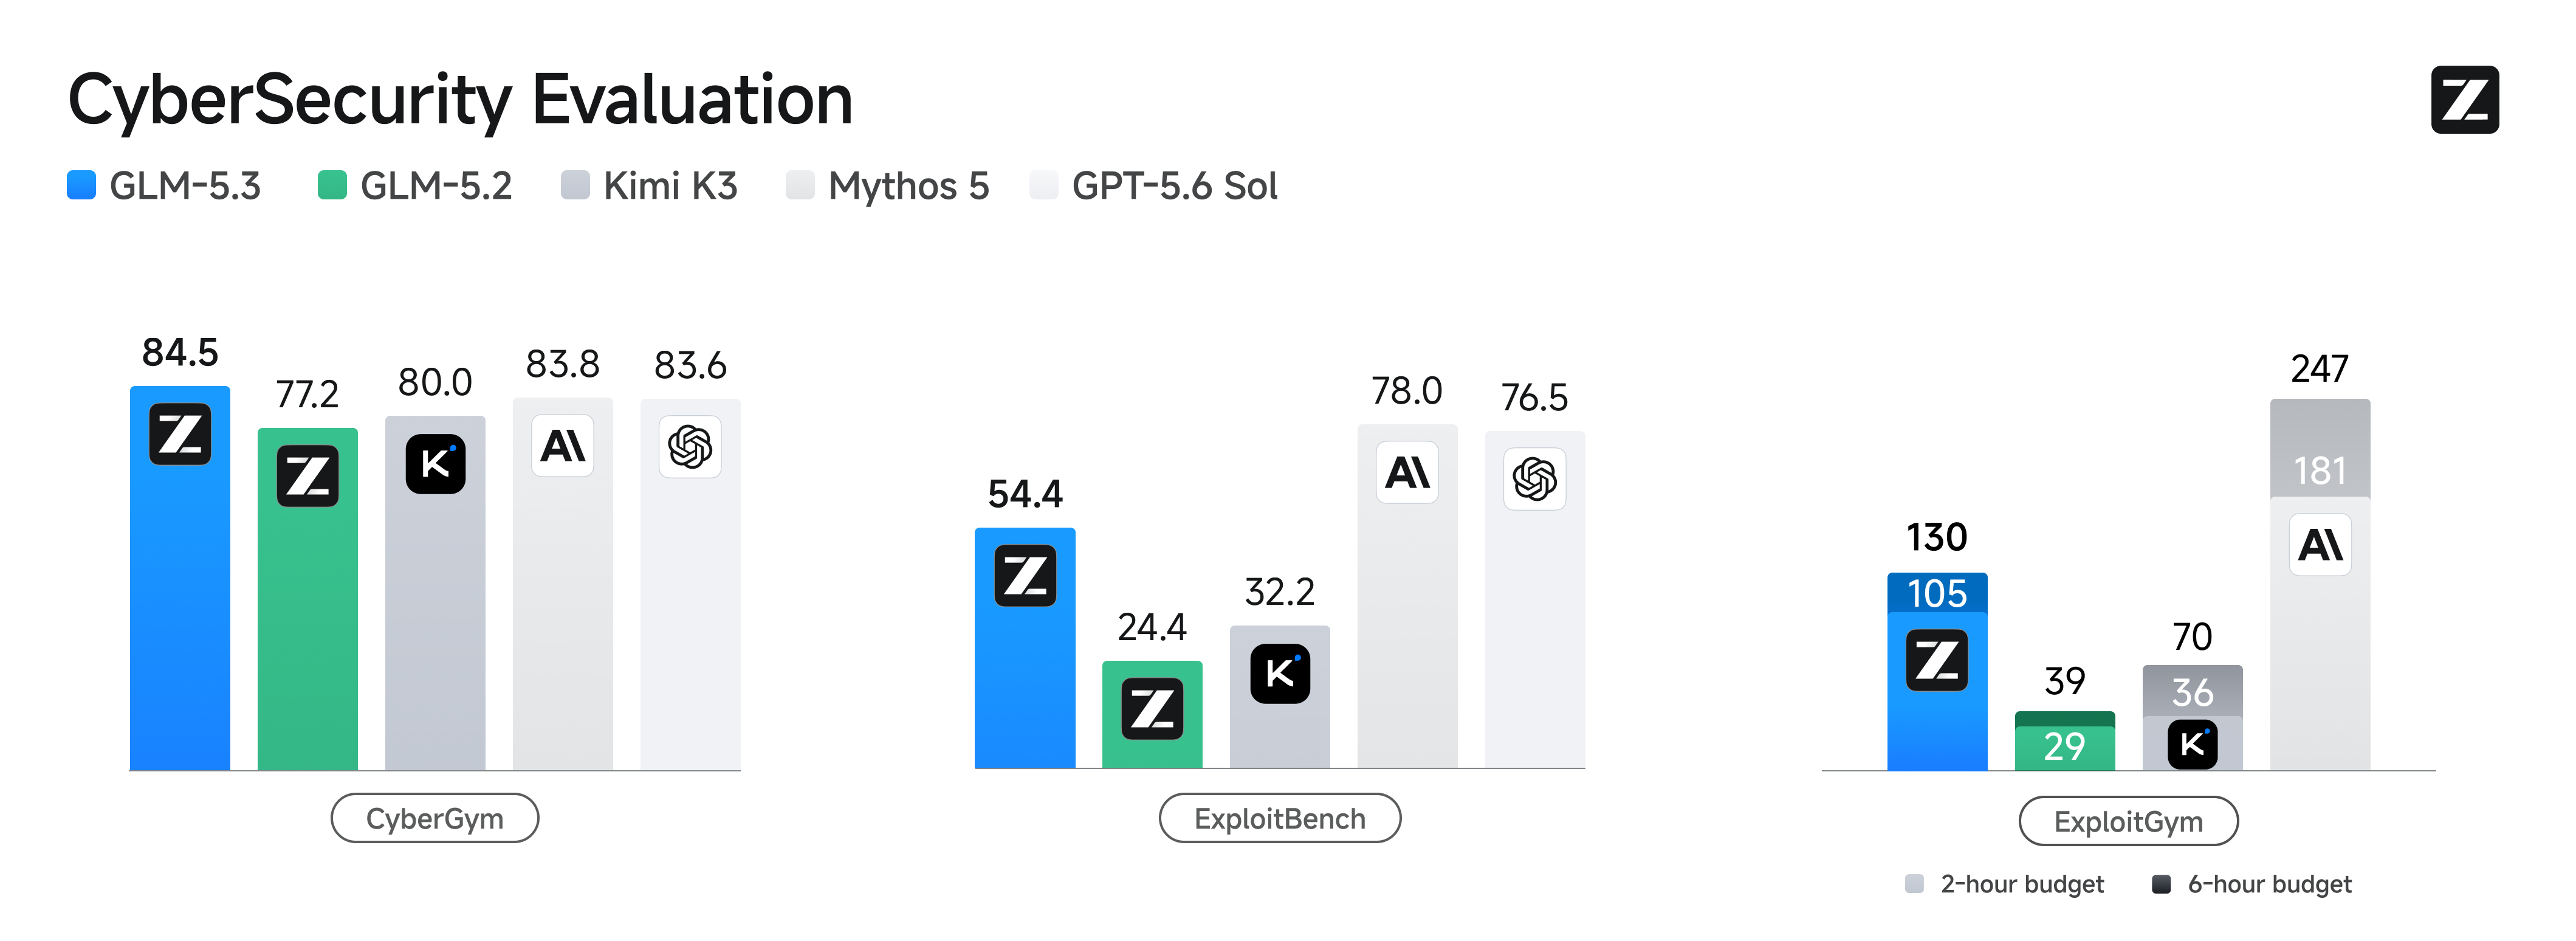
*图:Z.ai 官方发布页的网络安全评测图。它呈现的是厂商在给定配置和基准上的报告结果,而不是独立实测或可直接迁移到真实目标的能力证明。*
比数字本身更值得注意的是发布治理动作:官方表示,GLM-5.3 权重将在发布约两周后才公开,以便先完成安全评估和加固。对于开放权重模型,这种时间差并不能消除后续的滥用风险,但至少把“API 可用”与“任何人可下载并自行部署权重”两个阶段明确分开。Z.ai 还建立了 Security Disclosure Ledger 记录经审查后逐步公开的漏洞发现;台账是厂商披露机制的一部分,不应被解读为全部发现都已独立确认。
API 接入有迁移边界,不等同于权重可用
GLM-5.3 的官方说明列出 low、high、max 三档推理力度,并称不再支持关闭 thinking;对于旧调用,若仍传入 thinking.type: "disabled",需要按开发者文档迁移为启用 thinking 并设置对应的 reasoning_effort,否则请求会失败。官方还表示 Coding Plan 用户已可使用该模型,但这与将来公开权重、以及在本地运行所需的硬件和安全评估是不同问题。
因此,当前最稳妥的判断是:GLM-5.3 是一次值得跟踪的后训练与长程 Agent 能力更新,且安全能力变化已影响到发布节奏;但其各项领先分数仍需按官方条件阅读,开放权重尚未在发布当日可得。对普通开发团队,先评估 API 场景里的可靠性、成本和权限边界,再决定是否等待权重或调整既有工作流,比追逐“最强”标签更有操作价值。
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 17GB对100GB:Qwen3.8-27B与Flash-Next做同一批任务,省下的容量换来了什么?
同做89项终端任务,17GB的27B首轮完成35项,100GB的Flash-Next完成45项;最多两次是46对53,最多四次是48对60。本文追到9月13日后续结果,区分模型能力、环境故障和返工时间;测试为苹果MLX四位量化,不是GSQ-RCO IQ3_S,也不能套到16GB显卡。
 Qwen3.8-Flash-Next每秒70词元?本地加速之前,先看模型究竟改了什么
同样叫Flash-Next,70词元/秒背后可能是另一条计算路径:每词元激活专家从10减到5,再训练共享专家补偿。本文对照单台DGX Spark的两套原始资料,拆开量化、MTP、输入速度、输出速度和并发吞吐,不把128GB统一内存结果套到16GB显卡。
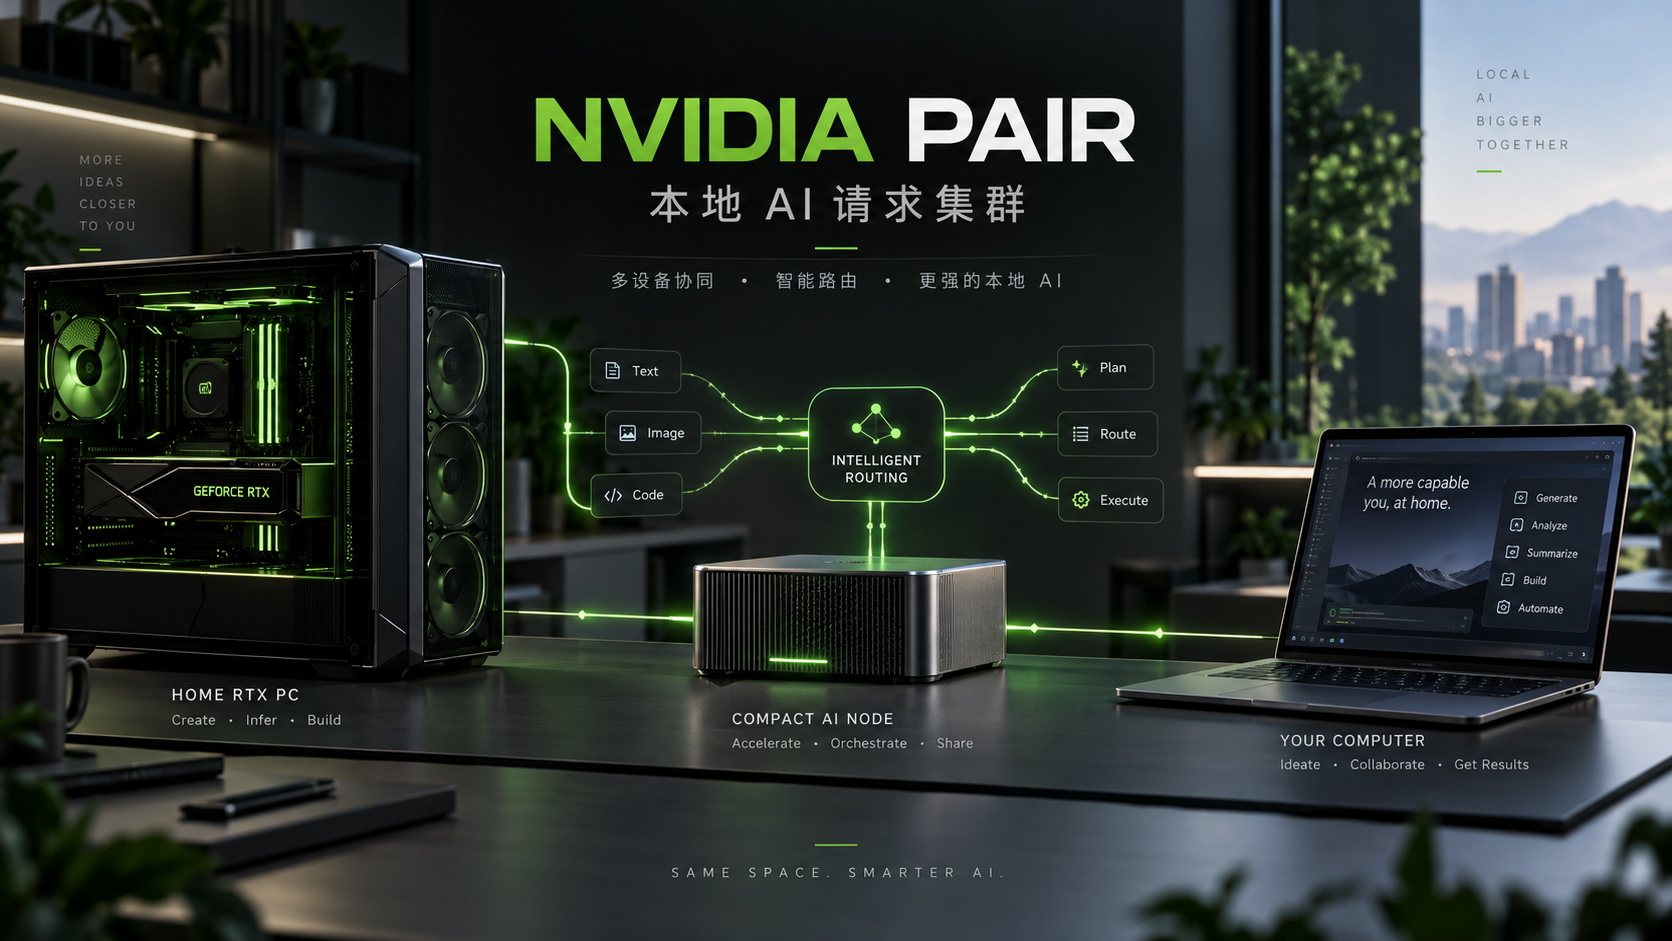 NVIDIA PAIR:把家里的 RTX、DGX Spark 和 Mac 变成本地 AI 请求集群,但它不是“显存池化”
可以把 NVIDIA PAIR 理解成家里本地 AI 的“派单前台”:RTX 主机、DGX Spark、Mac 就像几名能力不同的员工,PAIR 看谁在线、谁装了对应模型、谁现在最空闲,就把下一份 AI 工作交给谁。它特别适合多 Agent 并发,但不会把 16GB + 24GB 显存拼成 40GB,也不会把一个大模型拆到多台机器上。