
论文分析 GitHub Copilot 安全担忧,开发者开始关注数据泄露和授权风险
一篇 4 月论文分析开发者围绕 GitHub Copilot 的安全讨论,归纳数据泄露、许可、提示注入和不安全代码建议等问题。

GitHub Copilot 安全讨论研究:开发者最关注数据泄露、许可和提示注入
arXiv 论文《Security Concerns in Generative AI Coding Assistants: Insights from Online Discussions on GitHub Copilot》提交于 2026 年 4 月 9 日,研究 GitHub Copilot 这类生成式 AI 编码助手在真实开发者讨论中引发的安全担忧。
论文指出,GitHub Copilot 等工具已经支持代码补全、文档生成、bug detection 等任务,但已有研究也发现生成式 AI 存在可靠性、不确定性、偏见和版权侵权等开放问题。相比单纯评估代码生成性能,这篇论文更关注软件开发者在公开论坛中表达的安全担忧。
研究数据来自三个公开讨论平台
作者从 Stack Overflow、Reddit 和 Hacker News 三个平台收集与 GitHub Copilot 安全问题相关的帖子、评论和讨论串。随后使用 BERTopic 对讨论进行聚类,并通过 thematic analysis 归纳出不同类别的安全担忧。
这个方法让论文不只依赖专家假设,而是从开发者和软件从业者的公开讨论中提取问题。它回答的是:真实使用者在接触 Copilot 这类工具时,究竟担心什么。
这和技术 benchmark 形成互补。一个工具即使在代码生成指标上表现不错,如果开发者对数据、许可、攻击面和不安全建议存在持续疑虑,也会影响企业采用和团队流程设计。
四类担忧集中在数据、许可、攻击和代码安全
论文结果归纳出四个主要安全担忧领域:potential data leakage、code licensing、adversarial attacks 和 insecure code suggestions。
数据泄露担忧通常与代码、上下文或企业内部信息是否会被外部服务接收有关。代码许可担忧则涉及生成内容是否可能与训练数据中的开源代码产生版权或许可证风险。对企业来说,这两类问题直接关系到合规、知识产权和客户数据保护。
Adversarial attacks 方面,论文特别提到 prompt injection 等攻击。编码助手如果读取外部上下文、文档、网页或仓库内容,就可能受到恶意指令影响。Insecure code suggestions 则指模型可能生成有漏洞、不符合安全最佳实践或未经充分验证的代码。
安全问题来自使用流程,而不只是模型能力
这篇论文的一个重要启发是,Copilot 的安全担忧不是单纯“模型会不会写错代码”。问题出现在完整使用流程中:开发者如何给出上下文,模型如何生成建议,团队如何审查,代码如何进入仓库,企业如何记录和管理这些 AI 辅助内容。
例如,数据泄露并不一定发生在最终代码里,而可能发生在提示词和上下文上传阶段;许可风险也不一定只看输出相似度,还涉及团队是否能追踪生成来源;提示注入更是和外部信息读取、工具调用和自动化执行能力相关。
因此,企业采用生成式编码助手时,不能只依赖“模型更安全”的声明,还需要在开发流程中设置边界:哪些代码能作为上下文,哪些仓库不能接入,生成代码如何审查,AI 参与程度如何记录。
对团队采用 Copilot 的实际意义
论文的结论强调,这些发现有助于理解开发者如何看待和使用 GenAI-based coding assistants,也指出了改进内置安全功能的重点区域。
对团队来说,最现实的做法是把 Copilot 类工具放进安全开发流程,而不是让它完全由个人自由使用。可以考虑的措施包括:敏感代码和客户数据限制、提示词和上下文使用规范、许可证风险检查、安全扫描、代码审查强化,以及对 AI 生成代码的标记和审计。
这篇论文并不是否定 GitHub Copilot,而是提醒:当生成式编码助手成为开发工具的一部分,安全治理也必须跟着进入 IDE、代码审查和仓库协作环节。
参考来源
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 17GB对100GB:Qwen3.8-27B与Flash-Next做同一批任务,省下的容量换来了什么?
同做89项终端任务,17GB的27B首轮完成35项,100GB的Flash-Next完成45项;最多两次是46对53,最多四次是48对60。本文追到9月13日后续结果,区分模型能力、环境故障和返工时间;测试为苹果MLX四位量化,不是GSQ-RCO IQ3_S,也不能套到16GB显卡。
 Qwen3.8-Flash-Next每秒70词元?本地加速之前,先看模型究竟改了什么
同样叫Flash-Next,70词元/秒背后可能是另一条计算路径:每词元激活专家从10减到5,再训练共享专家补偿。本文对照单台DGX Spark的两套原始资料,拆开量化、MTP、输入速度、输出速度和并发吞吐,不把128GB统一内存结果套到16GB显卡。
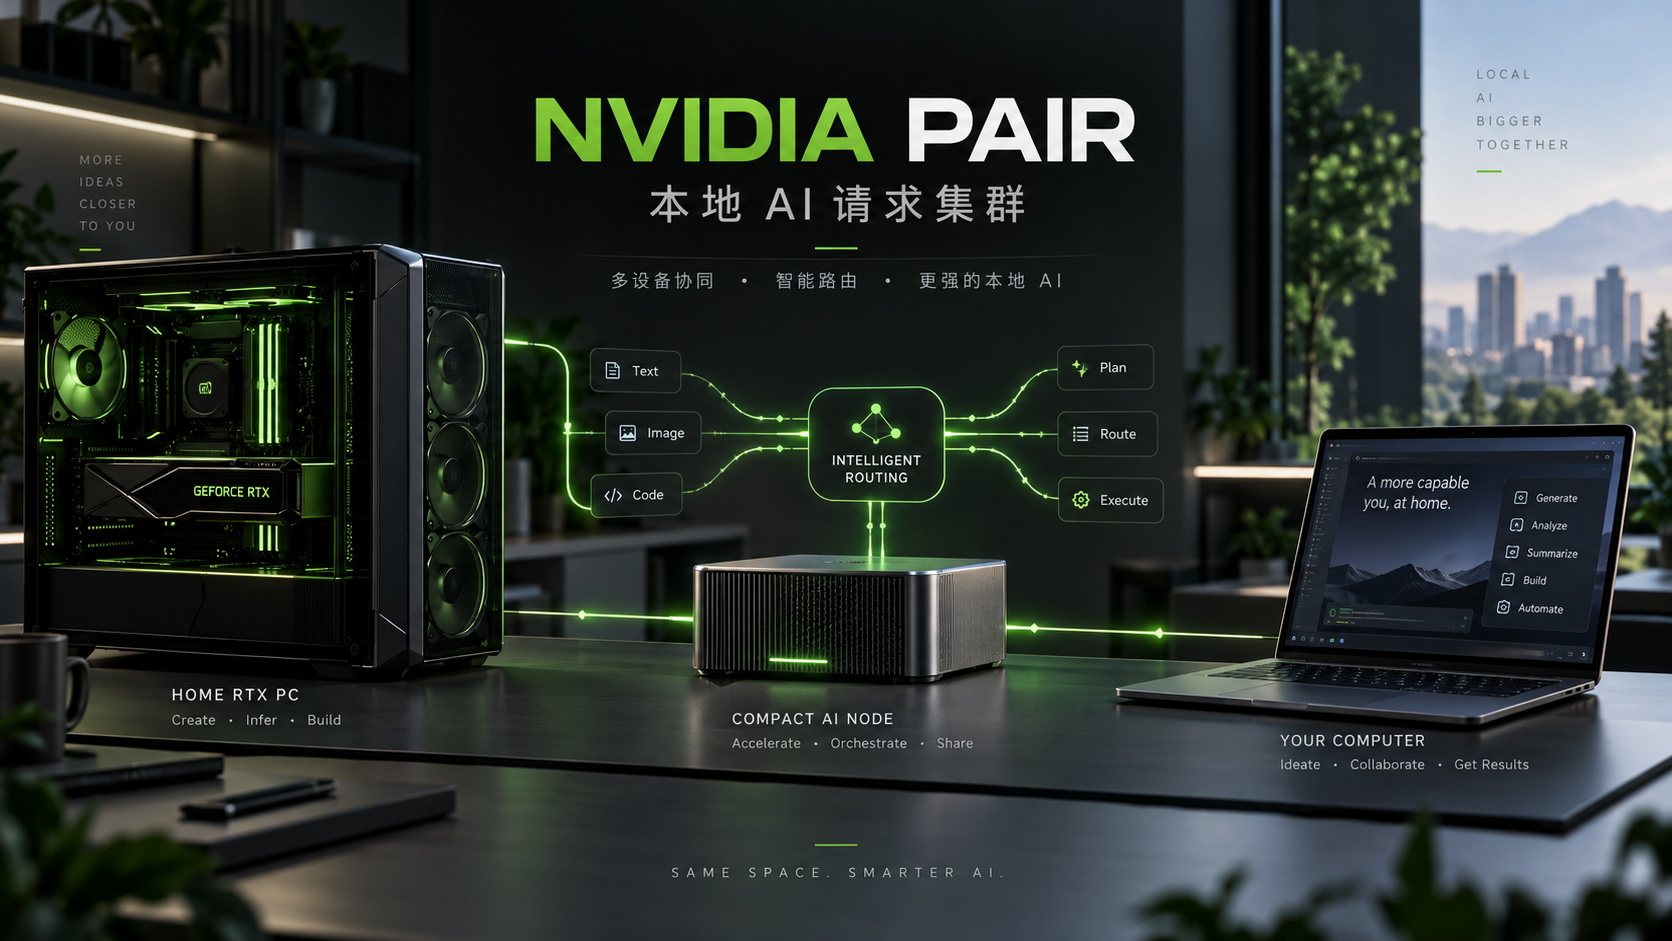 NVIDIA PAIR:把家里的 RTX、DGX Spark 和 Mac 变成本地 AI 请求集群,但它不是“显存池化”
可以把 NVIDIA PAIR 理解成家里本地 AI 的“派单前台”:RTX 主机、DGX Spark、Mac 就像几名能力不同的员工,PAIR 看谁在线、谁装了对应模型、谁现在最空闲,就把下一份 AI 工作交给谁。它特别适合多 Agent 并发,但不会把 16GB + 24GB 显存拼成 40GB,也不会把一个大模型拆到多台机器上。