
照片变成 3D 以后,椅子能单独挪走吗?FIRE3D 的场景重建新思路
FIRE3D 是把照片或视频变成可编辑三维场景的 AI 研究项目。它可以为试摆家具、调整虚拟机位和制作互动原型提供场景草稿。先看结果能怎样使用,再理解重建过程与限制。
FIRE3D 是一个用 AI 把照片或视频重建成三维场景的研究项目。给它一间房的影像,它会尝试生成房间和家具的立体模型,让桌子、椅子等物体可以在三维软件里分别移动、旋转或缩放。官方项目页展示了这样的结果。
设计师可以拿重建出来的房间试摆家具,内容创作者可以预先调整虚拟拍摄机位,做互动原型的人也可以用它准备场景草稿。这些用途来自它输出的三维结构;真正放进项目之前,仍需检查重建质量。
2026 年 9 月 9 日,来自伊利诺伊大学厄巴纳—香槟分校与康奈尔大学的研究者公开介绍了 FIRE3D,并发布代码、模型和示例数据。作者的发布串文说明了开放内容,论文已在前一天提交至 arXiv。它目前是供研究和进一步使用的项目,自己生成场景需要配置运行环境。
重建出来的房间,可以怎样改?
假设你想把桌边的椅子挪到窗前。只有一张照片时,改变的是画面中的像素;有了独立的三维椅子,就能改变它在场景里的位置,再从另一个角度观察布局。FIRE3D 希望生成的,就是这种可以继续操作的场景。
想先理解结果,不必马上下载模型。官方 3D Explorer提供了可在浏览器里查看的场景示例:切到重建视图,选中一个物体的三维模型,就能移动、旋转或缩放。它展示的是预先准备好的结果,不能在这里上传任意照片直接生成。
“把椅子移开”听起来简单,模型却得先认出哪一部分属于椅子,还要让它离开原位后仍然是一件完整物体。接下来的两步,正是在解决这个问题。
先得知道哪一块才是椅子
输入可以是普通彩色照片或视频,技术资料里也称为 RGB 图像。为了从平面画面理解空间,流程先用名为 Pi3 的模型,估计画面中各点的三维位置,以及拍摄时相机在哪里、朝向哪里。FIRE3D 再利用这些线索判断有哪些物体、它们分别占据哪些区域。
识别后,系统会为物体确定位置和旋转方向,技术上称为“6 自由度位姿”。它也会用三维框标记物体范围,并区分哪些观察点属于同一件东西,用户不必先逐件把家具圈出来。有了这些信息,后面的生成模型才能分别补出形状和材质,再把物体放回同一个场景。论文的方法部分交代了这条路径。
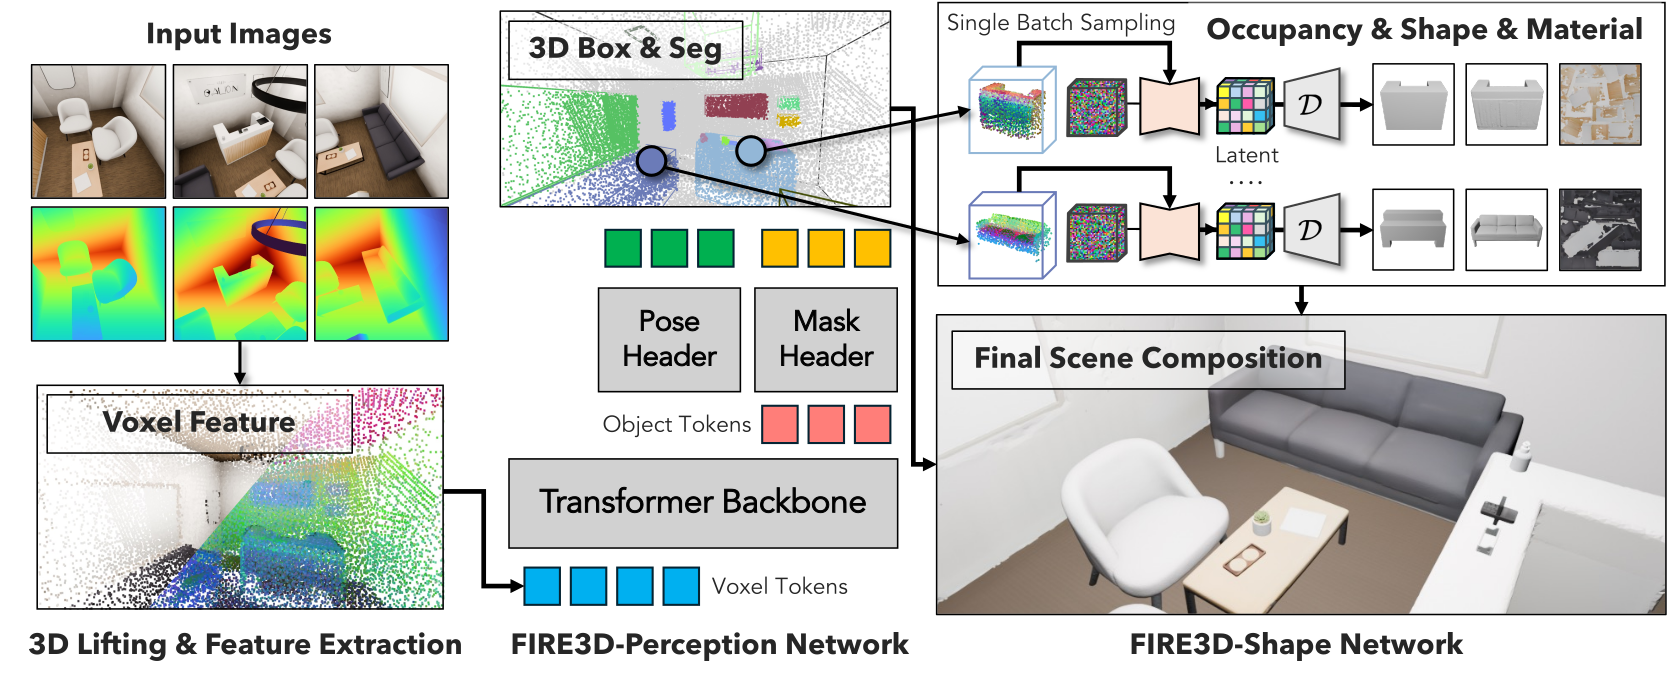
*官方方法图。左侧是图像与深度,中间预测物体的位置和所属区域,右侧分别生成几何与材质后组装场景。图中的结果来自研究团队,表示方法与示例,不是本站执行记录。来源:FIRE3D 项目页。*
这一步很容易被最终效果盖过去。可如果椅子一开始就没有被识别出来,后面再好的建模能力,也接不到这把椅子的重建任务。整条流程的质量,取决于前面有没有把场景分对。
挪开以后,背面从哪里来
拍摄时,桌子可能遮住半张椅背,沙发背面紧贴墙壁,镜头根本没有看见。只把看得见的表面做成模型,一旦移动物体,缺口就会露出来。
FIRE3D 会根据已观察到的点和学到的形状规律,预测被遮挡的部分,再为物体生成立体形状与 PBR 材质。PBR 描述的是表面在光照下怎样表现,例如粗糙程度和金属感。输出中,前景物体保持独立,墙面等结构组成背景;当前代码还会导出组合后的 GLB 场景文件,这种格式可以保存三维模型与材质。官方仓库列出了具体输出。
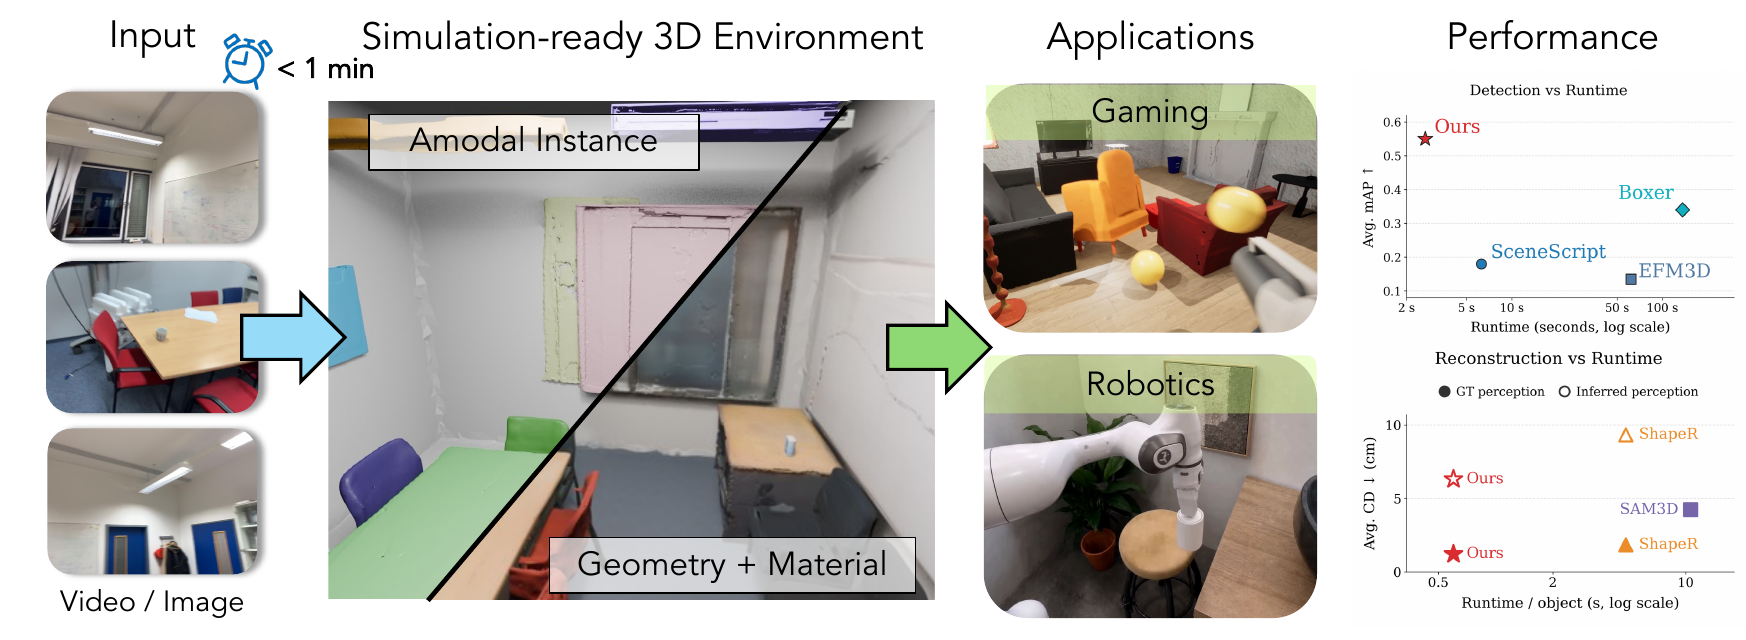
*团队的结果概览:左侧为输入观察,中间对照完整物体与带材质场景,右侧展示应用及研究指标。“一分钟”和右侧指标均属于作者特定实验条件,不能据此推断消费级显卡耗时或真实尺寸精度。来源:FIRE3D 项目页。*
补出完整外形很有用,但照片没拍到的地方终究是预测。模型猜出一把看起来合理的椅子,不代表准确恢复了原椅背后的结构。想用它安排虚拟镜头,这种近似也许够用;想据此订做家具、判断承重,所需证据就完全不同了。
官方模型卡也列出了相机和深度不准、严重遮挡、异常尺度以及陌生物体等失效条件。重建结果应当被检查,而不该因为表面贴好了材质,就被当成测量报告。
“一分钟”省下了哪些工作
一间屋子往往有十几件物体。每件都生成形状和材质,计算量与显卡内存占用会一起累积。FIRE3D 在已有的 TRELLIS.2 三维表示基础上,增加了一个名叫 HC-VAE 的压缩模块,把描述物体形状和材质的中间数据再压缩 32 倍。这让模型有条件成批处理多个物体,不必把整个场景逐件排队生成。模型卡的 HC-VAE 说明记录了这层关系。
32 倍指的是中间表示的体积变化,不能直接换算成显卡便宜 32 倍,或者整个流程提速 32 倍。
项目页给出的研究配置是单张 80GB A100,最多并行处理 16 个物体。作者报告的一组任务,从 60 帧视频估计出带相机位置和朝向的彩色图像、深度信息,技术上称为带位姿的 RGB-D 观测;其中包含十余个物体,重建推理可在 60 秒内完成。这些条件要和数字一起读。当前公开仓库的安装说明,则写明发布协议在 96GB 显卡上验证。研究条件与当前运行环境说的是不同范围,不能合并成“普通电脑拍完就能一分钟得到成品”。
对三维制作来说,更实际的意义是:物体形状、材质和摆放关系被一起装进了可导入的场景。创作者拿到的起点有了空间结构,可以接着摆机位、调整构图。但这份起稿省下多少整理工作,还要看物体表面是否完整、材质是否可用,以及它和目标项目的要求相差多远。
用在项目里,还需要检查什么?
论文把当前范围限定在静态室内场景,并承认物理稳定性、关节结构和重新布光效果尚无保证。能挪动柜子,还不能顺势理解为柜门也能打开;要做能交互的柜门,还需要进一步处理模型结构。论文的局限说明值得和演示一起看。
如果进一步运行项目,当前参考环境涉及 Linux 系统、用于显卡计算的 CUDA 环境,以及三维制作软件 Blender,仍有研究工具的使用门槛。代码采用 MIT 许可,模型包中的 DINOv3、TRELLIS.2 等组件继续保留各自条款,不能只看仓库首页的 MIT 标签就判断整套资产的使用范围。模型包说明对此作了区分。
我更愿意把这类结果看成空间创作的起稿。椅子能单独挪走,意味着你终于可以开始改布局;挪开之后露出的形状对不对,则是接下来值得仔细看的地方。
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 录音说错一句话,能让 AI 直接修改吗?AuK 的语音编辑新能力
AuK 是能按文字要求生成和修改语音的 AI 模型。录音念错几个字、语气不合适或有噪声时,它能怎样帮忙?先看一段口播如何返工,再了解效果与本地使用条件。
 本地模型还能快多少?ExLlamaV3 1.5 先省下一次内存搬运
ExLlamaV3 是帮助在自己电脑上运行 AI 大模型的工具,负责加载模型和安排计算。先弄清它在本地 AI 中的作用,再看 1.5 版本如何减少内存搬运、改善等待时间。
 17GB对100GB:Qwen3.8-27B与Flash-Next做同一批任务,省下的容量换来了什么?
同做89项终端任务,17GB的27B首轮完成35项,100GB的Flash-Next完成45项;最多两次是46对53,最多四次是48对60。本文追到9月13日后续结果,区分模型能力、环境故障和返工时间;测试为苹果MLX四位量化,不是GSQ-RCO IQ3_S,也不能套到16GB显卡。