
DeepSeek V4.1 Flash:读得更省,能给长任务带来什么?
DeepSeek V4.1 Flash 是能理解文字和图片、帮助整理资料与回答问题的 AI 模型。先从它能处理的工作说起,再看这次长资料处理的改进,以及使用时需要留意的变化。
DeepSeek V4.1 Flash 是 DeepSeek 推出的一款通用 AI 模型,能理解文字和图片,并根据你的要求生成回答。把一份材料交给它,你可以让它概括重点、回答关于材料的问题,或把分散的信息整理成便于阅读的说明。这类模型负责的,就是 AI 助手里“理解内容、组织回答”的部分。
9 月 10 日发布的这个版本,除了加入图像理解,也着重改进了处理长资料的方式。DeepSeek 官方发布说明介绍了这些变化。对使用者来说,可以先从一个实际问题理解它:如果一项工作要反复读材料、接着追问,模型能不能少花一些时间和资源,把这件事做完?
先看它能帮你处理怎样的工作
例如,把一份项目讨论记录交给模型,请它整理已确定的需求,再列出还没有答案的问题。你不必一次问完,还可以继续追问某个结论依据哪段内容。模型给出的归纳仍需对照原材料检查,但这种用法能帮你先理出线索。
再往前一步,模型也可以接入 Agent,也就是能按照任务调用工具、继续处理结果的 AI 助手。在这样的软件中,助手按获得的权限读取文件、查询资料,模型负责理解返回的内容,再判断下一步。读取你电脑上的文件,需要相应工具和权限,不能只靠模型名称来推断。
这类任务的特点是:最终答案可能只有几段,前面读过的材料却很多。V4.1 Flash 这次对输入计算和缓存的调整,主要就和这部分工作有关。知道它要解决什么问题,再看技术细节会容易得多。
读一大叠材料,未必要把整套计算都走一遍
模型收到新材料后,需要先处理输入,准备后续生成会用到的状态,这一步叫预填充(prefill)。随后逐个生成文字片段,属于解码(decode)。这些处理单位叫 token,一个 token 不一定对应一个汉字。读几十页资料、只回答几句话的任务,输入与输出的工作量本来就不对称。
V4.1 Flash 的因果编码器—解码器架构,简称 CED,把 40 层网络分成前后各 20 层。后半部分所需的全局缓存,可以由前半部分的输出投影得到。这样,大部分提示词不必再完整经过后半段计算,长输入的预填充就有了节省空间。技术报告第 7—9 页解释了这条路径。
这里容易理解过头:负责生成答案的解码器并没有被关掉。它仍要准备所需状态,只是可以重新处理输入末尾的一小段,而不必把全部长输入再走一轮。官方给出的激活参数规模,读入时约为 8B,生成时约为 16B;B 表示十亿,“激活”指这次计算动用了多少参数。这里的分工,正是两个数字不同的原因。
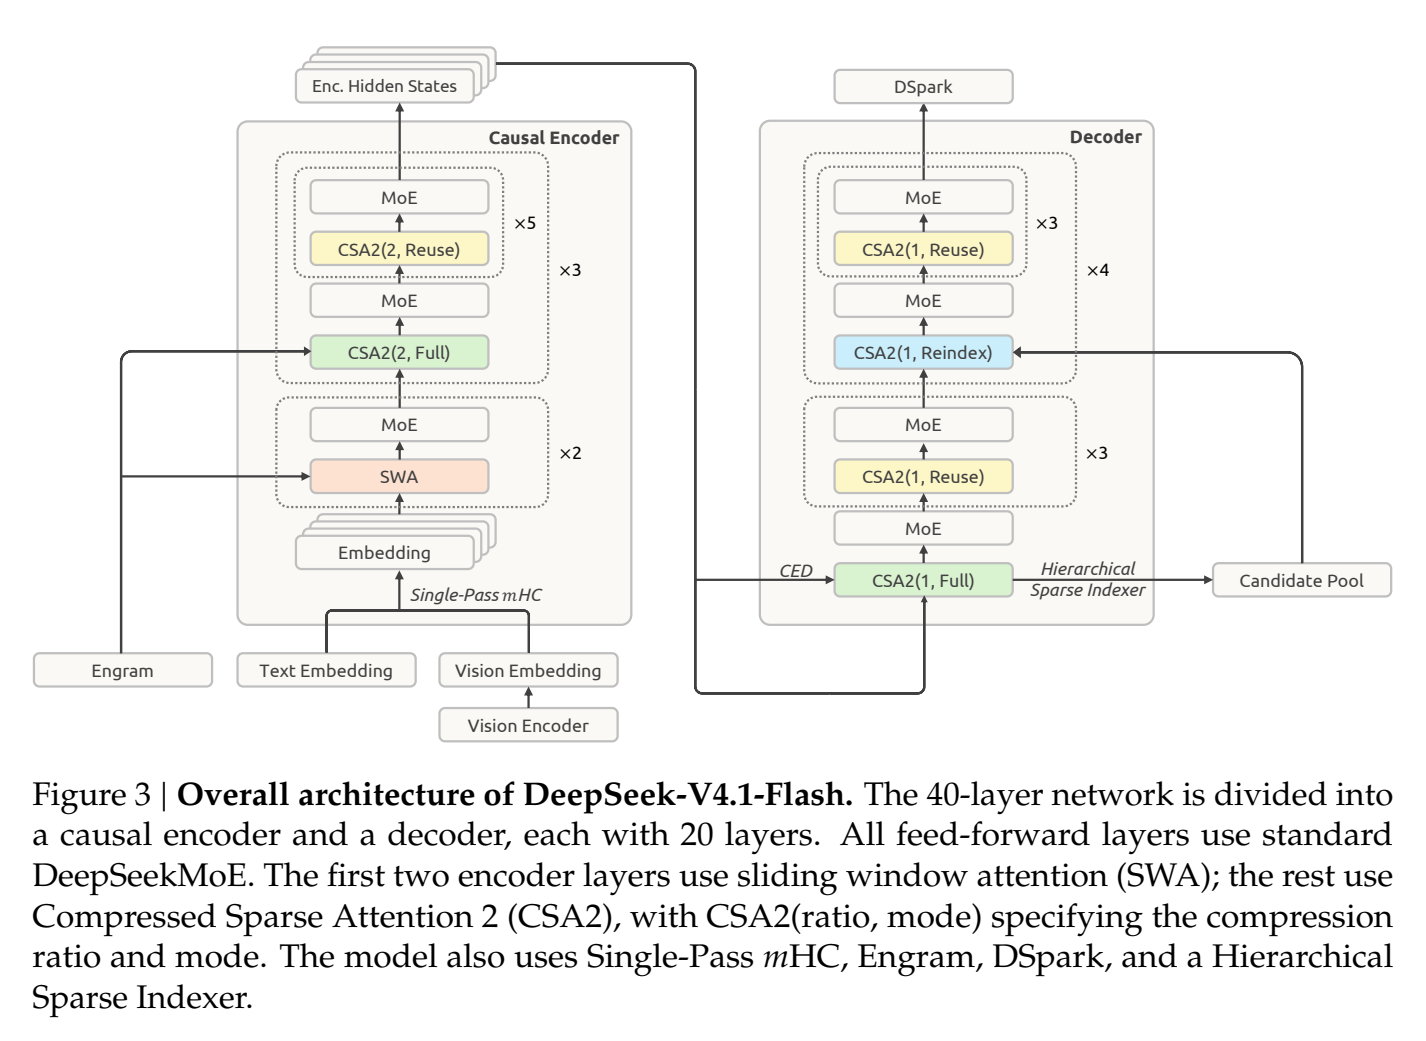
*来源:DeepSeek 技术报告 Figure 3,保留原图注。图中展示的是官方架构设计;左、右两组各有 20 层,连线说明状态如何传递,不代表实际运行耗时比例。*
对读者来说,可以先记住这个判断方法:如果你的任务总要读取大量文件和工具结果,那么输入阶段的效率值得单独看。只盯着答案生成时每秒蹦出多少字,会漏掉前面那段等待。
缓存变小,长任务才不容易被“记住材料”拖累
模型处理过的上下文,会留下后续注意力计算需要的键值状态,也就是 KV 缓存。它不是原文的简单副本,也不是保存好的一段答案。保留这些状态,可以减少重复计算;代价是占用内存,以及在不同设备之间搬运数据。
V4.1 Flash 让部分网络层共享缓存和查找信息的位置,减少重复保存;同时,用更紧凑的数字格式存储缓存。这两项设计在官方资料中分别涉及 CSA2 和 FP4 表示。模型卡给出的全局 KV 占用是每 token 890 字节,上一代 V4 Flash 为 3514 字节,约缩到四分之一。这个比较只针对全局 KV,不包含模型权重等其他开销。官方模型卡同时给出了结构说明和图表。
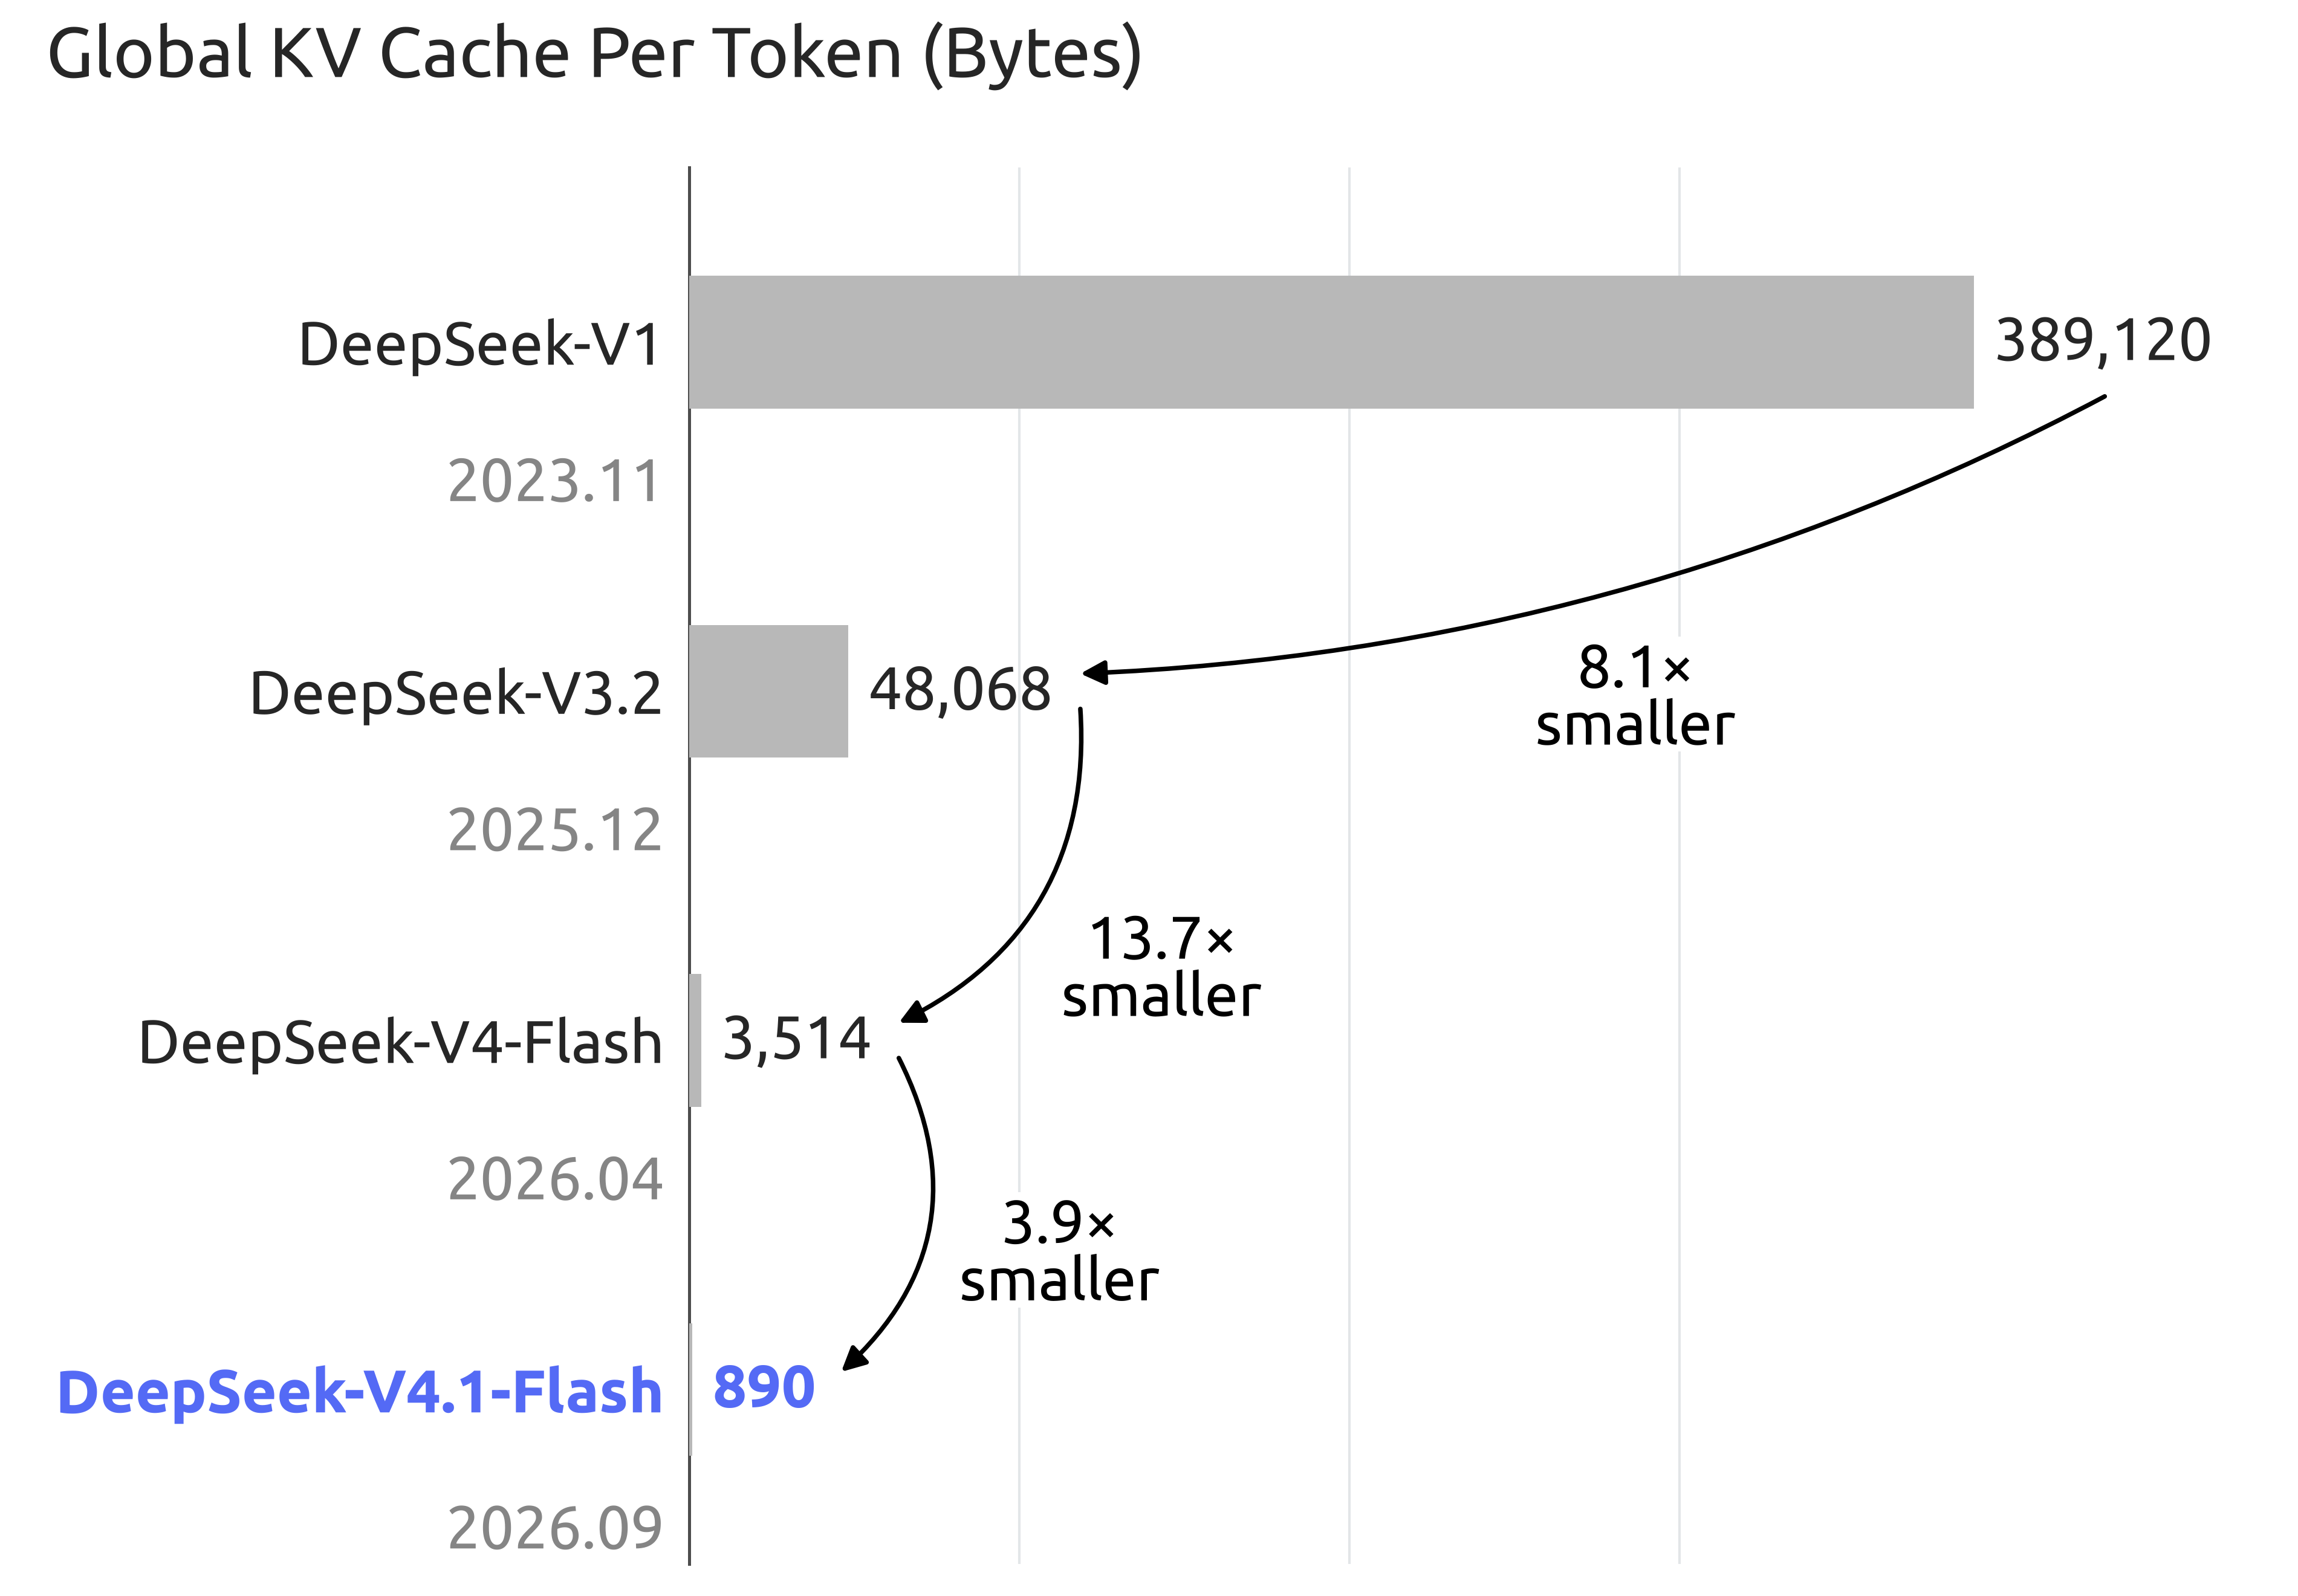
*来源:DeepSeek 官方模型卡,单位为字节 / token,属于厂商报告数据。最近两代为 3514 与 890;图中的约 3.9 倍差异不能直接换算成整机省内存或任务提速倍数。*
还有一笔容易被忽略的账:供后续请求复用的持久化缓存。技术报告介绍,V4.1 把局部滑动窗口状态从长期缓存中分离出去,需要时通过有限长度的重放补回来。官方在相同工作负载下报告,持久化 KV 占用约为前代的八分之一。重建的是近似状态,作者报告对回答质量的影响很小,并非数学上完全无损。报告第 19—20 页交代了这项取舍。
于是,一份资料被连续追问时,系统有机会少存一些、少搬一些。但缓存占用缩到八分之一,不意味着你的账单也会照着除以八。请求是否命中缓存、输出多长,以及服务商如何计费,仍然决定最终成本。
看到 8B,先别急着给家里的显卡安排任务
“激活 8B”很容易让人联想到本地常见的小模型。这里需要把口径拆开:技术报告写的是 552B 主干参数,外加 196B Engram 条件记忆参数;8B / 16B 描述每个 token 参与相应计算的激活规模。报告第 7 页的模型概述明确区分了它们。
一次计算只动用部分参数,并不等于部署时只需要容纳这部分权重。其余参数如何存放、读取和分配,还要由推理系统处理。所以,这次发布对普通用户最直接的意义,仍是云端长任务有了新的效率方案;不能仅凭 8B 这个数字,推导出一张消费级显卡就能顺畅运行。
你的旧模型名,可能已经指向了新模型
如果通过 API 使用 DeepSeek,也就是让自己的软件向模型发送任务、接收回答,还要留意模型名字的变化。官方推荐使用 deepseek-flash;旧的 V4 Flash 模型名暂时转到 V4.1 Flash。自北京时间 9 月 14 日 12:00 起,deepseek-v4-pro 请求也转由 V4.1 Flash 处理,并按新模型费率计费,直到 V4.1 Pro 上线。这些安排写在官方发布页的 API 说明中。
也就是说,脚本里同一个名字还能调用成功,并不能说明背后模型没变。一个负责提取合同字段或检查项目资料的流程,最好拿几份已经知道答案的样本重新跑一遍:字段有没有漏,格式是否稳定,碰到相互矛盾的材料会不会直接猜答案。
如果还想比较效率,可以把首次读入资料和连续追问分开记录,再看整件任务的耗时与用量。官方能力评测使用了特定推理强度和工具框架;模型卡中指令模型的表格使用最高 reasoning_effort=100,不能直接当作任意日常配置的表现。评测设置值得和分数一起读。
长任务里,模型除了要答得好,还得负担得起不断增长的材料。V4.1 Flash 对输入计算和缓存的处理,让这个问题有了具体可讨论的方案。至于它是否适合接手你的工作,可以拿一份熟悉的材料,看它能否稳定给出可用结果,再决定要不要扩大使用范围。
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 录音说错一句话,能让 AI 直接修改吗?AuK 的语音编辑新能力
AuK 是能按文字要求生成和修改语音的 AI 模型。录音念错几个字、语气不合适或有噪声时,它能怎样帮忙?先看一段口播如何返工,再了解效果与本地使用条件。
 本地模型还能快多少?ExLlamaV3 1.5 先省下一次内存搬运
ExLlamaV3 是帮助在自己电脑上运行 AI 大模型的工具,负责加载模型和安排计算。先弄清它在本地 AI 中的作用,再看 1.5 版本如何减少内存搬运、改善等待时间。
 17GB对100GB:Qwen3.8-27B与Flash-Next做同一批任务,省下的容量换来了什么?
同做89项终端任务,17GB的27B首轮完成35项,100GB的Flash-Next完成45项;最多两次是46对53,最多四次是48对60。本文追到9月13日后续结果,区分模型能力、环境故障和返工时间;测试为苹果MLX四位量化,不是GSQ-RCO IQ3_S,也不能套到16GB显卡。