
阿里发布更强机器人 AI 模型:Qwen 正从对话模型走向具身智能工具箱
TechRadar 报道称,阿里披露面向机器人的强力 AI 模型和机器人套件,重点不只是模型参数,而是把视觉、语言、动作和 agentic workflow 推向物理世界。

TechRadar 报道称,阿里披露了面向机器人的更强 AI 模型与相关能力,标题直接把它放在与 Nvidia 机器人生态竞争的语境里。原文的关键信息不在于“又一个大模型发布”,而是阿里正在把 Qwen 系列从文本、多模态和 agentic workflow 推向机器人场景。
机器人 AI 与普通聊天模型的差别很大。它需要理解视觉输入、语言指令、环境状态和动作约束,还要把计划拆成可以在物理世界执行的步骤。只要进入实体机器人,模型就不能只追求回答漂亮,而要面对延迟、错误恢复、安全边界和硬件适配。
机器人模型的重点是“感知到动作”的闭环
TechRadar 把这次更新放在 agentic race 中理解,是合理的。所谓机器人 AI,不只是让机器人听懂一句话,而是让系统在真实环境里完成任务:看见物体、理解目标、规划路径、控制末端执行器,并在失败时重新判断。
这要求模型具备更强的跨模态推理能力。视觉模型要识别空间和对象,语言模型要理解人类意图,控制系统要把动作约束交给机器人硬件。阿里如果把 Qwen 的模型能力与机器人套件结合,实际是在建设一个从云端模型到物理执行的开发者入口。
与 Nvidia 的机器人生态相比,阿里的差异可能在于更强调模型和应用层能力;Nvidia 则在仿真、芯片、Isaac 平台和机器人训练基础设施上积累更深。两者不是完全同类竞争,但都在争夺具身智能的开发者和产业入口。
中国 AI 公司正在从模型榜单走向硬件场景
这条新闻也反映了中国 AI 公司竞争方向的变化。过去外界关注 Qwen、DeepSeek 等更多是模型能力、开源策略和成本效率;机器人场景则要求模型公司理解制造业、硬件生态和行业落地。
如果模型只能在网页聊天框中工作,它的商业空间会被 API 价格和通用助手竞争压缩。机器人、工业自动化、仓储、服务业和智能终端则可能提供更长周期的应用场景。阿里进入机器人 AI,不只是追随热点,而是在寻找模型能力与实体经济结合的高价值入口。
不过,原文并没有证明阿里的机器人模型已经在真实工厂或大规模商业环境中领先。报道展示的是能力方向和产品叙事,离稳定部署仍有距离。具身智能最难的地方恰恰是从 demo 到长期运行:同一个动作在实验室可行,不代表在复杂现场可持续。
对前沿学习的价值在于看清“模型产品化”的下一站
这篇前沿不应只看成阿里与 Nvidia 的标题竞争。更重要的是,机器人正在成为大模型产品化的压力测试:模型必须理解环境、调用工具、遵守安全约束,还要与硬件系统协同。
对开发者和企业团队来说,值得关注的是阿里后续是否会提供清晰的 SDK、仿真环境、机器人硬件适配、评测任务和部署案例。只有这些配套完善,机器人 AI 才能从概念进入可复用的行业工作流。否则,再强的模型也只是发布会里的能力展示。
参考来源
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 17GB对100GB:Qwen3.8-27B与Flash-Next做同一批任务,省下的容量换来了什么?
同做89项终端任务,17GB的27B首轮完成35项,100GB的Flash-Next完成45项;最多两次是46对53,最多四次是48对60。本文追到9月13日后续结果,区分模型能力、环境故障和返工时间;测试为苹果MLX四位量化,不是GSQ-RCO IQ3_S,也不能套到16GB显卡。
 Qwen3.8-Flash-Next每秒70词元?本地加速之前,先看模型究竟改了什么
同样叫Flash-Next,70词元/秒背后可能是另一条计算路径:每词元激活专家从10减到5,再训练共享专家补偿。本文对照单台DGX Spark的两套原始资料,拆开量化、MTP、输入速度、输出速度和并发吞吐,不把128GB统一内存结果套到16GB显卡。
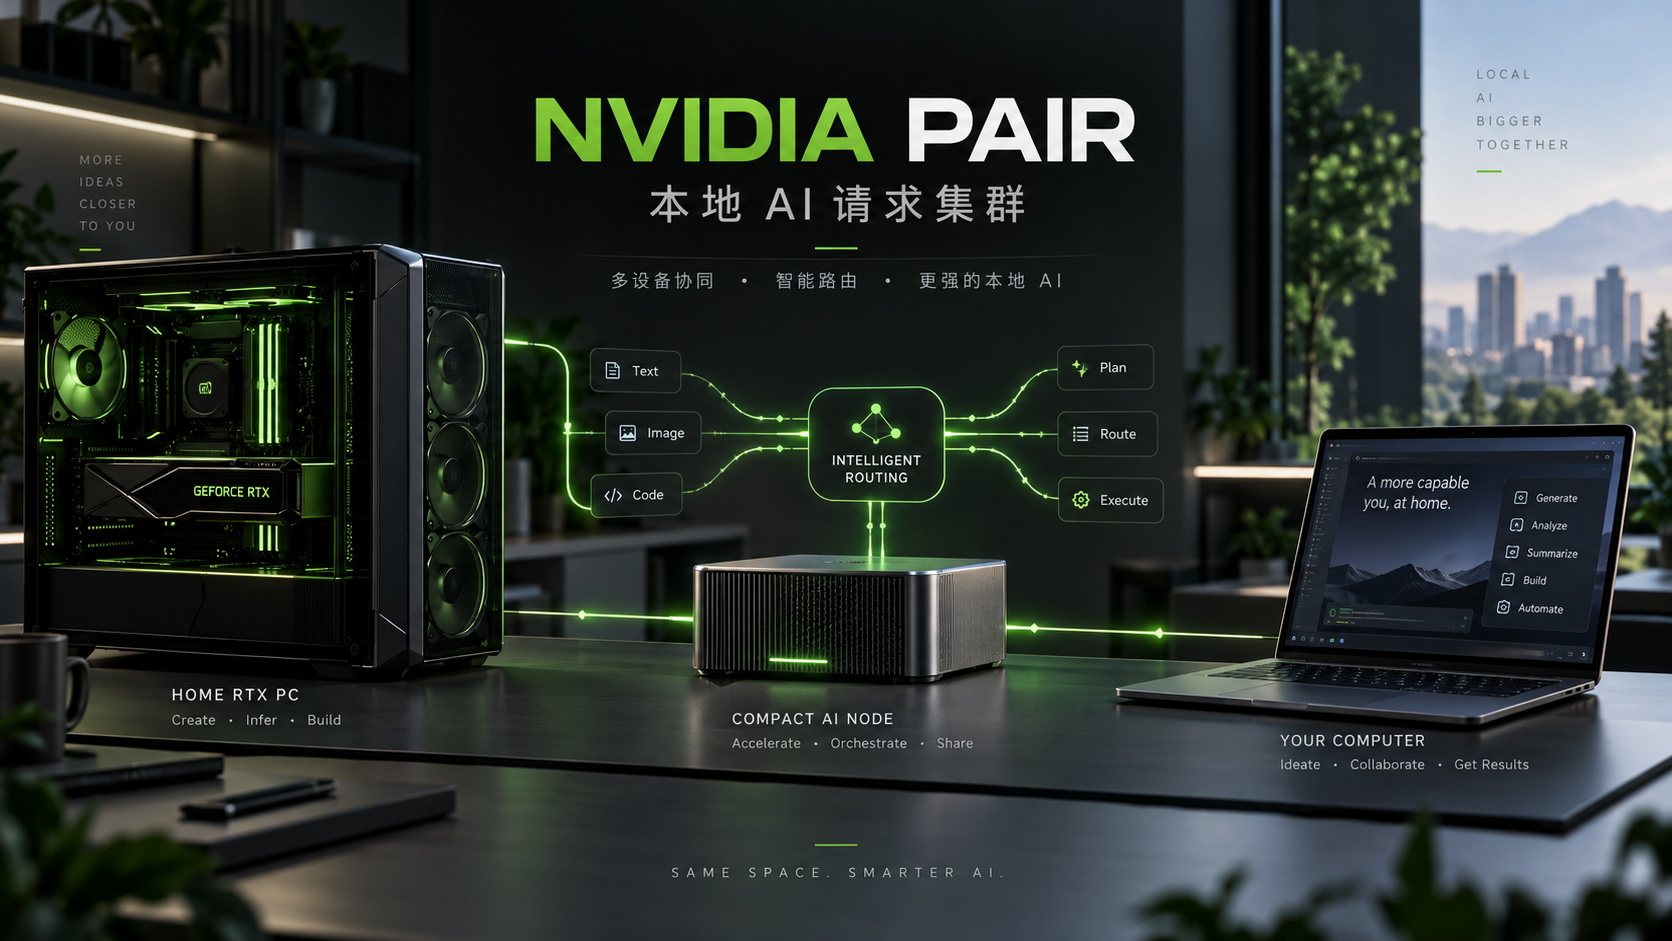 NVIDIA PAIR:把家里的 RTX、DGX Spark 和 Mac 变成本地 AI 请求集群,但它不是“显存池化”
可以把 NVIDIA PAIR 理解成家里本地 AI 的“派单前台”:RTX 主机、DGX Spark、Mac 就像几名能力不同的员工,PAIR 看谁在线、谁装了对应模型、谁现在最空闲,就把下一份 AI 工作交给谁。它特别适合多 Agent 并发,但不会把 16GB + 24GB 显存拼成 40GB,也不会把一个大模型拆到多台机器上。