
副歌很好听,能不能只改和弦?YuE2 给 AI 作曲留下了修改的余地
YuE2 是根据歌词和曲风要求生成歌曲的 AI 模型,还能留下可继续修改的乐谱。它可以怎样帮你试旋律、改和弦?从一次歌曲修改说起,再看本地使用的条件。
YuE2 是一个 AI 音乐生成模型。你提供歌词,再描述想要的曲风,它就能生成带有人声和伴奏的歌曲。对写歌的人,这可以用来试一版旋律、听听歌词唱出来的感觉,再决定接下来怎样改。官方发布记录介绍了歌曲创作和改编的用法。
M·A·P 团队在北京时间 2026 年 9 月 10 日发布的这个公开版本,还有一个值得留意的特点:除了声音,它可以留下可编辑的旋律与和弦乐谱。当前提供的是模型和配套创作工具,需要准备运行环境;实际门槛放在文末说明。
有了这份乐谱,就能讨论一个更具体的要求:副歌旋律已经顺耳,歌词也合适,只是伴奏太平,想换一组更有张力的和弦。重新描述整首歌,可能连喜欢的部分一起变掉;把要改的音乐内容单独写清楚,就更容易保留已经满意的决定。
先把曲子写下来,再让它唱出来
先把两个音乐概念说清楚。旋律是一段能跟着哼唱的音符走向;和弦是同时响起的一组音,为旋律提供支撑。同一段旋律换一组和弦,听众仍有机会认出原来的歌,气氛却能发生变化。
YuE2 可以先把这些音乐安排写成乐谱,再生成声音。它使用的 ABC 是一种文本记谱方式,用字符记录音高和时长等信息;完整规划模式还包含和弦。乐谱随后会被转换成模型内部的音乐信息和声音表示,最后输出歌声与伴奏。只规划旋律,或者跳过乐谱阶段直接生成,也是可选路径。官方项目说明展示了这些阶段的关系。
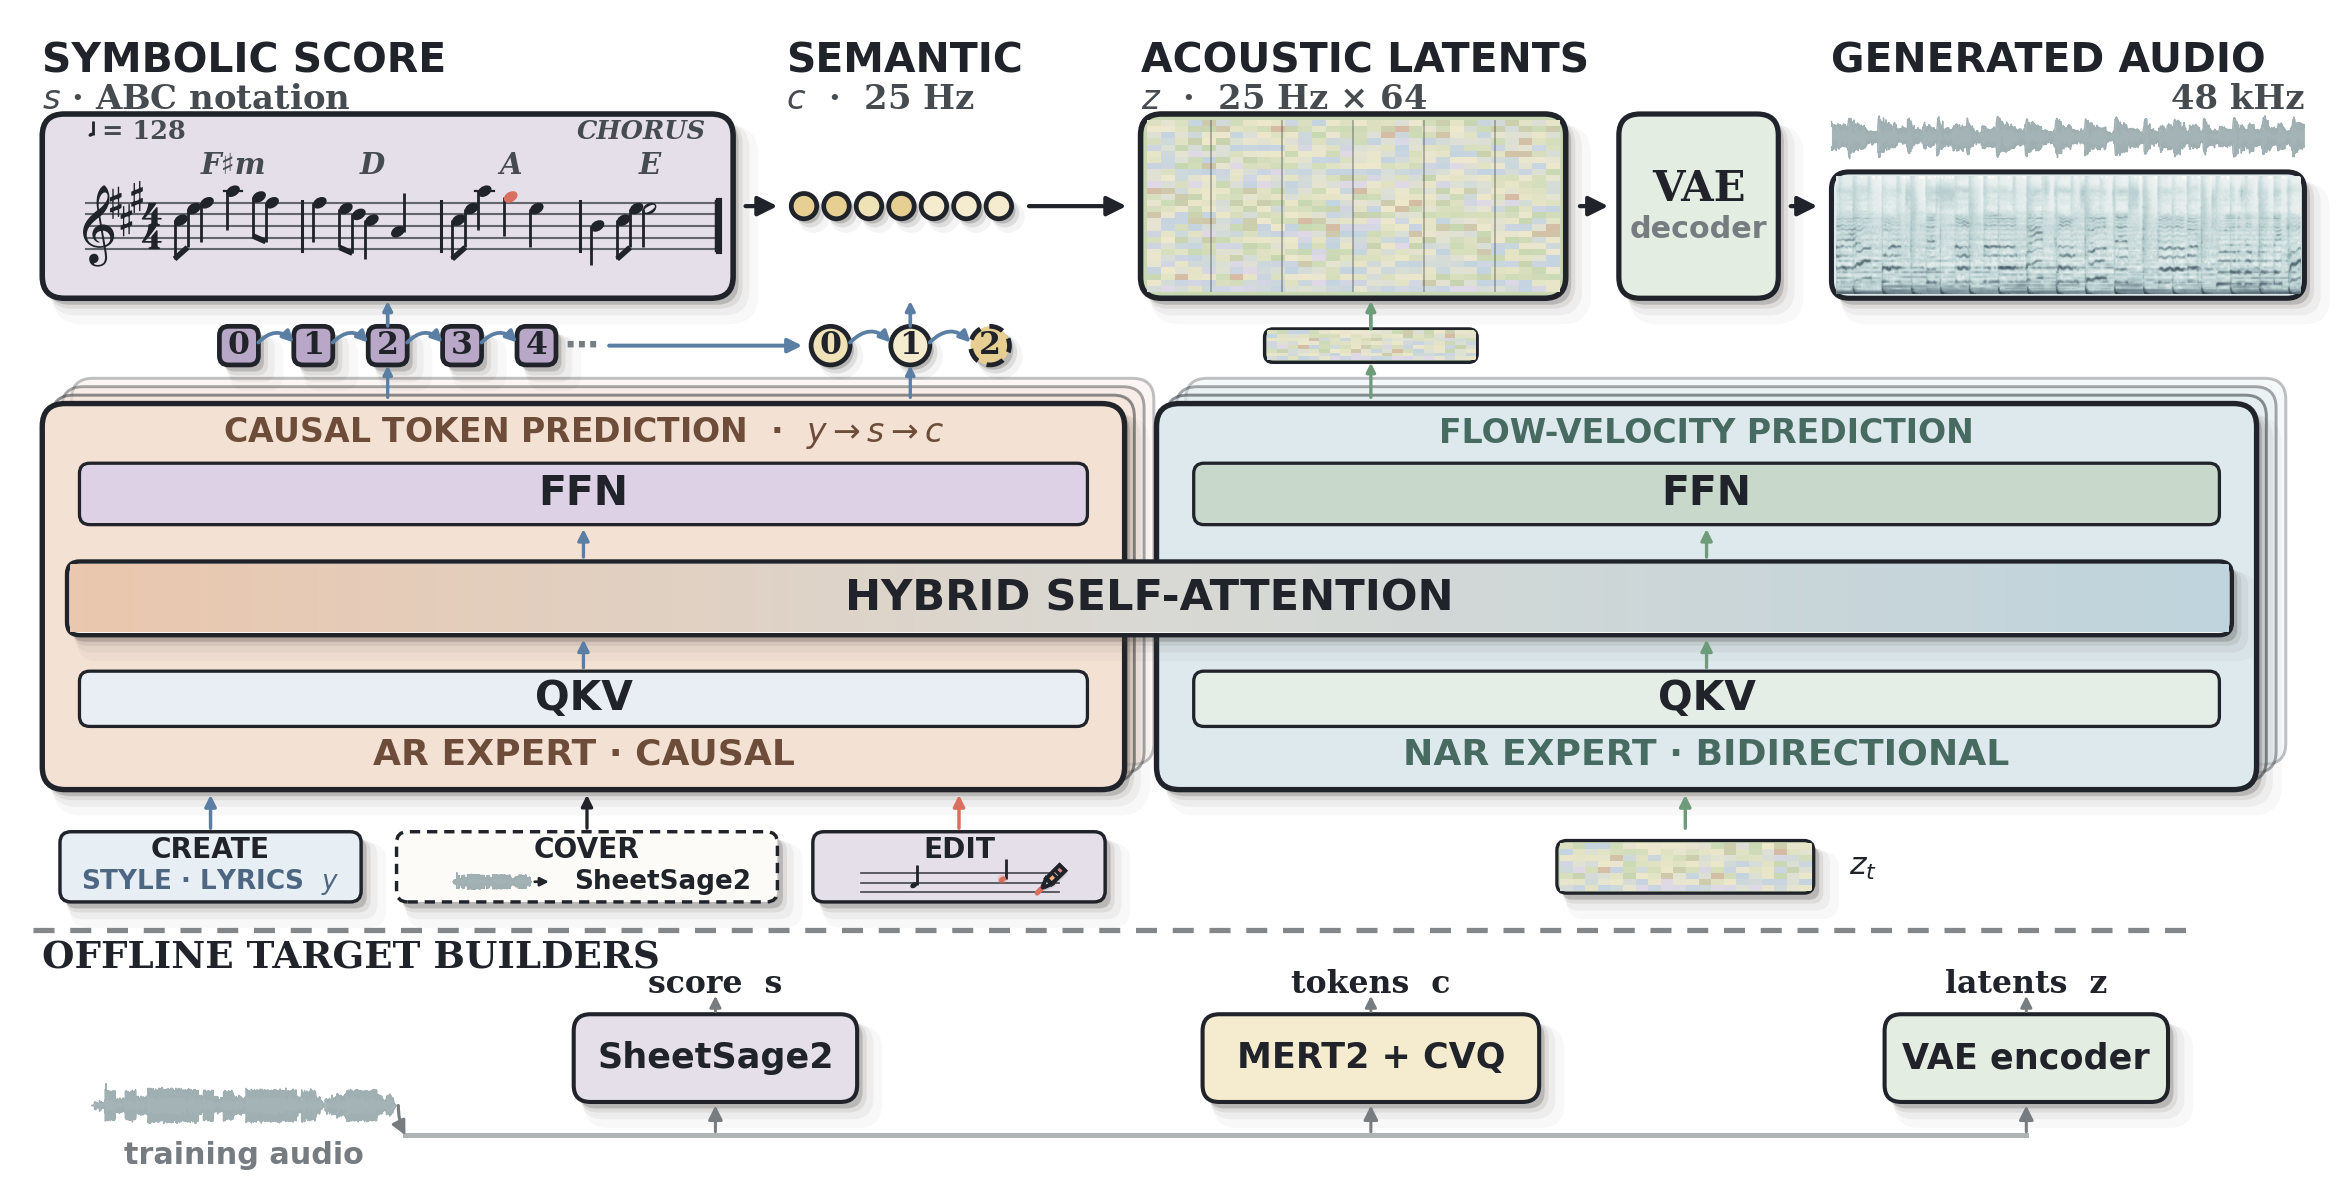
*图为 YuE2 团队提供的架构说明。上方展示乐谱到音频的路径,下方展示训练目标的来源;它解释模型怎样组织信息,不是本站的音质测试结果。来源:YuE2 模型卡。*
对创作者来说,乐谱让“这部分保留,那部分重做”有了具体对象。修改时可以对照音符和和弦,看看自己的要求究竟落在了哪里。
不过,这份乐谱还不是录音工程。它没有逐轨保存某个歌手的每一次呼吸,也没有把鼓、贝斯、人声变成可以分别拉推子的音轨。修改乐谱后,YuE2 会按新条件重新生成声音,不能据此承诺“其余波形一毫秒也不变”。
Agent 有了具体可改的对象
官方编辑用法允许把乐谱、歌词、原始风格提示和修改要求交给 Agent,也就是能按要求读取、修改文件并调用工具的 AI 助手。这里的分工很清楚:助手改写创作材料,YuE2 负责把修改后的材料变成声音。
“更高级一点”仍然是个难执行的要求。换成“保留副歌音高和节奏,只修改和弦,并解释哪里改变了”,就有了可以对照的结果。即使不熟悉乐理,也能请 Agent 先展示修改前后的差异,再决定是否生成。能检查的地方多了,听完不满意时,也更容易知道下一次该改什么。
官方的《The Last Train》演示给出了 9 个步骤、14 个版本,展示歌曲如何经过多轮讨论,从普通话流行风格转向英文爵士。页面保留了对话、乐谱和各版音频,可以顺着修改过程看,而不只是听一首最终成品。多轮编辑展示是团队选择的案例,不能当成任意一句修改指令都能稳定奏效的保证。
如果自己尝试,我更建议先改一个明确的音乐决定。一次同时换歌词、调速度、重写旋律,变化当然会很大,却不容易判断究竟哪一步起了作用。
自己的录音,怎样进入这条链路
已有录音也能成为起点。官方提供的 SheetSage2 会把录音转成带旋律与和弦信息的乐谱,再由 YuE2 按新的风格生成。这相当于先记下曲子的主要内容,然后重新演绎;转谱的错误也可能一路传下去,所以生成前值得先看一眼乐谱。SheetSage2 模型卡说明了它处理的节拍、调性、结构和旋律等任务。
这周社区还补上了另一条路。Mothersuperior 发布了一个编码器,把真实录音转成 YuE2 能处理的音乐信息单元,也就是语义 token。配套的 LoRA 工具是一种微调方式,可以用额外数据调整模型的生成表现。这条路线主要用于准备录音数据和训练,再生成歌曲。作者提供的模型与脚本属于社区扩展,和官方“录音转乐谱”的功能不是同一件事。
这也解释了 Reddit 讨论里容易出现的误会:能把自己的音乐送进模型,不等于已经有一个成熟的音频局部修改器。对普通使用者,先理解改谱、重新演绎这条路线,比急着训练 LoRA 更容易找到用途。
本地尝试前,把预期放在合适的位置
官方当前推荐 Linux、支持 BF16 数值格式的 24GB NVIDIA 显卡,以及 24GB 可用系统内存。这里的显存是显卡处理任务时使用的内存,与电脑的系统内存分开计算。团队给出的 RTX 4090 热启动测试,也就是模型已完成初始加载后的测试中,生成约 3.6 分钟歌曲平均耗时约 71 秒,记录峰值显存约 11.18GiB;这是特定测试的结果,不能反推所有 12GB 显卡都够用。模型卡还记录了更长上下文达到 14.08GiB 的情况。硬件要求与计时条件应和模型名字一起看。
音质也值得亲自听。官方 WildSongBench 使用 192 组提示评估,best-of-8 指的是生成八个候选后再筛选,不能拿这条成绩当作一次生成的平均体验。它衡量的是指定协议下的自动评分,未必替你回答“这句唱得有没有感情”。评估数据与筛选说明保留了这些条件。
另外,YuE2 权重采用 CC BY-NC 4.0,包含非商业使用限制;下载到本地并不等于适合直接接商业配乐订单。当前发布说明也分别交代了新版本与旧版本、第三方组件的许可边界。
对愿意反复推敲一首歌的人,YuE2 值得关注的理由已经足够具体:生成结束后,桌面上还留着一份能继续修改的乐谱。你可以保留那段喜欢的副歌,试另一组和弦,再听听它往哪里走。
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 录音说错一句话,能让 AI 直接修改吗?AuK 的语音编辑新能力
AuK 是能按文字要求生成和修改语音的 AI 模型。录音念错几个字、语气不合适或有噪声时,它能怎样帮忙?先看一段口播如何返工,再了解效果与本地使用条件。
 本地模型还能快多少?ExLlamaV3 1.5 先省下一次内存搬运
ExLlamaV3 是帮助在自己电脑上运行 AI 大模型的工具,负责加载模型和安排计算。先弄清它在本地 AI 中的作用,再看 1.5 版本如何减少内存搬运、改善等待时间。
 17GB对100GB:Qwen3.8-27B与Flash-Next做同一批任务,省下的容量换来了什么?
同做89项终端任务,17GB的27B首轮完成35项,100GB的Flash-Next完成45项;最多两次是46对53,最多四次是48对60。本文追到9月13日后续结果,区分模型能力、环境故障和返工时间;测试为苹果MLX四位量化,不是GSQ-RCO IQ3_S,也不能套到16GB显卡。