
Grok 4.6 正式发布:AA 智能指数追平 GPT-5.6 Sol,长程 Agent 基准大幅跃升
2026-08-12 xAI 发布 Grok 4.6:定位长时运行 Agent 与交互/视觉工作,AA Intelligence Index 61 分追平 GPT-5.6 Sol,距榜首 Claude Opus 5(63)2 分,较 Grok 4.5 的 56 分提升 5 分。官方 10 项对比中 GDPVal-AA v2(1753 Elo)、AA-Briefcase(1577)、Harvey LAB(15.8%)三项登顶,Terminal-Bench v3.0(26% 对 34.6%)与 DeepSWE(65.9% 对 73%)仍落后 GPT-5.6 Sol。定价 $2/$6 每百万 token、500k 上下文,Cursor、Grok Build、API 与 OpenRouter/Vercel/Cloudflare 可用。本文数据为官方公告与 AA 追踪口径,未做独立实测。
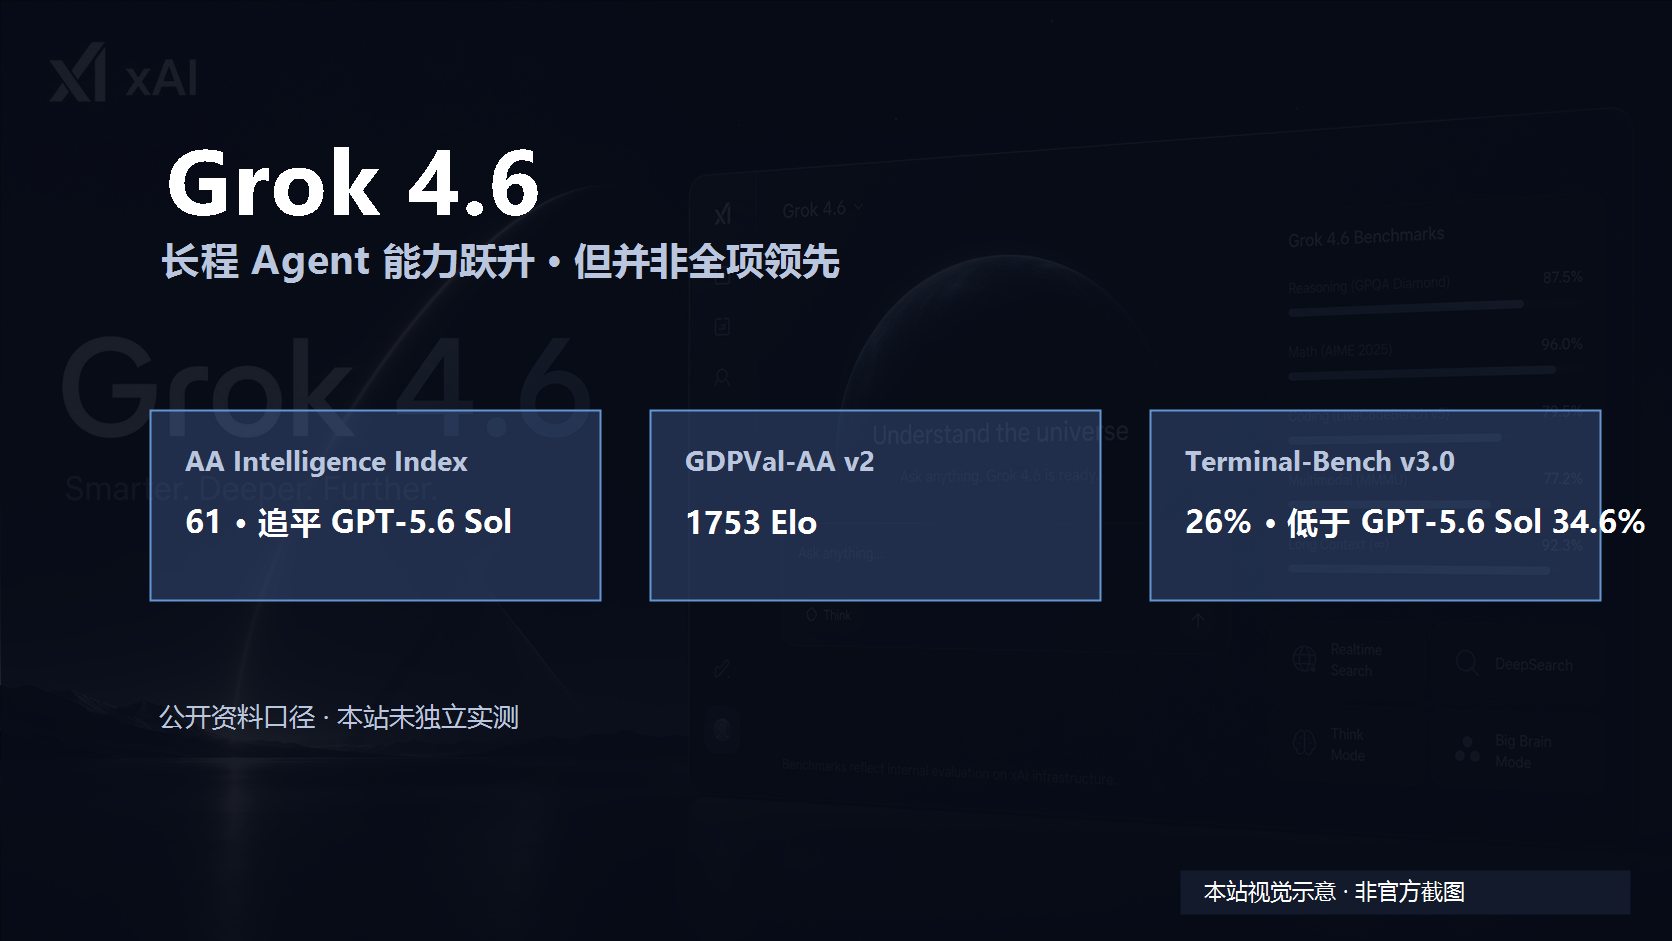
2026 年 8 月 12 日,xAI 发布 Grok 4.6 官方公告。新模型基于 Grok 4.5 打造,重点转向长时运行的 Agent 任务与更有雄心的交互式、视觉类工作:按官方描述,它能在研究主题、分析信息、跨代码库作业、把一个想法变成完整应用或工作产物这类多步骤任务中持续保持在线。模型当天即在 Cursor 与 Grok Build 上线,API 及 OpenRouter、Vercel、Cloudflare 等渠道同步开放,定价为每百万 token 输入 $2 / 输出 $6。
先说结论
- 独立评测机构 Artificial Analysis 给出的 AA Intelligence Index 为 61 分:追平 GPT-5.6 Sol(61),距 Claude Fable 5(62)1 分、距榜首 Claude Opus 5(63)2 分。Grok 第一次在这个综合指数上与 OpenAI 前沿模型并列进入第一梯队。
- 相对自家上一代提升显著:AA 指数从 Grok 4.5 的 56 升至 61;官方 10 项对比中,GDPVal-AA v2 从 1526 升至 1753(+227 Elo)、Terminal-Bench v3.0 从 15.7% 升至 26%、APEX-Agents 从 47.1% 升至 57.5%。
- 但并非全面登顶:Terminal-Bench v3.0(26% 对 34.6%)与 DeepSWE v1.1(65.9% 对 73%)仍明显落后 GPT-5.6 Sol;10 项对比中 Fable 5 Max 拿下 4 项最佳。AA 的结论同样是"智能水平相当、成本更低",而非全面领先。
智能指数:第一次挤进第一梯队
FreeDidi 的中文报道所引用的 Artificial Analysis Intelligence Index v4.1.1 完整榜单,给出了 Grok 4.6 发布后的当前格局:
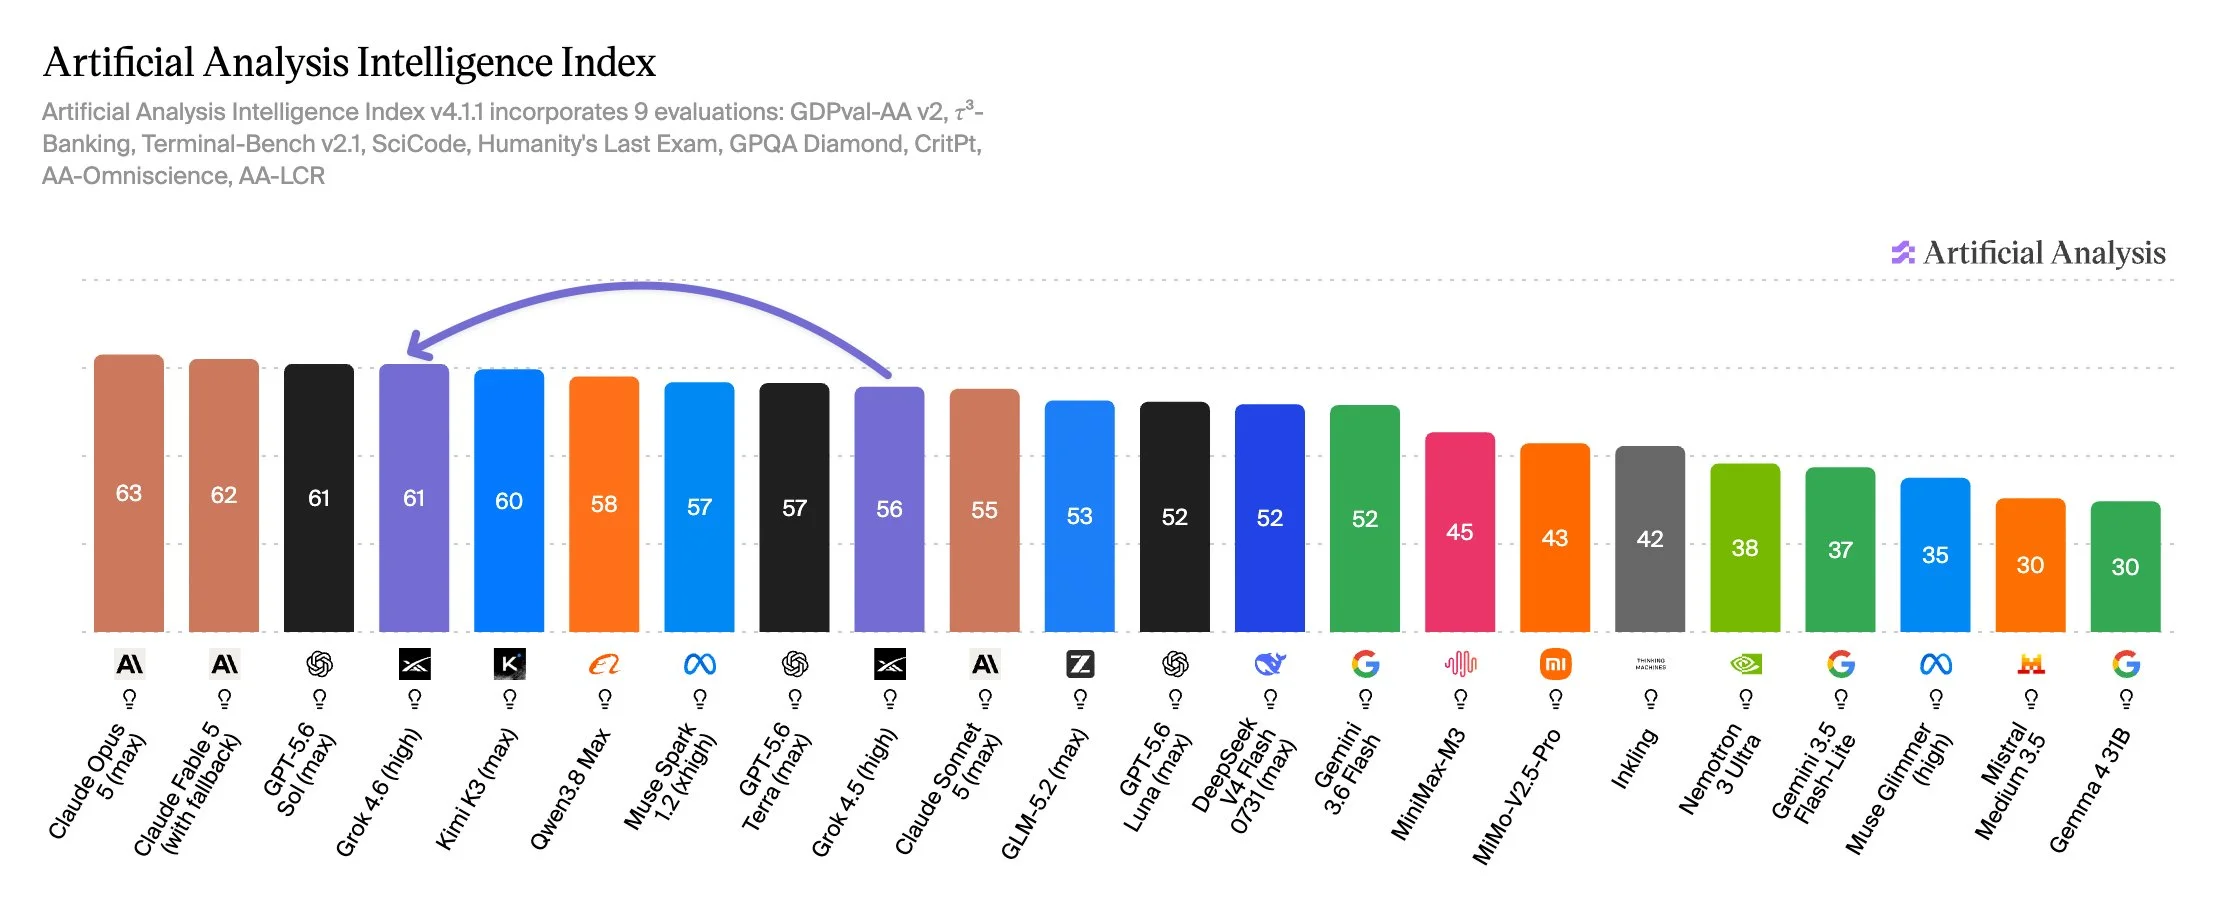
榜单由 9 项评测综合而成(GDPval-AA v2、τ³-Banking、Terminal-Bench v2.1、SciCode、Humanity's Last Exam、GPQA Diamond、CritPt、AA-Omniscience、AA-LCR)。头部排布是:Claude Opus 5(max)63 分居首,Claude Fable 5 62 分第二,GPT-5.6 Sol(max)与 Grok 4.6(high)以 61 分并列第三、四位;Kimi K3(max)60 分、Qwen3.8 Max 58 分紧随其后,Grok 4.5(high)以 56 分排在第 9 位。也就是说,Grok 一代之内提升 5 分、前进 5 个位次,首次与 OpenAI、Anthropic 的当打旗舰站在同一档。值得注意的是,61 分上下正是当前竞争最密集的区间——从 GPT-5.6 Sol 到 Qwen3.8 Max 之间只差 3 分,头部模型之间的实际差距往往体现在单项基准与价格上,而非综合分本身。
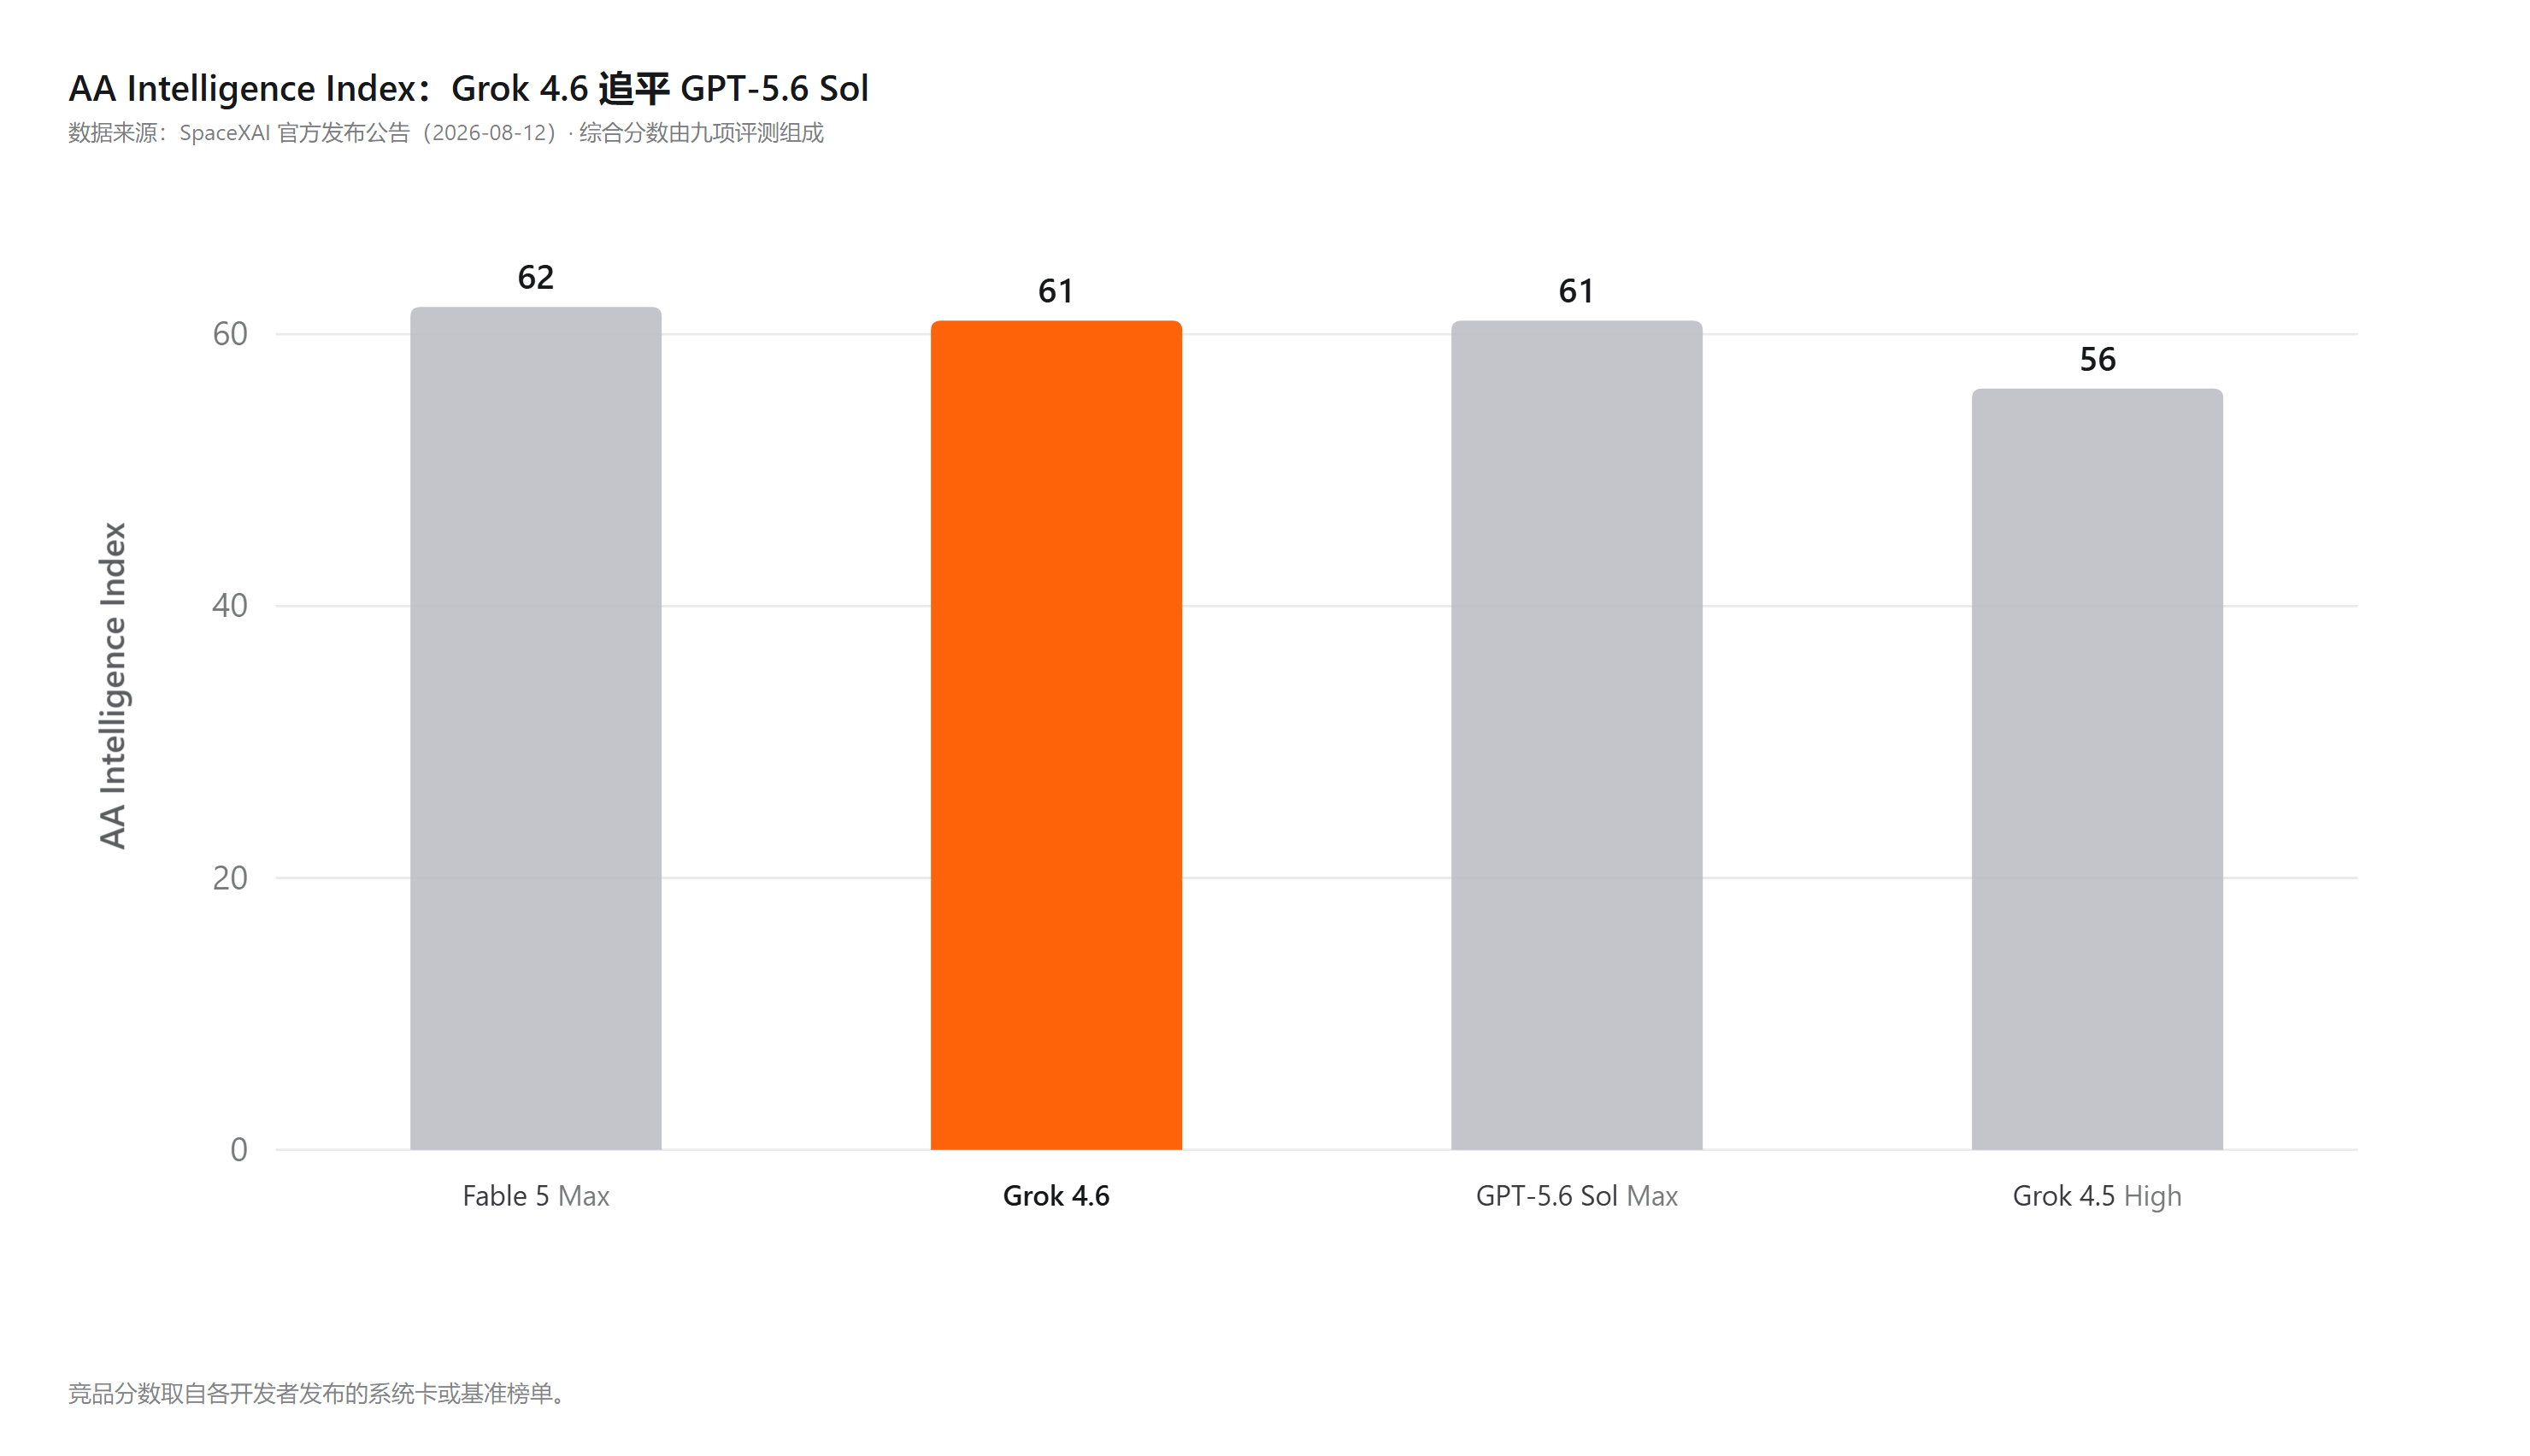
xAI 官方公告的柱状图与之口径一致:Fable 5 Max 62、Grok 4.6 61、GPT-5.6 Sol Max 61、Grok 4.5 High 56,官方明确表述为"在 Artificial Analysis Intelligence Index 上追平 GPT-5.6 Sol"。
官方评测全表:三项登顶,两项短板
xAI 公告给出了 10 项基准的四模型对比(Grok 4.6 对 Grok 4.5、GPT-5.6 Sol、Fable 5,第三方成绩取自各自系统卡或公开榜单的最佳值):
| 基准 | Grok 4.6 High | Grok 4.5 High | GPT-5.6 Sol Max | Fable 5 Max |
|---|---|---|---|---|
| AA Intelligence Index | 61 | 56 | 61 | 62 |
| GDPVal-AA v2(Elo) | 1753 | 1526 | 1728 | 1741 |
| CursorBench v3.2 | 69.9% | 66.7% | 67.2% | 70.5% |
| DeepSWE v1.1 | 65.9% | 54% | 73% | 70% |
| FrontierCode v1.1(Extended) | 61.3% | 56.6% | 60.6% | 63.6% |
| APEX-Agents | 57.5% | 47.1% | 56.7% | 59.2% |
| Terminal-Bench v3.0 | 26% | 15.7% | 34.6% | 34.1% |
| APEX-SWE | 56.4% | 53.6% | — | 58.8% |
| AA-Briefcase(Elo) | 1577 | 1313 | 1502 | 1574 |
| Harvey LAB(Vals) | 15.8% | 12.9% | 2.5% | 11.3% |
Grok 4.6 登顶的三项都偏向知识工作与专业领域:GDPVal-AA v2 1753 Elo 高于 GPT-5.6 Sol 的 1728 与 Fable 5 的 1741;AA-Briefcase 1577 同样居首;Harvey LAB(Vals)15.8% 对 GPT-5.6 Sol 的 2.5% 是数量级差距,Fable 5 也只有 11.3%。AA 的分析文章因此把"GDPval-AA v2 Elo 1753、τ³-Banking 50.7%"列为亮点,并给出"长期复杂任务效率优于 Claude Opus 5"的判断。
短板同样清晰:Terminal-Bench v3.0 上 26% 对 GPT-5.6 Sol 的 34.6%,差 8.6 个百分点;DeepSWE v1.1 上 65.9% 对 73%,差 7.1 个百分点。终端长程任务与真实仓库级软件工程,仍是 GPT-5.6 Sol 的护城河。
训练侧重:更长补充训练与领域 Agent 环境
官方技术说明给出了三个要点。其一,Grok 4.6 经历了比 Grok 4.5 更长的补充训练,使用精选的模型生成推理数据、高质量工程数据,以及改进的优化器与训练配方。其二,团队用 Grok 4.5 重新生成了跨推理档位、跨 Agent harness、跨领域(STEM、软件工程、知识工作)的 SFT 轨迹,并以模型化检查过滤问题轨迹。其三,RL 阶段覆盖大规模 agentic 任务,除知识工作与通用编码外,还包括内核优化、Web 开发、计算机辅助设计(CAD)等领域特定环境。
能力侧的官方观察是:模型更擅长把宽泛的产品想法一次做成可工作的第一版(尤其是视觉与交互项目),并在长轨迹上出现更多自我测试与验证行为——先检查自己的产出再继续推进。对普通用户而言,这意味着在 Cursor 或 Grok Build 里让它从一个模糊需求出发搭出可运行的应用原型时,返工轮次有望减少;而内核优化、CAD 这类通常缺乏公开训练语料的领域被单独建了 RL 环境,也解释了它在知识工作类基准上的超额表现。
安全方面,官方称防护措施随模型能力同步改进与校准,进行了"迄今覆盖面最广"的预部署能力与防护校准测试,并辅以部署后测试与第三方测试;安全栈的目标是在漏洞修补、加速工程设计周期、增强 AI 研究等合法用途上兼顾效用与安全。
价格与可用性
Grok 4.6 定价每百万 token 输入 $2 / 输出 $6,另有两倍价格($4/$12)的 fast 变体;上下文窗口为 500k(AA 口径)。可用渠道包括 Cursor、Grok Build、xAI API、OpenRouter、Vercel 与 Cloudflare,发布首周在 Grok Build 与 Cursor 内提供 2 倍包含用量。AA 分析文章的标题直白地点出了这一定位的意义:"Grok 4.6 将 xAI 带回智能前沿,并领跑成本效率"——同等智能水平下显著更低的价格,是它对 GPT-5.6 Sol、Claude Opus 5 最实际的竞争筹码。
口径与限制
- 官方评测表为 xAI 自报口径,表中第三方模型成绩"取自各自开发方公布的系统卡或基准榜单的最佳值",并非同环境复测。
- Terminal-Bench 存在版本差异:xAI 官方表使用 v3.0(Grok 4.6 为 26%),而 AA 综合指数内纳入的是 Terminal-Bench v2.1(AA 口径下 Grok 4.6 为 88.4%),两者难度不同,不可直接比较。
- AA Intelligence Index 为 9 项基准的加权综合,反映的是"平均智能"而非单项能力;Grok 4.6 的登顶项与落后项差距都很大,选型时应看具体任务画像。
- 本文全部数据来自官方公告、AA 评测与公开报道整理,未做独立实测;AA 榜单为动态口径,后续复测会变动。
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 17GB对100GB:Qwen3.8-27B与Flash-Next做同一批任务,省下的容量换来了什么?
同做89项终端任务,17GB的27B首轮完成35项,100GB的Flash-Next完成45项;最多两次是46对53,最多四次是48对60。本文追到9月13日后续结果,区分模型能力、环境故障和返工时间;测试为苹果MLX四位量化,不是GSQ-RCO IQ3_S,也不能套到16GB显卡。
 Qwen3.8-Flash-Next每秒70词元?本地加速之前,先看模型究竟改了什么
同样叫Flash-Next,70词元/秒背后可能是另一条计算路径:每词元激活专家从10减到5,再训练共享专家补偿。本文对照单台DGX Spark的两套原始资料,拆开量化、MTP、输入速度、输出速度和并发吞吐,不把128GB统一内存结果套到16GB显卡。
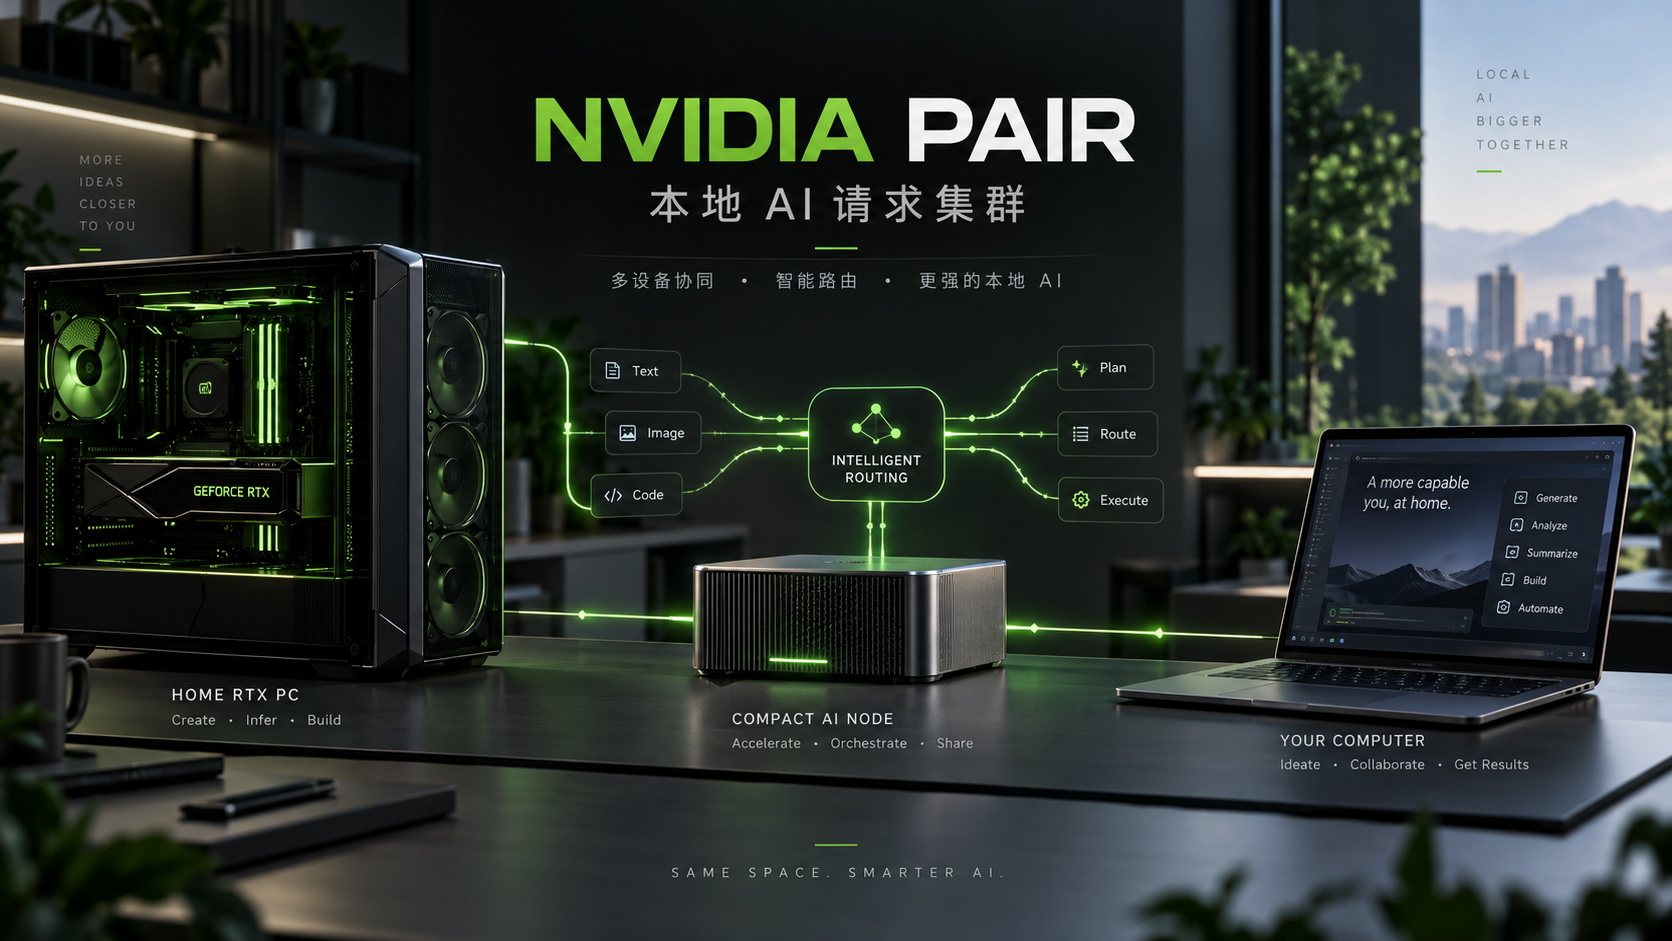 NVIDIA PAIR:把家里的 RTX、DGX Spark 和 Mac 变成本地 AI 请求集群,但它不是“显存池化”
可以把 NVIDIA PAIR 理解成家里本地 AI 的“派单前台”:RTX 主机、DGX Spark、Mac 就像几名能力不同的员工,PAIR 看谁在线、谁装了对应模型、谁现在最空闲,就把下一份 AI 工作交给谁。它特别适合多 Agent 并发,但不会把 16GB + 24GB 显存拼成 40GB,也不会把一个大模型拆到多台机器上。