
三菱汽车与 Highlanders 探索人形机器人进入汽车工厂与量产
三菱汽车与东京大学背景的 Highlanders 签署 MOU,计划探索在人形机器人开发、工厂应用和京都工厂量产方面合作,但目前仍处于可行性评估阶段。

三菱汽车与源自东京大学的机器人公司 Highlanders 于 2026 年 7 月 9 日宣布签署合作备忘录,计划共同探索人形机器人在汽车制造设施中的应用,以及在三菱京都工厂量产 Highlanders 产品的可行性。三菱汽车官方新闻稿
这条信息的价值不在于又一次展示人形机器人动作,而在于合作对象发生了变化:机器人公司获得汽车制造商的工厂、质量和量产能力,汽车制造商则把人形机器人放进自己的生产环境中观察。与此同时,公告仍然是 MOU 和可行性研究,不是已经签署的采购合同,也不是已经完成的量产项目。
MOU 具体提出了什么
三菱汽车表示,双方将探索共同开发用于三菱制造设施的人形机器人,并研究在京都工厂生产 Highlanders 产品。双方计划以现有未使用建筑为基础,评估能否在 2027 年初开始生产。公告将其描述为汽车制造商与人形机器人开发者围绕开发和量产展开的合作。
第一步不是直接宣布大规模部署,而是三菱在自己的制造设施中进行实际使用。公司希望通过实际操作积累运行数据和现场经验,并据此进一步评估未来的开发和生产机会。也就是说,工厂本身被当作验证环境:机器人是否适合生产节拍、如何与现有设备协作、哪些工作需要人工接管,都要通过现场运行才能回答。
汽车制造能力为什么成为关键变量
三菱汽车在公告中列出自己可以带来的能力,包括量产工程、质量保证、耐久性和安全设计、机电一体化控制技术,以及工厂运营经验。这些能力与机器人实验室里的演示不同,它们决定一个机器人能否在长时间、重复性和有明确安全责任的生产环境中工作。
Highlanders 则可以从合作中获得真实工厂的运行数据、制造反馈和量产伙伴。对一家人形机器人公司来说,产品能够完成一次动作并不等于能够稳定交付;关节、执行器、传感器、控制软件和维护流程都要面对生产现场的约束。汽车制造商参与量产可行性研究,至少说明双方开始讨论从原型验证走向工程化的问题。
目前还没有被官方确认的内容
公告没有给出机器人型号、硬件规格、负载、续航、速度、具体工位、试点数量或现场成功率,也没有说明何时开始部署、由谁负责安全认证、2027 年初的生产目标对应多少台设备。文中使用的是“探索”“评估可行性”和“计划”等表述;这也是阅读这份 MOU 时最重要的证据边界。三菱汽车官方新闻稿
因此,不能把这次合作写成三菱已经在工厂全面使用人形机器人,也不能把 2027 年初写成确定量产日期。MOU 更像一个把研发、工厂验证和量产工程连接起来的项目入口。真正的进展还需要后续的试点公告、机器人规格、工位任务、生产计划和安全验证材料支持。
从舞台展示到可重复生产
人形机器人进入制造业后,评价标准会从“能不能完成动作”转向“能不能在约束下持续完成任务”。除了动作能力,还要看任务失败时能否安全停机,人工如何接管,维护和换件是否可行,现场数据能否反馈给控制模型,以及机器人是否会增加新的质量和安全风险。
这也是这条合作值得关注的地方。它把物理 Agent 的问题放进一个有成熟质量体系、工厂流程和安全责任的环境中。不过,以上是基于合作内容的编辑分析,不是三菱或 Highlanders 已经完成的测试结果。当前最稳妥的结论是:双方正在尝试建立从机器人开发、现场验证到制造量产的连接,距离证明商业可行性仍有明显距离。
图片版权需要单独处理
本文封面使用了三菱官方公告页面提供的图片,但该页面明确说明相关创意素材仅限编辑或个人使用,商业使用包括广告、营销和商品化均被禁止。HelloAIFlow 后续若作为公开商业网站内容使用,必须先获得授权,或替换为具有明确可用许可的 Highlanders、三菱官方授权图片。没有完成这一步前,本篇只能作为内部审核草稿,不建议打包导入或发布。三菱汽车官方审阅图片
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 17GB对100GB:Qwen3.8-27B与Flash-Next做同一批任务,省下的容量换来了什么?
同做89项终端任务,17GB的27B首轮完成35项,100GB的Flash-Next完成45项;最多两次是46对53,最多四次是48对60。本文追到9月13日后续结果,区分模型能力、环境故障和返工时间;测试为苹果MLX四位量化,不是GSQ-RCO IQ3_S,也不能套到16GB显卡。
 Qwen3.8-Flash-Next每秒70词元?本地加速之前,先看模型究竟改了什么
同样叫Flash-Next,70词元/秒背后可能是另一条计算路径:每词元激活专家从10减到5,再训练共享专家补偿。本文对照单台DGX Spark的两套原始资料,拆开量化、MTP、输入速度、输出速度和并发吞吐,不把128GB统一内存结果套到16GB显卡。
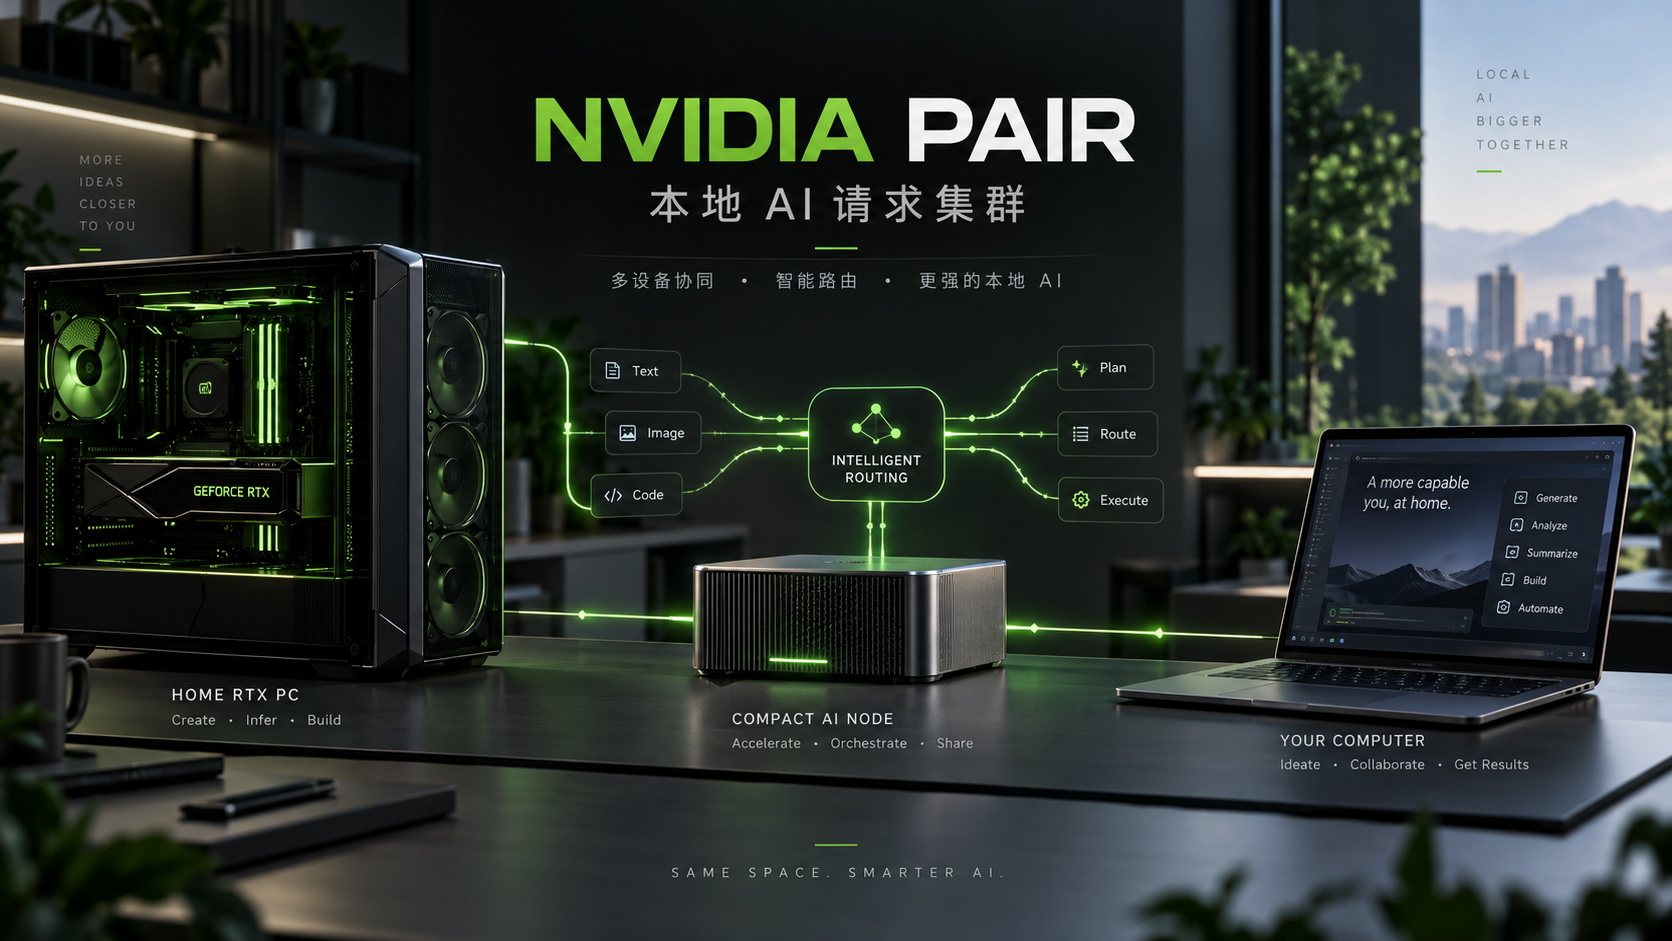 NVIDIA PAIR:把家里的 RTX、DGX Spark 和 Mac 变成本地 AI 请求集群,但它不是“显存池化”
可以把 NVIDIA PAIR 理解成家里本地 AI 的“派单前台”:RTX 主机、DGX Spark、Mac 就像几名能力不同的员工,PAIR 看谁在线、谁装了对应模型、谁现在最空闲,就把下一份 AI 工作交给谁。它特别适合多 Agent 并发,但不会把 16GB + 24GB 显存拼成 40GB,也不会把一个大模型拆到多台机器上。