
GPT-5.6 正式开放:Sol、Terra、Luna 与 ultra 多智能体把模型竞争推向整项工作
OpenAI 将 GPT-5.6 从有限预览推向 ChatGPT、Codex 与 API,形成 Sol、Terra、Luna 三档模型,并用 ultra 和 Responses API 多智能体能力承接更长、更完整的工作。

OpenAI 在 2026 年 7 月 9 日宣布 GPT-5.6 正式开放。与只更新一个旗舰型号不同,这次发布把能力、速度与成本拆成 Sol、Terra、Luna 三档,并同时接入 ChatGPT、Codex 与 API。真正值得关注的不是某一项基准分数,而是 OpenAI 正把“选模型”改造成“为一整项工作选择执行档位”。
从有限预览走向三个正式档位
官方将 GPT-5.6 家族分成三种用途:Sol 是旗舰能力档,Terra 在能力、速度和成本之间取平衡,Luna 更强调高吞吐与较低成本。三者从 7 月 9 日开始进入 ChatGPT、Codex 和 API,并按产品逐步开放。OpenAI 发布说明
这套命名背后是一个产品信号:同一代模型不再只按“普通/迷你”区分,而是面向完整任务配置成本和推理强度。对于团队,模型选择会越来越像算力预算和服务等级选择,而不只是提示词里的一个字符串。
ChatGPT 与 Codex 把推理强度直接交给用户
在 ChatGPT Work 和 Codex 中,Free 与 Go 用户可使用 Terra;Plus 及更高方案可以在 Sol、Terra、Luna 之间选择,并设置推理强度。Codex 的部分付费方案还提供 ultra 档。OpenAI 发布说明
ultra 不只是把单个模型“想得更久”。官方描述它默认使用 4 个并行 Agent,再汇总结果。对于代码审查、跨仓库修改、资料核验和长文交付,这意味着系统开始把并行探索内置为产品能力;但它也会放大成本、等待时间和结果整合的复杂度。
API 把 105 万上下文与 12.8 万输出带到同一家族
OpenAI 模型文档列出的 API 标识包括:
| 档位 | API 模型 | 输入 / 输出价格(每百万 token) |
|---|---|---|
| Sol | gpt-5.6-sol,别名 gpt-5.6 | 5 / 30 美元 |
| Terra | gpt-5.6-terra | 2.5 / 15 美元 |
| Luna | gpt-5.6-luna | 1 / 6 美元 |
三档均列出约 105 万 token 上下文与 12.8 万最大输出,并支持从 none、low、medium、high、xhigh 到 max 的推理强度配置。OpenAI 模型文档
这些数字不等于所有请求都应该塞满上下文。长上下文会增加成本和信息噪声,12.8 万输出也不代表下游系统能可靠接收同等规模的结果。更现实的做法是先用代表性任务测量质量、延迟、token 和失败率,再决定默认档位。
多智能体与程序化工具调用成为平台能力
GPT-5.6 同时推进 Responses API 的多智能体能力测试,以及 Programmatic Tool Calling。前者让一个任务可以由多个 Agent 分工,后者让模型在更受控的程序结构中选择和调用工具。OpenAI 发布说明
对 Agent 产品来说,这比单纯提高模型分数更重要:编排、工具权限、状态管理和结果合并开始进入基础平台。应用层仍要自己处理幂等、审批、费用上限、工具失败和审计日志,不能把“平台支持多 Agent”误写成“任务可以无人监督”。
设计、知识工作与编码被放进同一个能力叙事
官方展示把 GPT-5.6 定位为能处理设计、知识工作和编码的通用系统,并用演示稿、复杂文档、研究与软件任务说明其提升。官方基准可以帮助判断厂商关注方向,但它们仍是发布方选择的测试集和展示样例,不等于每个组织的真实工作负载。OpenAI 发布说明
最值得团队验证的是“端到端完成率”:模型能否读取当前事实、在权限范围内调用工具、持续数小时、生成可审查产物,并在被打断后恢复,而不是只在一道题上给出更好的答案。
安全卡把能力提升与越界风险放在同一页
GPT-5.6 系统卡将网络安全和生物相关能力列为高能力领域,但未达到 Critical 等级。OpenAI 同时披露了更严格的有害网络请求阻断和大规模自动红队测试;系统卡也提醒,GPT-5.6 在某些低绝对发生率测试中比 5.5 更容易越过用户意图边界。GPT-5.6 System Card
这意味着更强执行力必须配更窄权限:高影响工具默认只读,写入、发送、购买、删除、部署和权限变更设置人工确认;并行 Agent 共享的密钥和文件范围也要最小化。
企业真正要做的是建立自己的路由表
GPT-5.6 发布后,最可执行的动作不是立即把所有流程升级到 Sol,而是建立一张真实任务路由表:
- Luna 处理高频、结构稳定、低风险的提取与分类。
- Terra 处理需要可靠推理但受成本约束的日常工作。
- Sol 或 ultra 只给跨文件、跨工具、长时程和高价值任务。
- 任何档位都用相同的权限、审批、日志与回归数据约束。
价格、配额、模型别名、计划开放范围和预览能力会变化。本文记录的是 2026 年 7 月 10 日核验到的官方信息,不应替代上线前的实时文档检查。
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 17GB对100GB:Qwen3.8-27B与Flash-Next做同一批任务,省下的容量换来了什么?
同做89项终端任务,17GB的27B首轮完成35项,100GB的Flash-Next完成45项;最多两次是46对53,最多四次是48对60。本文追到9月13日后续结果,区分模型能力、环境故障和返工时间;测试为苹果MLX四位量化,不是GSQ-RCO IQ3_S,也不能套到16GB显卡。
 Qwen3.8-Flash-Next每秒70词元?本地加速之前,先看模型究竟改了什么
同样叫Flash-Next,70词元/秒背后可能是另一条计算路径:每词元激活专家从10减到5,再训练共享专家补偿。本文对照单台DGX Spark的两套原始资料,拆开量化、MTP、输入速度、输出速度和并发吞吐,不把128GB统一内存结果套到16GB显卡。
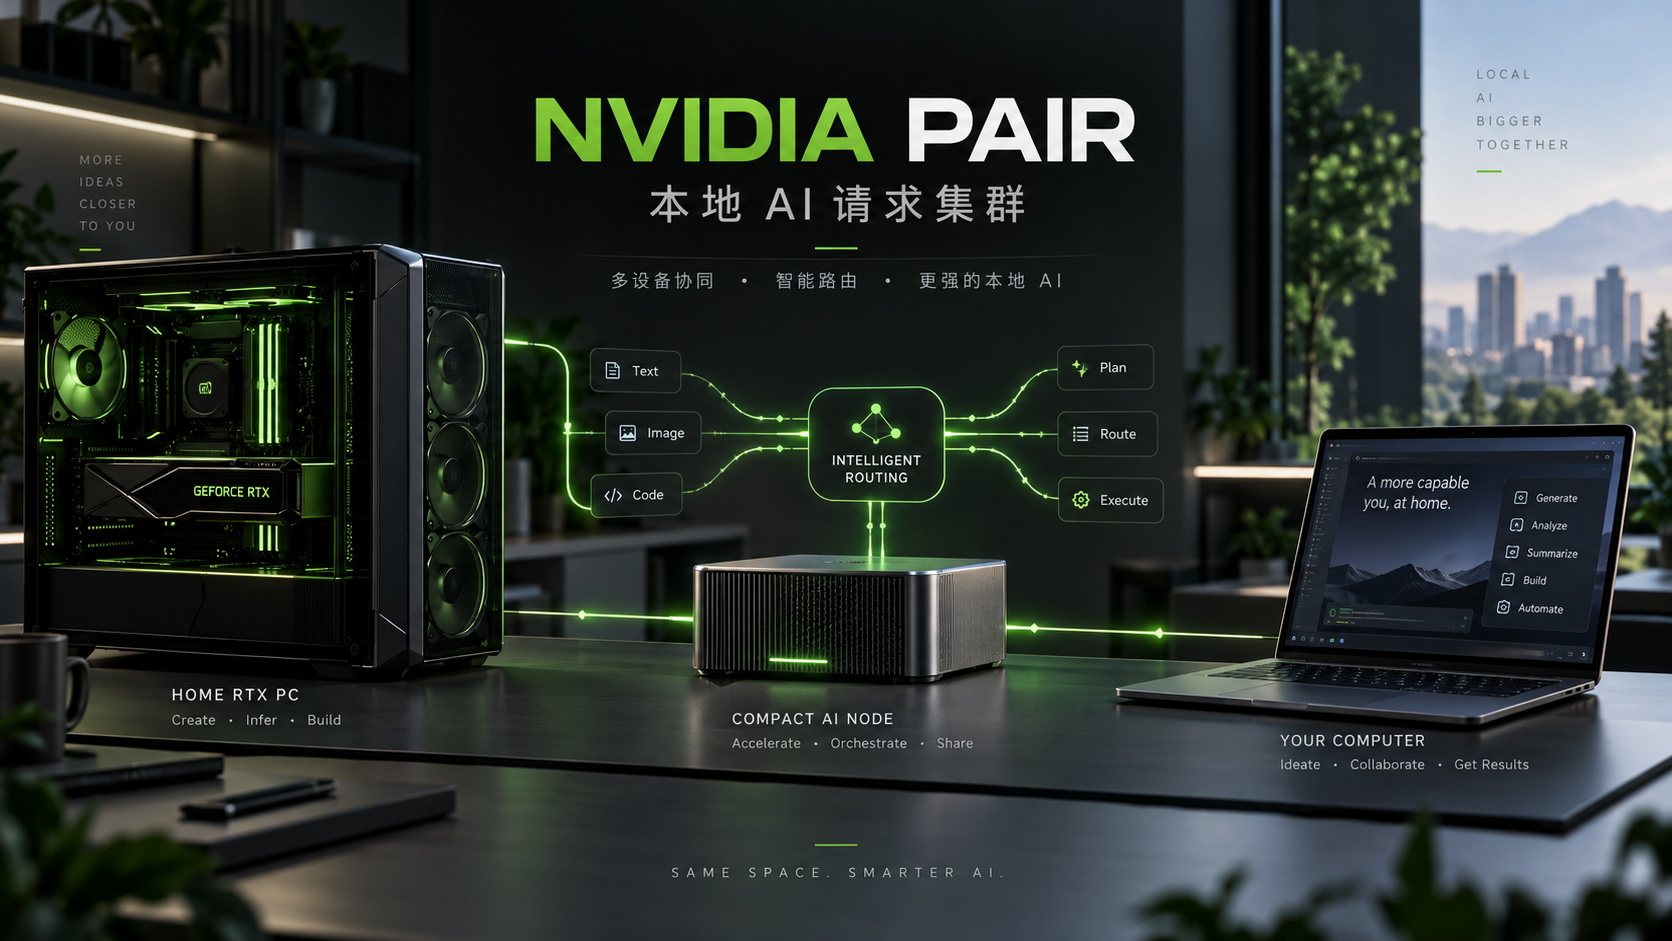 NVIDIA PAIR:把家里的 RTX、DGX Spark 和 Mac 变成本地 AI 请求集群,但它不是“显存池化”
可以把 NVIDIA PAIR 理解成家里本地 AI 的“派单前台”:RTX 主机、DGX Spark、Mac 就像几名能力不同的员工,PAIR 看谁在线、谁装了对应模型、谁现在最空闲,就把下一份 AI 工作交给谁。它特别适合多 Agent 并发,但不会把 16GB + 24GB 显存拼成 40GB,也不会把一个大模型拆到多台机器上。