Bonsai 2 27B 资料评测:5.95GB 保留了什么,又牺牲了什么?
从14项公开测试、两种三值封装和社区同硬件速度对照,拆解 Bonsai 2 的压缩收益与能力代价。98.2% 是平均分比值,不是每项能力都几乎无损;文件更小,也不代表任意显卡能跑满长上下文。
2026 年 9 月 17 日,PrismML 发布 Ternary Bonsai 2 27B,将基于 Qwen3.8-27B 的语言模型压缩到约 6GB,同时宣称保留原模型约 98.2% 的综合表现。对想在普通显卡上运行较大模型的人,这个组合很有吸引力:不只是少下载几十GB,更可能减少显存压力。官方发布说明
不过,“6GB”“98.2%”和“每秒上百 token”分别回答体积、测试平均分和特定硬件速度,不能拼成“任何电脑都能无损运行”的结论。本文评测对象固定为 Bonsai 2 27B,不混用七月的老 Bonsai 27B 或第三方改版;依据截至 2026 年 9 月 27 日的模型卡、官方说明与社区实验进行资料评测,没有把公开结果称为本站实测。
三值模型节省的,首先是权重存储与搬运
Ternary(三值,读音 tur-nuh-ree)指的是用 −1、0、+1 三种符号表达权重,再结合分组缩放因子表示幅度。Bonsai 2 的低位表示覆盖语言模型的嵌入、注意力投影、前馈网络和输出头,不只是把模型文件在磁盘上压成一个压缩包。官方技术说明
可以把它理解成缩短模型内部数字的表示方式:原来每个权重要占较多位,现在用更紧凑的编码存储。这样有机会减少推理时读取权重的数据量。但编码变小以后,运行程序还必须知道怎样正确计算;模型文件小,不代表原有软件无需适配,也不代表所有算术都会自动变成廉价的整数运算。
最终效果取决于权重转换、缩放方式和推理内核共同工作。三值这个名字本身不保证准确率,速度也不只由文件大小决定。因此,先看它交付了哪些文件,再看能力测试,会比直接比较宣传数字更清楚。
两种 GGUF 封装,不是两种聪明程度
官方提供两种主要 GGUF 封装。GGUF 是本地推理常用的模型文件格式;这里的具体编码并不意味着所有支持 GGUF 的软件都已经支持它。
| Bonsai 2 语言模型封装 | 文件体积 | 模型卡给出的有效位宽 | 特点 |
|---|---|---|---|
| PTQ1_0 | 5.95GB | 约 1.75 bit/权重 | 三值打包更紧凑 |
| PQ2_0 | 7.21GB | 约 2.13 bit/权重 | 每个三值占一个2位槽,部分计算路径更方便 |
这些数字来自官方 GGUF 模型卡。二者是同一三值模型的不同封装,不应简单写成“7.21GB 版更聪明”或“5.95GB 版一定更快”。格式开销、有效位宽和理论编码密度也不是同一个概念。
对照原模型时,还要注意一次已经发生的资料修订。当前模型卡给出的文件体积是:FP16 为 54.66GB,UD-Q4_K_XL 为 17.56GB,IQ2_XXS 为 7.27GB。旧资料中 IQ2_XXS 的 9.4GB 已被更正,不能继续拿那个数字放大 Bonsai 的优势。官方修订记录
按当前文件体积计算,54.66÷5.95 约为 9.19。也就是说,最紧凑封装的语言模型文件约为 FP16 的九分之一;这是文件体积之比,不是运行显存、每次调用费用或速度的同比例变化。
98.2% 是怎样算出来的?
官方模型卡列出 14 项思考模式测试。下面保留完整分项,以 Qwen3.8-27B FP16 为基线;“变化”是百分点差,不是相对百分比。所有成绩均为厂商自报,本文复核的是表内关系和计算,不是重新执行测试。
| 测试 | FP16 基线 | Bonsai 2 | 变化 |
|---|---|---|---|
| MMLU-Redux,知识与理解 | 91.46 | 89.09 | −2.37 |
| MuSR,多步推理 | 79.63 | 70.63 | −9.00 |
| GSM8K,数学应用题 | 97.19 | 96.66 | −0.53 |
| MATH-500,数学 | 99.80 | 98.80 | −1.00 |
| AIME25,竞赛数学 | 96.67 | 95.00 | −1.67 |
| AIME26,竞赛数学 | 94.58 | 95.83 | +1.25 |
| HumanEval+,代码生成 | 93.29 | 95.12 | +1.83 |
| MBPP+,编程问题 | 83.86 | 83.07 | −0.79 |
| LiveCodeBench,代码能力 | 90.05 | 90.07 | +0.02 |
| IFEval,指令遵循 | 91.50 | 91.31 | −0.19 |
| IFBench,prompt-loose 口径 | 71.00 | 74.00 | +3.00 |
| BFCL v3,工具调用 | 76.74 | 74.92 | −1.82 |
| MMMU-Pro,多模态理解 | 81.73 | 75.49 | −6.24 |
| OCR Bench v2,图中文字识别 | 60.99 | 56.88 | −4.11 |
| 14 项平均 | 86.32 | 84.78 | −1.54 |
来源:模型卡原始表与修订历史。用公布的平均分计算,84.78÷86.32≈98.22%,与 98.2% 的宣传口径吻合。
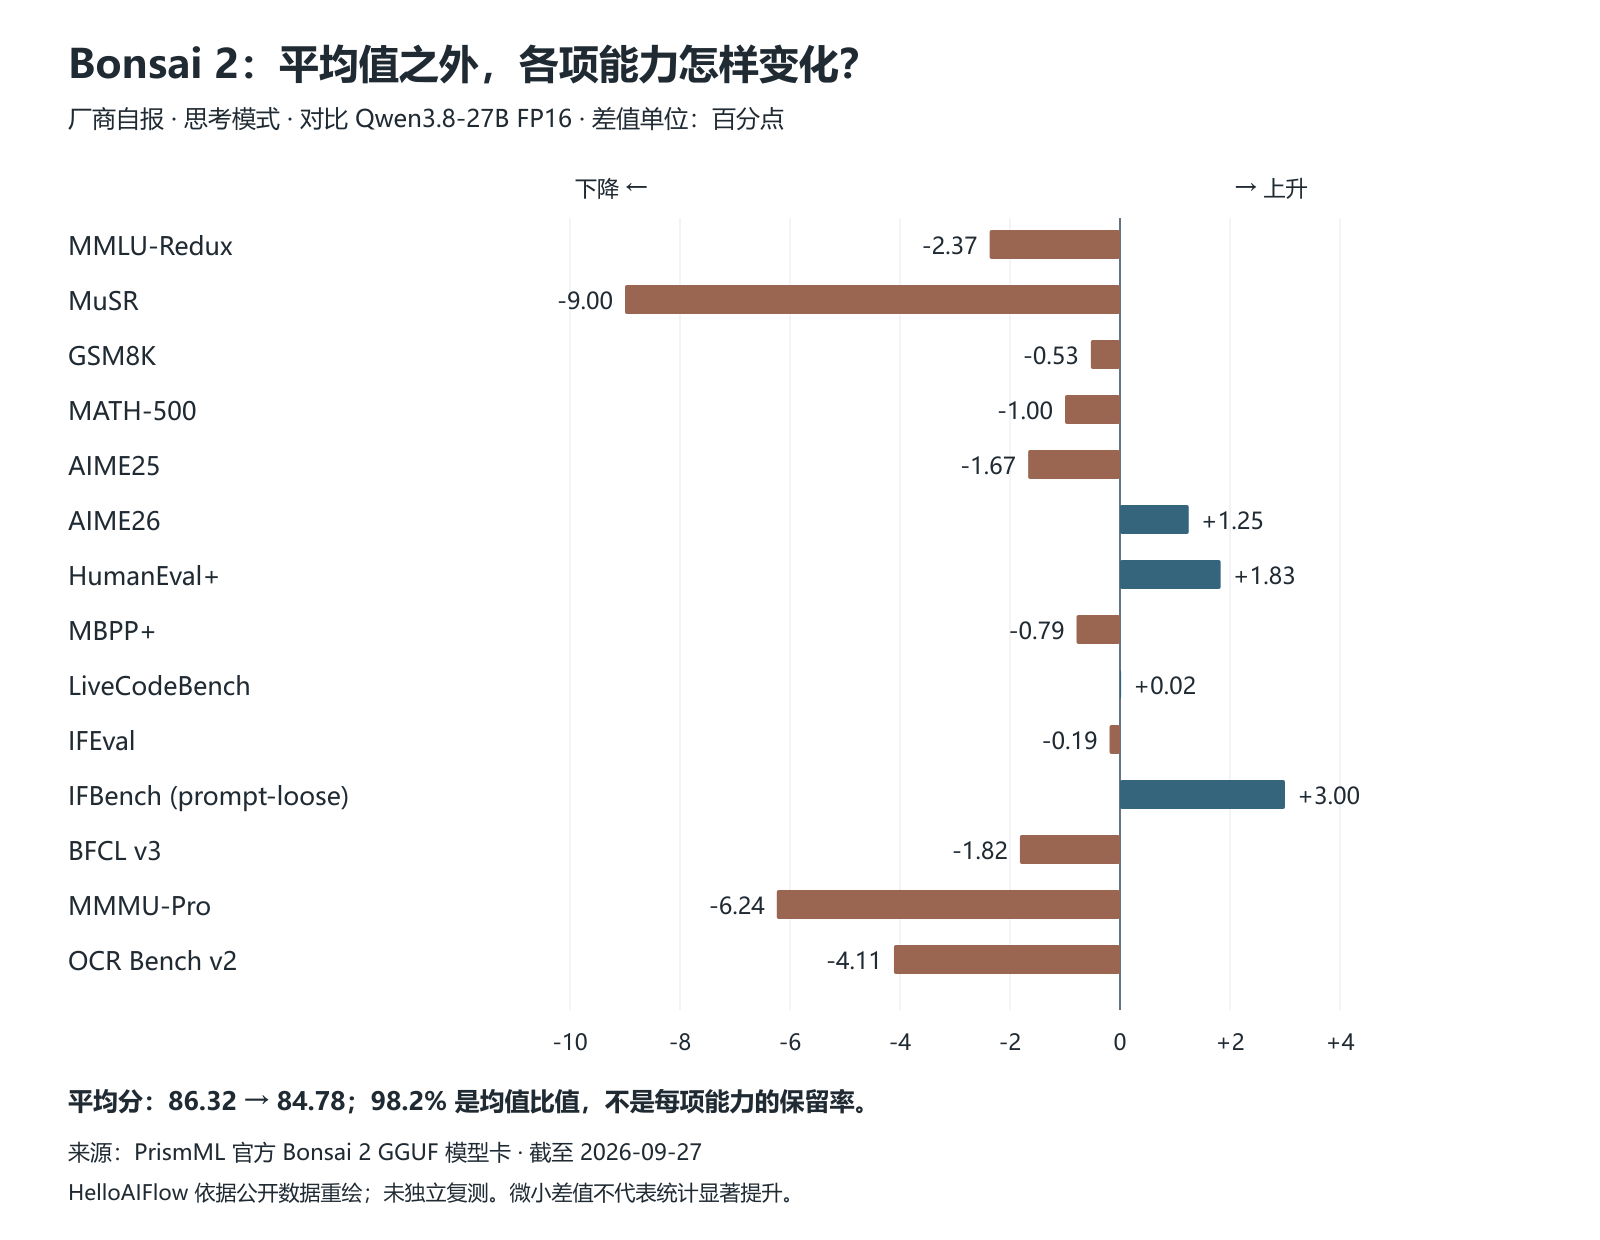
*图:HelloAIFlow 根据上述厂商自报成绩重绘。横轴为相对 FP16 的百分点差,零点左右分别表示下降和上升;图表不是本站复测,微小正差也不代表统计上确定改善。*
但这个结果只表示这组平均分的比值。它不是单次任务成功率,更不是每项能力都只下降 1.8%。将 14 项成绩等权平均,本身就是一种汇总选择;实际使用者可能把截图里的数字准确性看得比一道数学题重要得多。
官网技术文章还列出另一组 20 项测试,综合分为 83.9 对 85.4,同样得到约 98.2%。这与模型卡的 14 项不是同一个测试组合,不能交叉取分数计算,也不能把它们画成版本更新前后的进步。官网的另一组评测口径
平均分没有说出的取舍:视觉与部分推理降得更多
先看保留较好的部分。数学多数分项接近基线;代码指标中,LiveCodeBench 基本持平,HumanEval+ 略高,MBPP+ 略低。它们支持“在这组测试中保留了较多数学与代码能力”,不支持“代码能力确定变强”:没有运行波动和置信区间时,尤其不能把 +0.02 当作有意义的进步。
再看下降较大的部分。MuSR 低 9 个百分点,MMMU-Pro 低 6.24,OCR Bench v2 低 4.11。把它们藏在 98.2% 的平均值后面,会让读者错判自己的用途。完整分项依据
例如,把后台界面截图转成结构化文档,需要识别小字、表格、数字和控件关系。这种工作不能仅凭代码成绩决定模型选择。公开视觉分项的下降并不能精确预测某张截图会错几个字,却足以提示:这类任务需要单独设置验收材料。
类似地,BFCL 的工具调用分数接近基线,不等于一个几十步智能体流程一定稳定。工具选择、参数组织、执行后的状态判断、出错后的恢复,可能在长流程中相互影响。不能把“平均保留率”当作每一步成功概率,再套公式算出一个并不存在的工作流成功率。
5.95GB 能放进去,不代表完整任务只占 5.95GB
运行一个本地模型,至少要同时考虑几类内存:语言权重、上下文缓存、计算缓冲,以及可能使用的视觉组件。桌面显示和其他程序也可能占用显存。模型文件是其中一部分,而不是总预算。
官方宣称支持 262K 上下文,但这是能力范围,不是所有设备的运行保证。不同上下文长度、缓存精度、批量大小和视觉设置,都会影响实际峰值。模型卡的部署说明也将视觉组件与语言模型区分开来。GGUF 部署与组件说明
平台之间也不能只搬一个数字。MLX 版本的模型卡显示,语言模型与视觉塔合计约 8.60GB;它不是 5.95GB GGUF 文件换了一个名字。MLX 官方说明
对 16GB 显卡用户,可以合理预期更小的语言权重留下更多空间,但留下多少、是否足够同时跑视觉或其他模型,需要实际测量。对 8GB 显卡,余量更小,“权重文件小于8GB”更不能直接证明完整长上下文任务可用。
这也是为什么本文不按显卡型号填写推测速度或最大上下文表。缺少对应运行记录时,写“待验证”比按带宽比例算出一个看似精确的结果更可靠。
有多快?先看一组相对干净的同机器比较
官方介绍给出了 RTX 5090 最高 143 token/秒等结果。它可以作为厂商展示的上限线索,但需要和具体封装、后端、输入长度一起看,不能拿来代表所有消费级显卡。官方性能介绍
更有参考价值的是 NoLlama 项目作者公开的一组对照:RTX 5090、同一 PrismML CUDA 二进制,两边都不启用推测解码。作者记录了预热与重复运行,并公开测试材料和结果位置。NoLlama 原始测试记录
| 模型 | 自由文本生成速度 | 约4,411 token的提示词处理速度 |
|---|---|---|
| Bonsai 2 PQ2_0 | 131 token/秒 | 3135 token/秒 |
| Qwen3.8-27B Q4_K_M | 79 token/秒 | 2860 token/秒 |
这组记录中,生成速度约为 1.66 倍,而提示词处理的差距小得多。两者不能合并成“完成任何任务都快1.66倍”:长材料问答可能花很多时间读输入,某些任务还会产生更长思考或更多重试。
它仍然是单个社区实验,而非全面独立评测。作者另列的 23 道简单探针中,两者在思考模式下都是 23/23;这种小样本可以发现明显故障,却不足以证明复杂任务质量相等。速度对照也不能替代中文文档、视觉或多轮工具任务的测试。
更小的封装,甚至不一定读得更快
官方仓库收录了一组社区提交的 RTX 5080 16GB、Windows CUDA 微基准。PP512 表示处理 512 个输入 token 的吞吐,TG128 表示生成 128 个 token 的吞吐,二者都是 token/秒。
| 封装 | PP512 | TG128 |
|---|---|---|
| PQ2_0,7.21GB | 1688 | 86.3 |
| PTQ1_0,5.95GB | 896 | 84.6 |
来源:社区微基准汇总。在这个配置下,较大的封装处理提示词明显更快,两者生成速度却很接近。这说明编码紧凑程度与实际内核效率之间存在取舍。
这组 512-token 微基准,不应与前面的约4.4K-token服务端测试放进同一张跨显卡排名图。它们的输入、测量方法和环境不同;比较时首先要保持条件相同,再讨论硬件差别。
软件是否支持,不能只看文件扩展名
当前官方 Demo 要求使用 PrismML 的 llama.cpp 分支处理 Bonsai 2 的特定格式。通用 GGUF 支持、旧 Bonsai 格式支持和 Bonsai 2 两种封装支持,不是同一件事。官方运行说明
Ollama 的公开问题也记录了 0.34.2 对相关文件导入失败的情况。这个记录说明当时那个版本存在兼容问题,不代表所有未来版本永远不支持;同样,别的程序能打开一个 GGUF,也不代表已经正确使用了所需的计算内核。具体问题与版本记录
对已有稳定本地服务的用户,更合理的验证方式是保留原配置,在隔离目录和独立端口检查新后端:先确认模型加载、输出合理、硬件确实参与推理,再检查任务质量。本文没有运行这些步骤,也没有为了评测替换现有服务。
这里要付出的成本不仅是模型下载,还有运行版本维护、客户端兼容、视觉组件与缓存设置。若某个模型理论上省下显存,却让常用工具链频繁失效,真实收益就会缩小。
是否值得换,要用自己的失败类型判断
对于原本受显存限制、愿意维护专用后端的人,Bonsai 2 提供了值得研究的选择:语言权重明显更小,部分 CUDA 设备上也有社区提速证据。对于已有足够快、足够稳定的量化模型的人,换模型的理由不能只有“98.2%”这一个数字。
一组有实际价值的对照材料,可以包括中文需求整理、字段与数字抽取、含小字的界面截图,以及带失败恢复的多轮工具任务。比较时固定输入、提示词、执行框架、思考预算和验收标准,同时记录完整耗时与峰值内存;若只改变模型文件,还应确认视觉、缓存和后端没有悄悄改变。
目前最稳妥的结论是:Bonsai 2 的压缩收益有明确文件证据,部分硬件的提速有社区支持,而视觉与部分推理的损失同样出现在公开数据里。代码和数学成绩保留较好,不能替代高精度视觉或长期执行验证;文件缩到约6GB,也不能替代完整内存预算。
小模型真正有价值的时刻,不是宣传图上的文件块变小了,而是它在更有限的硬件上,仍能把你需要的工作做对。Bonsai 2 已经给出了值得继续验证的证据,但换不换现有模型,应由具体任务的结果决定。
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 Meta Muse:给 AI 一台云端电脑,它能替你处理多少事务?
Meta 在 Connect 2026 继续扩展 Muse 的连接器、语音与眼镜计划。从专属云端电脑、持续任务到独立权限检查,看看个人智能体怎样从回答问题走向代办事务,以及哪些能力仍不能当作已经全面开放。
 GLiNER2.5-Decide:哪些选择题,不必再让大模型长篇推理?
Fastino 发布可本地运行的结构化决策模型。它怎样给候选答案打分、让多个判断遵守共同约束?结合英文测试、CPU 与 GPU 延迟,以及多语言版本的区别,解释它适合分担哪些工作、不能替代什么。
 GPT-6 Sol、Luna 能力与成本评测:接近哪些旗舰,做完工作能省多少?
一张表按综合能力从高到低比较国内外主流模型,一张表按统一用量费用从高到低比较九家厂商的官方价格。最后给出我们对旗舰选择、日常主力和低成本任务的判断,看清 Sol、Luna 的位置与取舍。