
论文比较 AI 编码 Agent 与人类开发者修改代码的差异
研究使用 GitHub PR 数据比较 AI Agent 和人类贡献者的提交差异,显示 Agent 生成的 PR 在提交数量、涉及文件和描述一致性上呈现不同特征。

大规模 PR 研究:AI 编码 Agent 修改代码的方式不同于人类开发者
arXiv 论文《How AI Coding Agents Modify Code: A Large-Scale Study of GitHub Pull Requests》研究的是 AI coding agents 在真实 GitHub pull requests 中如何修改代码。论文提交于 2026 年 1 月 24 日,并在 2026 年 4 月 6 日更新到 v3,已被 MSR 2026 Mining Challenge Track 接收。
作者使用 MSR 2026 Mining Challenge 版本的 AIDev 数据集,分析 24,014 个已合并的 Agentic PRs,包含 440,295 次 commits,同时对比 5,081 个已合并的 Human PRs,包含 23,242 次 commits。研究关注 additions、deletions、commit 数量、触及文件数量,以及 PR 描述与实际 diff 之间的一致性。
研究对象是真实合并 PR,而不是基准题
这篇论文的价值在于,它没有只看 coding agent 在 benchmark 上能不能解题,而是观察它们进入 GitHub 协作流程后的实际贡献形态。
AI coding agents 正在从代码补全工具变成更自主的贡献者:它们可以根据开发者提供的任务描述生成完整 PR。这和传统 Copilot 式补全不同,因为 Agent 不只是补几行代码,而是会提交一组变更、写 PR 描述、触及多个文件,并参与真实项目协作。
因此,研究重点不只是“Agent 能否写对代码”,而是它们写出来的 PR 和人类 PR 在规模、结构和描述方式上是否有系统差异。
Agentic PR 在 commit 数量上差异最明显
论文摘要显示,Agentic PRs 与 Human PRs 在 commit count 上有显著差异,Cliff's delta 为 0.5429。它们在触及文件数量和删除行数上也表现出中等程度差异。
这说明 AI Agent 生成的 PR 并不是简单复制人类开发者的提交模式。Agent 可能更倾向于用不同粒度组织改动,或者在任务执行过程中产生更多结构化提交。
对团队来说,这类差异会影响代码审查体验。一个 PR 的 commit 数量、触及文件范围和改动行数,都会影响 reviewer 判断任务复杂度、风险范围和审查成本。如果 Agentic PR 的形态系统性不同,团队就需要重新调整 review 预期。
PR 描述与 diff 的一致性略高
论文还评估了 PR descriptions 与 diffs 之间的一致性,包括 lexical 和 semantic similarity。摘要显示,Agentic PRs 在所有度量上都表现出略高的 description-to-diff similarity。
这可能反映出 Agent 在生成 PR 描述时,更容易直接围绕实际 diff 总结改动。相比人类开发者,有些人类 PR 描述可能更简略、更口语化,或者遗漏部分细节;Agent 则可能因为自动读取 diff 和生成说明,在文本一致性上更稳定。
不过,一致性更高并不等于质量一定更高。它只能说明 PR 描述和代码差异之间更接近,不能直接证明实现正确、设计合理或维护成本更低。这也是团队不能只依赖自动描述的原因。
这类研究会改变团队看待 AI 贡献的方式
这篇论文给出的不是一个工具结论,而是一种观察视角:AI coding agents 进入开源协作后,会在 PR 层面留下可测量的行为差异。
这对仓库维护者和企业研发团队都有现实意义。未来团队可能需要区分 Agentic PR 和 Human PR,设置不同的审查策略。例如,Agentic PR 如果触及更多文件或提交结构不同,就需要更重视自动测试、影响范围分析和人工 review。
对研究者来说,这类数据也会影响软件工程研究本身。如果不区分人类 PR 和 Agentic PR,未来分析开发效率、贡献者行为或开源协作模式时,可能会把 AI 工具带来的变化误读为人类行为变化。
参考来源
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 17GB对100GB:Qwen3.8-27B与Flash-Next做同一批任务,省下的容量换来了什么?
同做89项终端任务,17GB的27B首轮完成35项,100GB的Flash-Next完成45项;最多两次是46对53,最多四次是48对60。本文追到9月13日后续结果,区分模型能力、环境故障和返工时间;测试为苹果MLX四位量化,不是GSQ-RCO IQ3_S,也不能套到16GB显卡。
 Qwen3.8-Flash-Next每秒70词元?本地加速之前,先看模型究竟改了什么
同样叫Flash-Next,70词元/秒背后可能是另一条计算路径:每词元激活专家从10减到5,再训练共享专家补偿。本文对照单台DGX Spark的两套原始资料,拆开量化、MTP、输入速度、输出速度和并发吞吐,不把128GB统一内存结果套到16GB显卡。
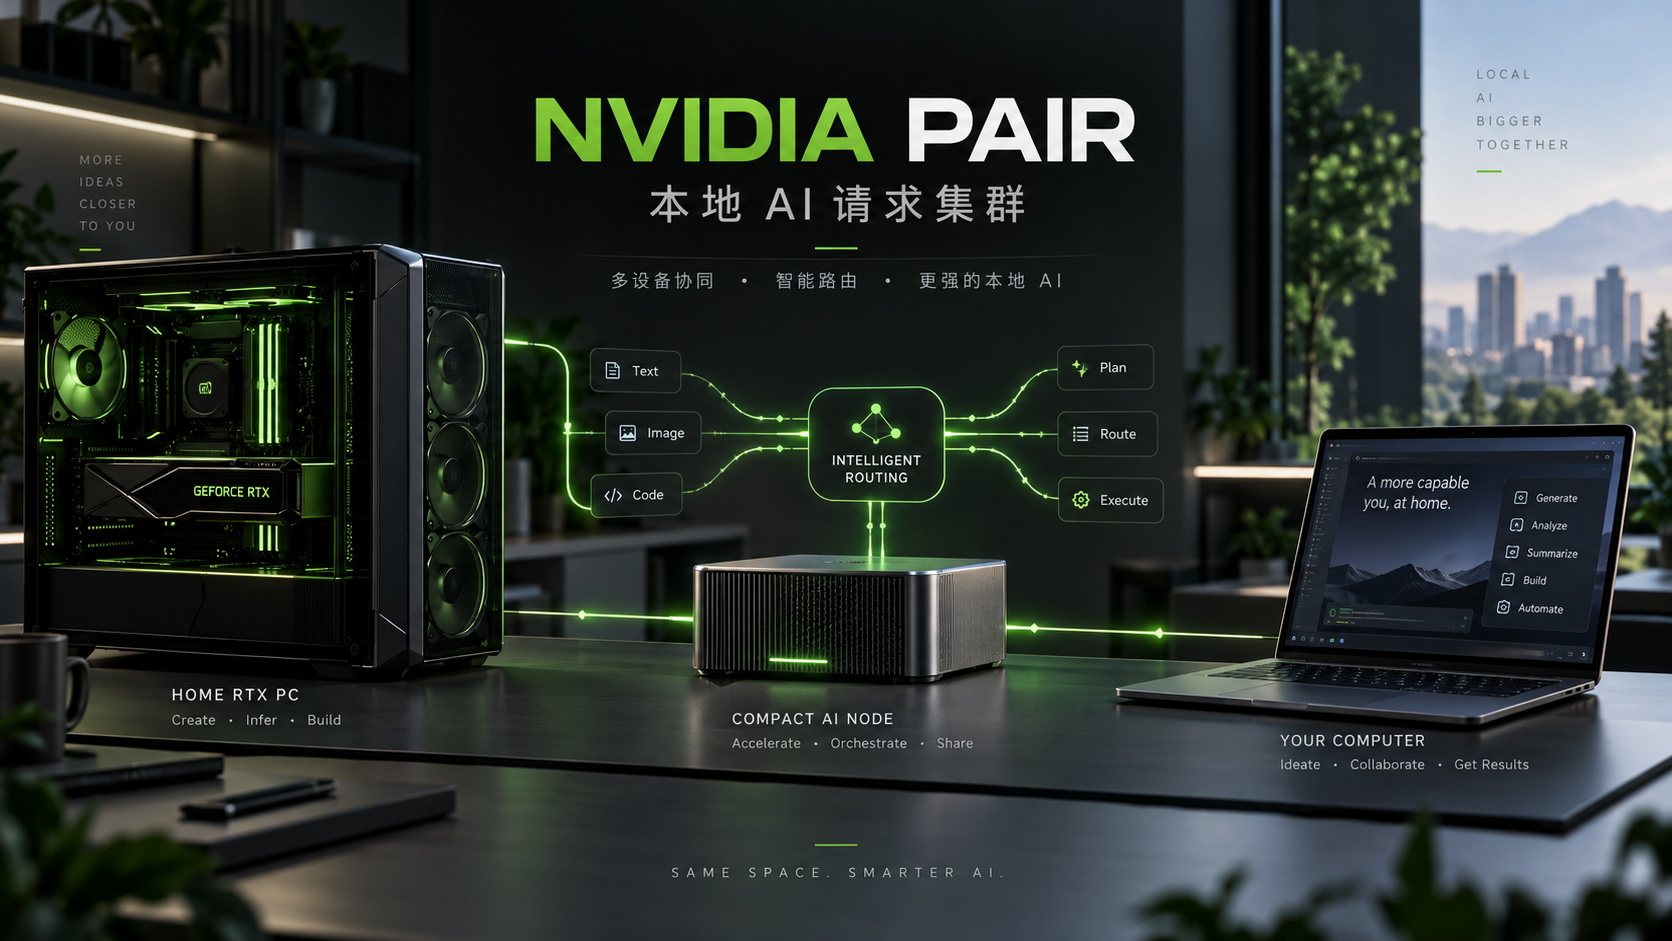 NVIDIA PAIR:把家里的 RTX、DGX Spark 和 Mac 变成本地 AI 请求集群,但它不是“显存池化”
可以把 NVIDIA PAIR 理解成家里本地 AI 的“派单前台”:RTX 主机、DGX Spark、Mac 就像几名能力不同的员工,PAIR 看谁在线、谁装了对应模型、谁现在最空闲,就把下一份 AI 工作交给谁。它特别适合多 Agent 并发,但不会把 16GB + 24GB 显存拼成 40GB,也不会把一个大模型拆到多台机器上。