
Apple 发布 Platform 27 设计套件:Liquid Glass 与完整组件状态进入 Figma 和 Sketch
Apple 为 iOS 27、iPadOS 27 与 macOS 27 更新官方 Figma、Sketch 和图标资源,把 Liquid Glass、更多组件状态、代码对齐命名与深色模式带入设计交付链。

Apple 在 2026 年 7 月 7 日更新开发者设计资源,为 iOS 27、iPadOS 27 和 macOS 27 提供新的 Figma 与 Sketch 套件,并把 Liquid Glass、更多组件状态、代码对齐命名和响应式缩放带入交付文件。这不是一款新的 AI 设计 Agent,而是一组能减少设计与实现偏差的官方生产资料。
Platform 27 设计套件进入 Figma 和 Sketch
iOS 与 iPadOS 27 提供 Figma、Sketch UI Kit 和 App Icon Template;图标模板还提供 Photoshop 与 Illustrator 格式。macOS 27 同样提供 Figma、Sketch UI Kit。Apple 7 月开发者更新
官方资源同时覆盖设计工具和图标生产工具,意味着团队可以从界面结构、组件状态一路衔接到应用图标,而不是只下载一张视觉规范 PDF。
Liquid Glass、组件状态和命名体系具体改了什么
Apple 公告列出的更新包括 Liquid Glass、扩展的组件与状态、与代码更一致的命名、改进的 resizing,以及 macOS 深色模式。Apple Developer News
对设计系统团队来说,“更多状态”往往比新视觉本身更有价值。按钮、导航、输入、浮层和窗口如果只画默认态,开发阶段就会用猜测补齐 hover、disabled、selected、loading 和错误状态。官方套件把这些状态放进源文件,可以降低前期遗漏。
命名与代码对齐也有直接工程意义:设计变量、组件名称和平台 API 概念越接近,设计稿到实现的映射越少依赖口头翻译。不过,这并不保证团队自有组件会自动兼容;仍需建立自己的 token 和组件适配层。
iOS、iPadOS 与 macOS 的资源并不完全相同
iOS/iPadOS 套件同时提供 UI 与 App Icon 模板,macOS 套件强调桌面组件、窗口与深色模式。跨平台产品不应把一份移动端文件简单拉伸到桌面,也不应只因为视觉语言一致就忽略输入方式、窗口层级和信息密度差异。Apple Design Resources
更稳妥的做法是先用官方资源定义平台原生层,再把品牌 token 和业务组件叠加其上。这样既保持品牌一致,也不会抹掉平台交互习惯。
从 UI Kit 到 App Icon Template 的交付链
新的 App Icon Template 覆盖 Figma、Sketch、Photoshop 和 Illustrator,让设计团队可以选择熟悉工具制作基础资产,再按平台要求输出。官方资源页还提供 Icon Composer,帮助处理图标层级、材质与不同外观。Apple Design Resources
这条链路仍需要真实设备检查:图标在不同尺寸、壁纸、深浅模式和辅助功能设置下可能出现对比度或识别问题。模板能保证结构起点,不会替你完成品牌辨识和可读性决策。
SF Symbols 8 与 Icon Composer 衔接系统图标生产
Apple 设计资源页列出 SF Symbols 8 beta。官方介绍其包含 7000 多个符号、9 种字重和 3 种比例,并支持多层动画与多语言阅读方向。Apple Design Resources
对于产品团队,SF Symbols 适合系统动作和常见对象;品牌图标、复杂业务概念仍需自定义。使用时还要检查平台版本、符号可用性和 Apple 的使用规则,不能因为文件可下载就把所有符号用于任意营销场景。
官方资源能减少误差,但不能替代 HIG 与真机验证
官方 UI Kit 能减少尺寸、状态、命名和视觉语言偏差,却不能替代最新 Human Interface Guidelines、可访问性检查、工程组件实现和真机测试。设计套件也会随平台 beta 与正式版继续更新,团队应记录下载日期与版本。
更实用的落地方式是:先在一个核心流程中替换底层组件,建立设计 token 映射,交给工程实现,再用真机和辅助功能设置核对。不要在没有验证交互成本的情况下,把全产品一次性改成 Liquid Glass。
这次更新的价值不在“又有一套漂亮模板”,而在 Apple 把设计、图标和工程命名之间的交付接口做得更完整。对跨设计与开发团队,它是一份应进入版本管理和组件审查流程的上游依赖。
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 17GB对100GB:Qwen3.8-27B与Flash-Next做同一批任务,省下的容量换来了什么?
同做89项终端任务,17GB的27B首轮完成35项,100GB的Flash-Next完成45项;最多两次是46对53,最多四次是48对60。本文追到9月13日后续结果,区分模型能力、环境故障和返工时间;测试为苹果MLX四位量化,不是GSQ-RCO IQ3_S,也不能套到16GB显卡。
 Qwen3.8-Flash-Next每秒70词元?本地加速之前,先看模型究竟改了什么
同样叫Flash-Next,70词元/秒背后可能是另一条计算路径:每词元激活专家从10减到5,再训练共享专家补偿。本文对照单台DGX Spark的两套原始资料,拆开量化、MTP、输入速度、输出速度和并发吞吐,不把128GB统一内存结果套到16GB显卡。
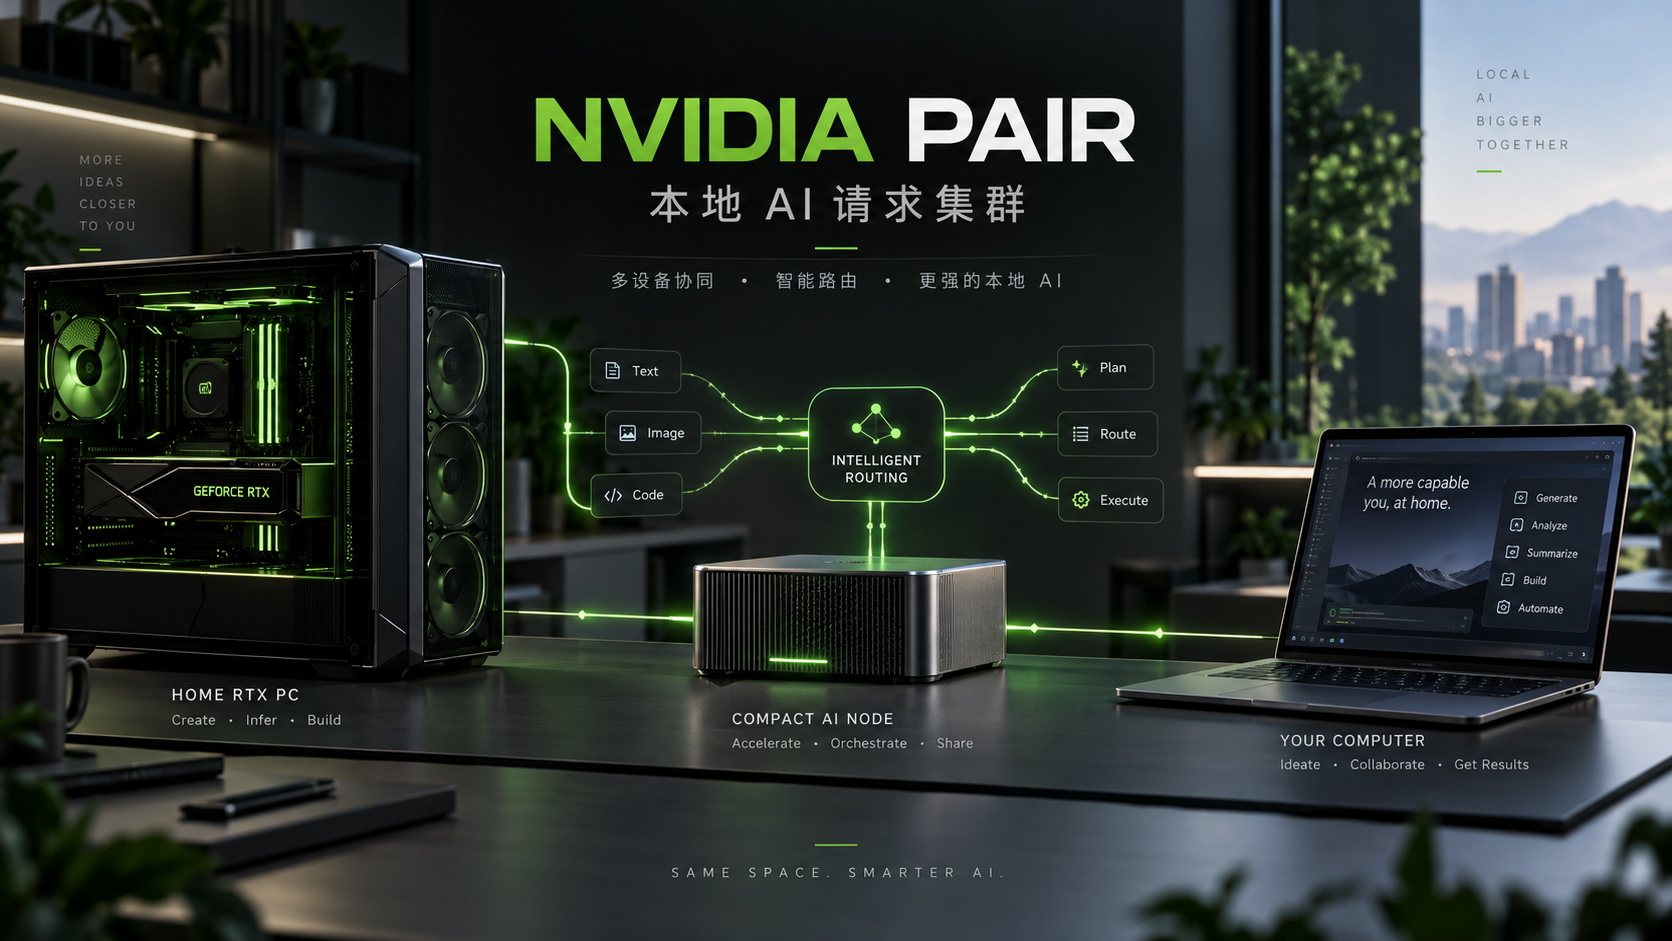 NVIDIA PAIR:把家里的 RTX、DGX Spark 和 Mac 变成本地 AI 请求集群,但它不是“显存池化”
可以把 NVIDIA PAIR 理解成家里本地 AI 的“派单前台”:RTX 主机、DGX Spark、Mac 就像几名能力不同的员工,PAIR 看谁在线、谁装了对应模型、谁现在最空闲,就把下一份 AI 工作交给谁。它特别适合多 Agent 并发,但不会把 16GB + 24GB 显存拼成 40GB,也不会把一个大模型拆到多台机器上。