
Anthropic 巨额融资推高 AI 基础设施竞赛强度
Anthropic 宣布新一轮大规模融资,高估值背后是模型、算力、企业 Agent 和安全能力的长期投入。

Anthropic 完成 650 亿美元 Series H 融资,算力和企业产品继续扩张
Anthropic 在 2026 年 5 月 28 日宣布完成 650 亿美元 Series H 融资,投后估值达到 9650 亿美元。本轮融资由 Altimeter Capital、Dragoneer、Greenoaks 和 Sequoia Capital 领投,Capital Group、Coatue、D1 Capital Partners、GIC、ICONIQ、XN 等共同参与。
Anthropic 在公告中表示,自 2 月 Series G 以来,Claude 在全球企业客户中的采用继续增长,公司 run-rate revenue 在当月早些时候超过 470 亿美元。本轮资金将用于推进安全和可解释性研究、扩展算力以满足 Claude 增长需求,并扩大客户依赖的产品和伙伴关系。
融资用途集中在研究、算力和产品生态
Anthropic 对资金用途的描述很明确:安全和 interpretability research、compute expansion,以及产品和 partnerships 的规模化。这三项正好对应前沿 AI 公司当前的主要成本结构。
模型能力要继续提升,需要长期研究投入;Claude Code、Cowork、企业集成和多平台部署需要产品化投入;而所有这些能力最终都依赖大规模算力和供应链支持。
Anthropic CFO Krishna Rao 在公告中表示,Claude Code 和 Cowork 等工具正变得更有用、更强大,也更能适应客户需求;新资金将帮助公司满足历史性需求,保持研究前沿,并把 Claude 带到更多工作发生的地方。
算力扩张是公告中的核心线索
相比普通融资公告,Anthropic 这篇特别强调了算力和基础设施合作。公司称,融资中包括来自 hyperscalers 的 150 亿美元此前承诺投资,其中包括来自 Amazon 的 50 亿美元。
Anthropic 还提到,Micron、Samsung 和 SK hynix 等战略基础设施伙伴加入本轮投资。这些公司在内存、存储和逻辑芯片供应中扮演重要角色。随着 Claude 需求增长,Anthropic 认为这些关系有助于可靠扩展 compute。
公告还列出近期算力协议:与 Amazon 签署最高 5GW 新容量协议;与 Google 和 Broadcom 签署 5GW 下一代 TPU 容量协议;与 SpaceX 达成使用 Colossus 1 和 Colossus 2 GPU 容量的协议。Anthropic 同时强调,Claude 是首个可在 AWS、Google Cloud 和 Microsoft Azure 三大云平台上使用的前沿模型。
企业采用是估值背后的另一个支撑
Anthropic 在公告中多次提到企业客户和复杂工作流。投资人引用也集中在 Claude 进入全球企业、Startups 和 Global 5000 公司部署 Claude 处理复杂工作流,以及 Claude 学习企业如何运转这些方向。
这说明本轮融资的叙事不只是“模型公司估值上升”,而是 Anthropic 试图证明 Claude 已经进入企业核心运营,并且需求足以支撑更大规模算力和产品投入。
对外部观察者来说,真正值得看的是资金会流向哪些能力:模型训练、推理容量、Claude Code、Cowork、企业产品、云平台合作、安全研究和可解释性研究。估值数字很高,但更能影响用户体验的是这些投入能否转化为更稳定的模型、更低延迟、更强企业集成和更可控的 Agent 工作流。
这次融资反映的是前沿 AI 的基础设施竞赛
Anthropic 这轮融资把 AI 竞争的底层逻辑显示得很清楚:前沿模型不只是算法和产品竞争,也越来越是算力、云平台、芯片供应、企业渠道和安全研究的综合竞争。
当 Claude 同时出现在 AWS、Google Cloud 和 Microsoft Azure,且公司与 Amazon、Google/Broadcom、SpaceX 以及内存芯片供应链企业建立关系时,Anthropic 已经不是单纯训练一个模型,而是在扩展完整的 AI 基础设施网络。
对企业用户来说,这类融资本身不是直接产品功能,但它会影响后续 Claude 的可用性、容量、交付速度、模型迭代和生态合作能力。后续更值得关注的是:这些算力和资金是否能换来更稳定的企业级服务,以及 Claude Code、Cowork、Claude Security 等产品能否承接更大规模真实工作流。
参考来源
本文为公开资料整理与技术学习参考,不提供采编、转载或发布服务。
 17GB对100GB:Qwen3.8-27B与Flash-Next做同一批任务,省下的容量换来了什么?
同做89项终端任务,17GB的27B首轮完成35项,100GB的Flash-Next完成45项;最多两次是46对53,最多四次是48对60。本文追到9月13日后续结果,区分模型能力、环境故障和返工时间;测试为苹果MLX四位量化,不是GSQ-RCO IQ3_S,也不能套到16GB显卡。
 Qwen3.8-Flash-Next每秒70词元?本地加速之前,先看模型究竟改了什么
同样叫Flash-Next,70词元/秒背后可能是另一条计算路径:每词元激活专家从10减到5,再训练共享专家补偿。本文对照单台DGX Spark的两套原始资料,拆开量化、MTP、输入速度、输出速度和并发吞吐,不把128GB统一内存结果套到16GB显卡。
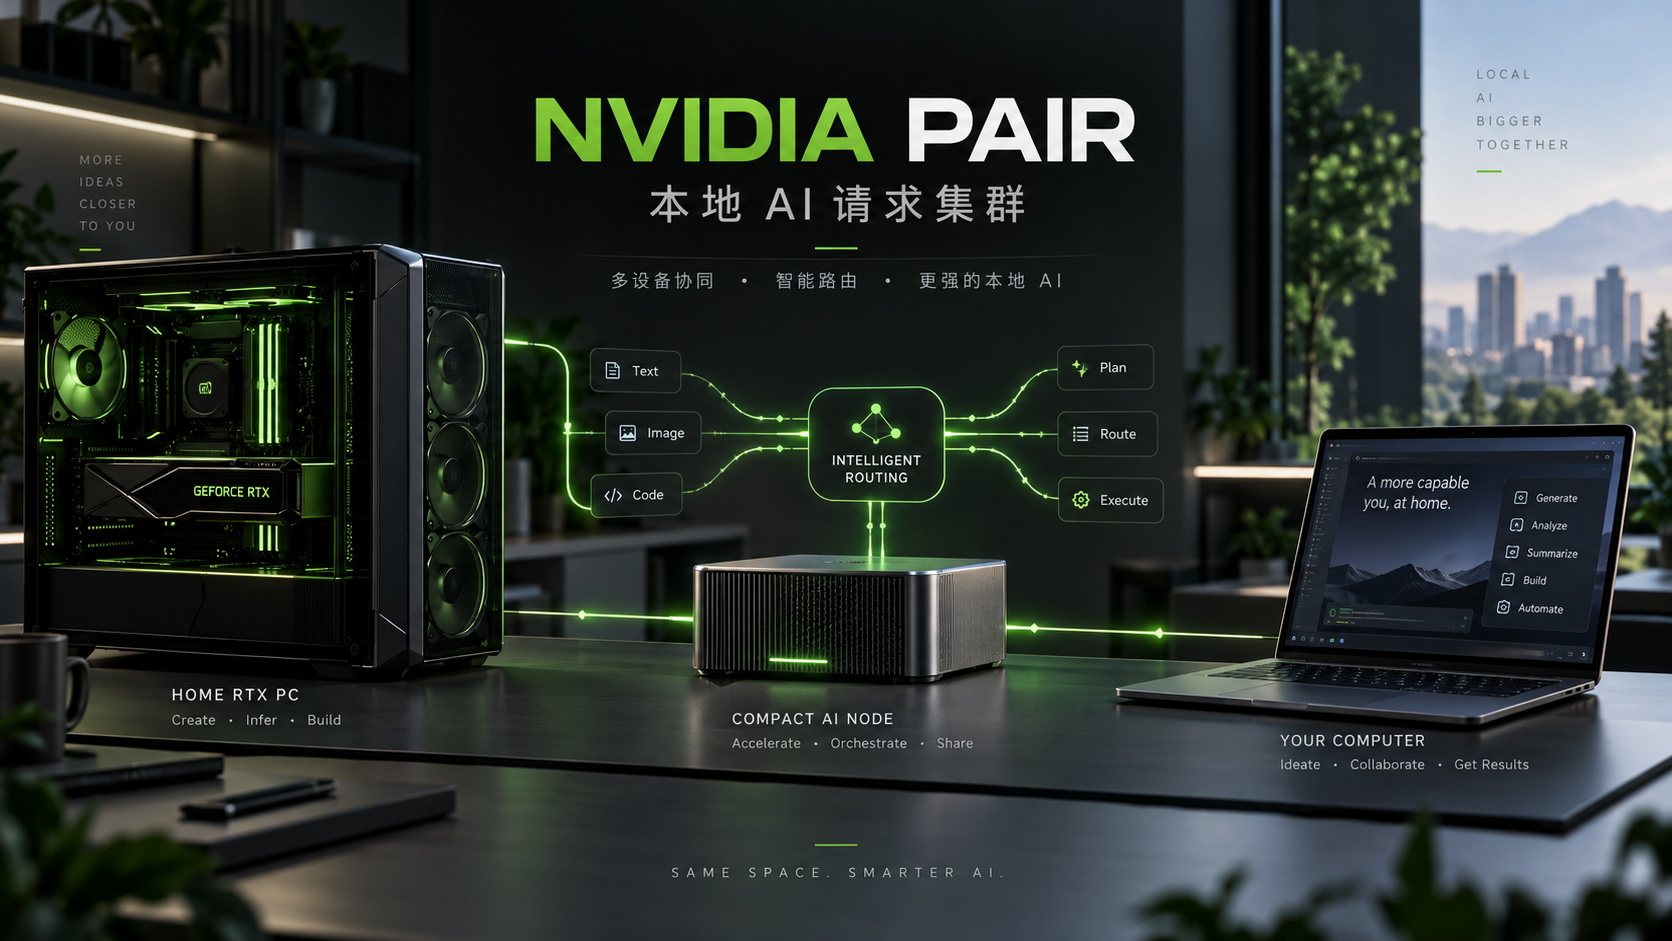 NVIDIA PAIR:把家里的 RTX、DGX Spark 和 Mac 变成本地 AI 请求集群,但它不是“显存池化”
可以把 NVIDIA PAIR 理解成家里本地 AI 的“派单前台”:RTX 主机、DGX Spark、Mac 就像几名能力不同的员工,PAIR 看谁在线、谁装了对应模型、谁现在最空闲,就把下一份 AI 工作交给谁。它特别适合多 Agent 并发,但不会把 16GB + 24GB 显存拼成 40GB,也不会把一个大模型拆到多台机器上。